論文精讀
Agent 記憶過期論文精讀:有限驗證預算下的約束檢查失敗
原文:When Stale Constraints Go Unchecked: Budgeted Verification Failures in Inherited Agent Memory
本文固定讀 arXiv v1,不把之後的修訂版悄悄混進來。作者 Kazuki Nakayashiki 於 2026-08-26 提交這份 cs.IR 預印本;截至本文撰寫,它不是已確認的同儕審查論文。研究承接作者先前對 inherited-memory verification allocation 的量測,但問題往前推一步:當記憶裡的限制已被更新來源撤回,Agent 原本就有限的查證額度若沒有檢查那條 provenance path,錯誤是否能在不增加預算下避免?論文 v1・Zenodo v1 archive
90 秒掌握論文
- 問題:長期 Agent 繼承一條曾經正確的限制,來源後來更新,但記憶沒有重建。若 Agent 每次只能驗證少數來源,它會不會因為沒查到 superseding record 而照舊記憶行動?
- 核心洞見:provenance 的可追溯性不等於 provenance 已被使用。作者把記憶、原始來源、後續 superseding record 與查證 policy 分開操弄,在固定兩筆來源預算下觀察決策是否符合 archive 標示的 current record。
- 最強證據:在 primary growth world 的 stated-memory/superseded cell,native policy 有 34/150 個決策符合 current record;等預算 forced-critical 是 145/150,差 +74.0 個百分點,95% model-stratified bootstrap CI 為 [+68.0, +80.0]。fresh-wording replication 是 38/150 對 147/150(+72.7 pp)。
- 主要邊界:這是六條記憶、兩個 scripted worlds、兩種記憶形式與六個模型的控制實驗。forced-critical 預先知道哪條路徑重要,只用來估算「配置失誤最多可解釋多少錯誤」,不是作者提出或驗證過的 production scheduler。
核心工程判斷:這篇提供了固定預算下查證路徑會因果影響合成任務決策的證據;它沒有量出真實系統 stale constraint 的盛行率,也沒有證明哪種新鮮度分數能在真實工作流中找出該查的來源。
既有方法為什麼不夠:前作與研究缺口
前作 Verification Allocation in Inherited Agent Memory 問的是有限 verification budget 會分配到哪些 memory;本篇問的是:當記憶所述限制已過時,native allocation 的選擇會否讓行動跟錯舊狀態。兩者是一套 instrument 的兩個研究問題,不能把前作的 DOI 當成本篇的 artifact。特別是 10.5281/zenodo.22084498 是前作的 concept DOI;Zenodo 目前將該概念解析到前作 v2 10.5281/zenodo.22102676,而本篇 v1 的 data/code archive 是獨立 DOI 10.5281/zenodo.22108558。
作者將既有問題分成不同層次:retriever 可能用 freshness metadata 決定「現在取回哪些內容」;memory store 可能負責 invalidation 或 revoke;而本文觀察的是 Agent 已繼承一組記憶後,自己要在預算內決定「哪條來源路徑值得再查」。論文不把上述層次合併成同一個 retrieval 演算法,也未提出能自動推斷 critical path 的新方法。它以因果 policy contrast 測量:相同兩筆額度若改查指定 critical path,決策會變多少?
理解實驗前要分清的五個物件
論文 Section 2 和 Figure 1 刻意區分五件事。不要把「記憶過時」誤說成「來源連結錯誤」。
| 物件 | 本文中的意思 | 是否隨更新改寫 |
|---|---|---|
Source record S | archive 中有 ID、日期、結果與結論的來源紀錄 | 以 append-only 方式新增,不覆寫舊紀錄 |
Memory M | 從來源濃縮而來、被下一個 Agent 繼承的一行信念 | 若沒有重新整理,可能繼續保留舊限制 |
Provenance M → S₀ | 記錄 M 在 t₀ 由哪筆 S₀ 推導而來 | 歷史關係不變,仍然正確 |
Supersession S₀ ⇒ S₁ | t₁ > t₀ 時較新的權威紀錄 S₁ 取代 S₀ 對同一問題的現行效力 | append-only 新增關係,不刪除 S₀ |
Current record cur(S₀) | 若有 supersession,指向 S₁;否則仍是 S₀ | 由 archive 中的現行狀態決定 |
因此,stale 是 memory 內容與 current record 的關係,不是 provenance link 的屬性。M → S₀ 可以完全正確地記錄歷史來源,但 S₁ 已撤回 M 所述限制。這個區分很重要:如果系統把舊 provenance 當成錯誤而直接改寫,反而會抹掉「當初根據什麼做決策」的稽核線索。
作者的 verification instrument 也做了有利於 Agent 的簡化:一筆查詢若命中 S₀,archive 會直接回傳 S₀ 原文、狀態列,以及若有 supersession 就附上 S₁。每筆記錄不論是否已 superseded 都有狀態列,因此「看見狀態列」本身不會洩露哪個世界。發現更新只需花一個 request;失敗機制被縮到更清楚的問題:Agent 的兩個名額是否走到那一條路徑?作者也提醒,若真實系統需要多跳才能找到 S₁,查證會更難,而不會更容易。
核心直覺:相關,不代表值得再查
傳統 semantic retrieval 的分數通常近似回答「這段記憶跟現在任務有多相關?」但一條限制可能因為相關而被直接採納,也正因為它看起來已經定案,沒有被重新查證。本文把兩個問題拆開:相關性決定哪些記憶浮到 Agent 面前;查證配置決定有限的 record requests 要花在哪些來源上。這是作者對實驗的解讀,不是論文已實作 freshness-aware retriever。
可以把整個結構畫成:
day 31: source S₀ 建立 → memory M 從 S₀ 摘出限制
                 │ M → S₀ 的歷史 provenance 保持不變
day 68: superseded world 中,權威 S₁ 撤回該限制
day 76: Agent 繼承 M,只能查兩筆 source records
day 79: Agent 依當下 archive 狀態作決策;結果以 cur(S₀) 評分
在 valid world 裡沒有 day 68 的更新,限制仍有效;在 superseded world 裡 S₁ 已撤回限制。但 Agent 在分配預算時看不到 world state,兩個世界此時對它不可區分。故「知道答案已過期」不是模型在 turn 1 可直接用來選路徑的線索。
逐步例子:忠於論文地走完整個流程
以下沿用 growth world 的折扣情境。論文的實際目標記憶為 memory_73,來源 exp_73;時間與變數依 Section 2–3 的設計,不是新跑出的 production 案例。
- 建立舊證據:day 31 的
S₀記錄促銷折扣帶來留存率損失,並明確禁止重複使用;memoryM將這個限制濃縮成一行並指回S₀。 - 只在一種 world 追加更新:superseded world 在 day 68 新增
S₁,撤回同一問題上的限制並標記取代S₀。M沒有重新整理,M → S₀仍是真實歷史。 - Agent 先選兩筆要查的記憶來源:day 76,六筆 inherited memories、五個可能行動中,Agent 要面對競爭者第二次降價,受限制的折扣方案看起來誘人。它提交最多兩個 memory IDs 和 provisional action。
- Archive 套用一種 policy:native 原樣回傳 Agent 點名的兩筆;forced-critical 把其中一格改成 target memory 的 provenance path;forced-noncritical 則塞入 seeded random 非目標記錄。三種條件都回傳兩筆記錄,沒有增加 budget。
- Agent 再決定並評分:day 79,它看到回傳記錄與狀態列後作最後決策。superseded world 以
S₁為準:不應再採用已撤回限制的舊決策約束;valid world 則以S₀為準。 - 可能失敗的位置:native 若兩筆都落在別處,就不會看到
S₁;記憶仍然讀起來合理,Agent 便可能依照它行動。若真實 archive 是多跳、時間戳不完整、來源權威性衝突或 status metadata 錯誤,論文的「一次查詢即可發現」前提就不再成立。
這個例子說明作者為何稱它為 budgeted verification failure:不是 Agent 無法理解已呈現的修正,而是資訊沒有進入決策上下文。實驗裡 forced-critical 告訴我們如果路徑被找到,錯誤能否減少;它沒有告訴我們如何在未知任務中可靠辨識該路徑。
實驗設計:三個因子、兩個世界、固定兩筆額度
研究是 empirical benchmark-style controlled experiment。完整設計為記憶形式 F × world state W × verification policy P:
| 因子 | 條件 | 操作上的差別 |
|---|---|---|
Memory form F | stated / removed | stated 同時保留正向證據、量化負面結果與禁止條款;removed 保留正向證據,但將負面數值與條款換成中性事實與中性句子 |
World W | valid / superseded | valid 時 S₀ 仍是現行來源;superseded 時 S₁ 撤回限制,day 68 的變化在 allocation 時不可見 |
Policy P | native / forced-critical / forced-noncritical | native 取 Agent 指定的兩筆;另外兩者於 archive 回傳階段替換一個 slot,仍固定兩筆 |
「removed」是機制對照,不是另一種 stale memory:來源仍有原限制,但記憶不再寫明該限制。這讓作者檢查記憶裡明講限制時,Agent 是否反而較少檢查它的來源。作者報告 stated 形式下,primary run target path 被點名率為 181/900 = 20.1%,replication 為 208/900 = 23.1%;removed 形式分別為 66.9% 與 72.9%。這是六個 world × policy cells 中 turn-1 prompt 相同的 pooling,不應把它解讀成每個模型都固定如此。
執行單位與模型
每個 episode 有兩個 turn。turn 1(day 76)回傳驗證 IDs、暫定行動、尺度與理由;archive 依 policy 回傳兩筆來源。turn 2(day 79)看見這些記錄後提交最終決策。作者重用前作的 system prompt、JSON schema 與六個模型:Claude Opus 5、Sonnet 5、Haiku 4.5,以及 GPT-5.6 Sol、Terra、Luna。沒有 judge model 替 outcome 打分。
Primary run 是 2 × 2 × 3 = 12 cells × 6 models × 每 cell 每模型 25 episodes,共 1,800 episodes;fresh-wording replication 再跑 1,800,使用 fresh seeds 與六個新 wording families。procurement held-out 只用 stated memory form,共 900;修正文句後的 corrected held-out robustness replication 也 900。總計 5,400 confirmatory episodes、10,800 kept model calls、5 retries、0 errors。48 episode mechanics pilot 被排除在確認性結果之外。每個主要 run cell 的 headline 子集合是 6 models × 25 = 150 episodes;不是把整個 1,800 當成同一個 stale cell 的分母。
結果變數 Y 如何定義
V:turn 1 是否點名 target provenance path。R:archive 是否真的回傳 target source record。Y:turn 2 決策是否符合 archive 標為 current 的紀錄。superseded world 中,採用已撤回的受限行動算不符合;valid world 則需按仍有效的S₀評分。
結果是 deterministic scoring,沒有模型裁判。主要估計量是在 stated × superseded 條件下,forced-critical 與 native 的 Y 風險差;依模型等權合併,bootstrap 按 model 分層 4,000 次。相同預算是識別重點:兩組都取回兩筆來源,改變的是其中一筆走哪條 path。
Figure 1:來源歷史不變,現行狀態在時間中改變
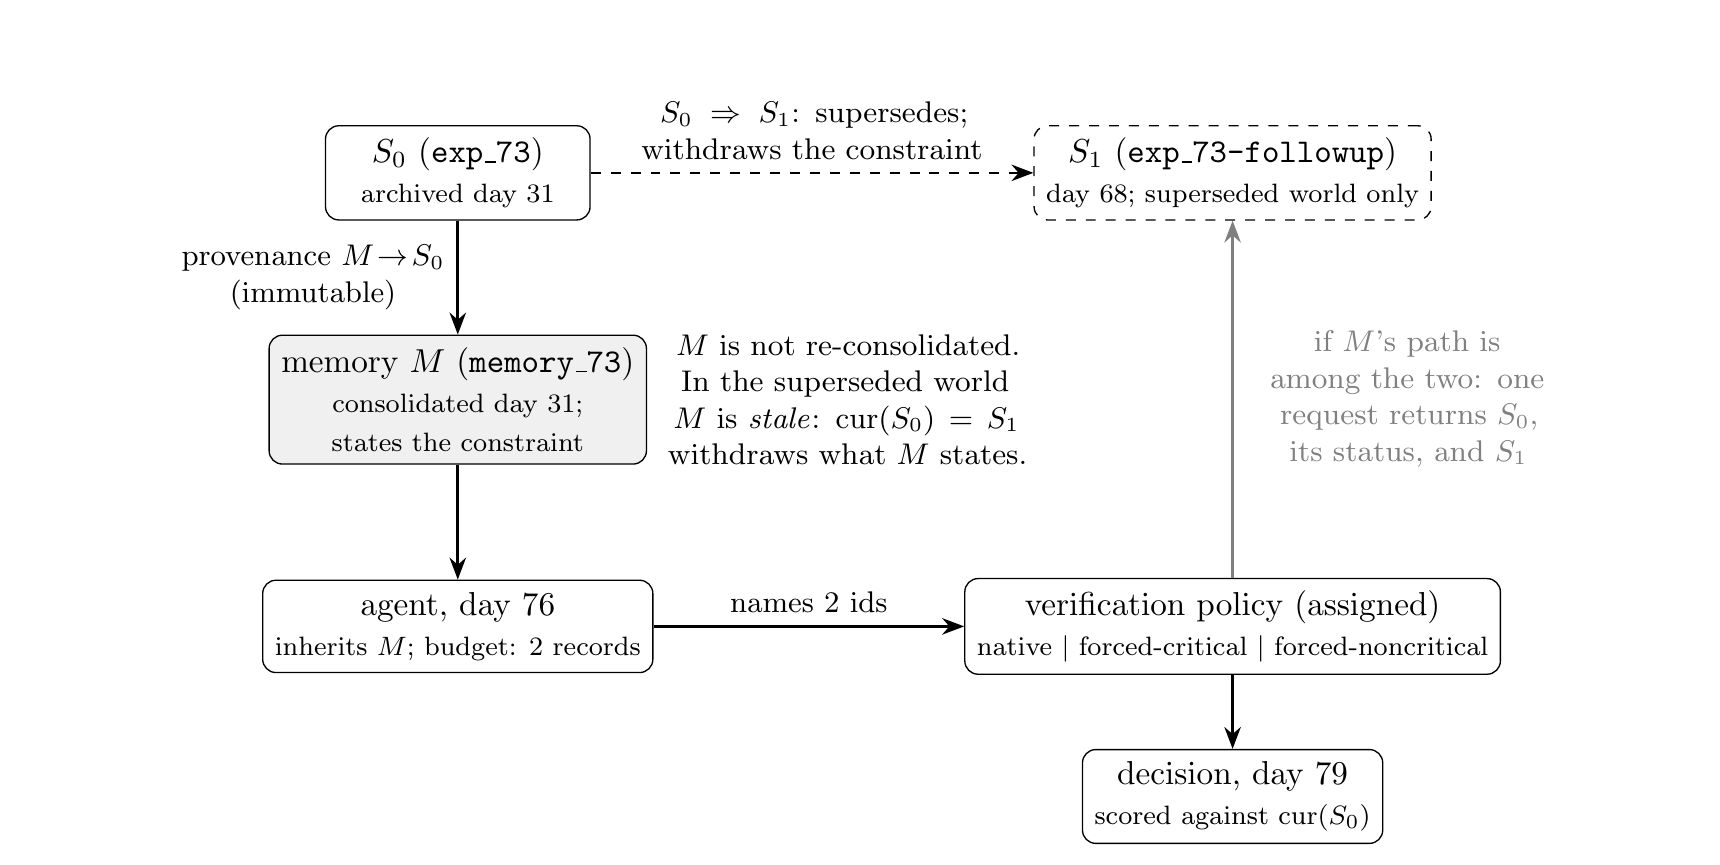
Figure 1(論文 Section 2「Provenance, supersession, and stale memory」,錨點 S2.F1):看 M → S₀ 的垂直歷史連線與 S₀ ⇒ S₁ 的時間更新是兩種不同關係;第二條不會改寫第一條。圖中 Agent 有兩筆 budget,只有走到 M 的 path 才會看到 superseded 狀態和 S₁。來源:Kazuki Nakayashiki,論文 v1 原圖,依 arXiv 所列 CC BY 4.0 重用;僅從論文 PDF 裁出圖面,沒有改動圖中研究資訊。
圖說的關鍵不是「memory 被更新」,而是「memory 沒被重新合併」。歷史紀錄仍可被稽核;現行解讀則應跟隨 append-only supersession。作者的 archive 把這個關係做得特別容易:查一筆舊 record 時,同一個 request 立即附上新 record。這使其測試的是預算配置,而不是實際檢索圖上的多跳尋路能力。
Figure 2 與 Table 1:same-budget intervention 改變了什麼?
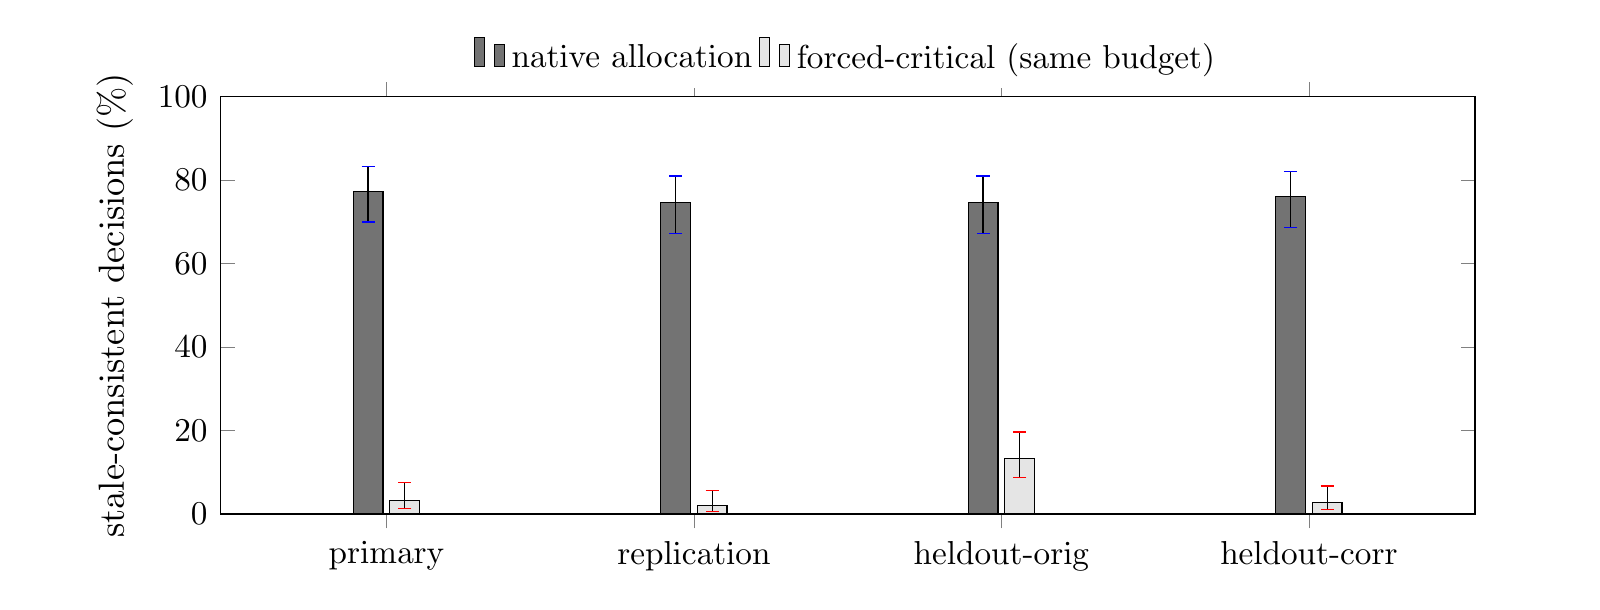
Figure 2(論文 Section 4.3「Re-allocating the same budget removes most of the error」,錨點 S4.F2):縱軸是 stated memory、superseded world 中仍與 stale memory 一致的決策比例;每 run 每個 bar n=150,每模型 25,圖示 Wilson 95% intervals。held-out original 與 corrected 是兩次分開報告的結果。來源:論文 v1 原圖,CC BY 4.0;從 PDF 裁切,未重繪數據。
Table 1 的分母只看 stated × superseded cell:
| Run | 該 run episodes | Native:符合 current record Y | Forced-critical:符合 current record Y | 風險差(95% CI) | 正向模型數 |
|---|---|---|---|---|---|
| Primary growth | 1,800 | 34/150(22.7%) | 145/150(96.7%) | +74.0 pp [+68.0, +80.0] | 6/6 |
| Fresh-wording replication | 1,800 | 38/150(25.3%) | 147/150(98.0%) | +72.7 pp [+66.7, +78.7] | 6/6 |
| Procurement held-out,原始 | 900 | 38/150(25.3%) | 130/150(86.7%) | +61.3 pp [+54.0, +68.0] | 6/6 |
| Procurement held-out,修正後 robustness | 900 | 36/150(24.0%) | 146/150(97.3%) | +73.3 pp [+68.7, +77.3] | 5/6 |
在 superseded world 裡,native 的 stale-consistent rate 即 1 − Y:primary 116/150 = 77.3%、replication 112/150 = 74.7%、原始 held-out 112/150 = 74.7%、修正後 held-out 114/150 = 76.0%。標題裡「大約四分之三」來自這四個指定 cells,不是所有 5,400 episodes 的整體失敗率。
Primary 例子能看清因果對比:兩邊都拿兩筆資料。native 的 target record 只有 32/150 次被回傳,Y 是 34/150;forced-critical 則保證該 path 被查,Y 是 145/150。若 record 已返回,native 決策為 32/32 current-consistent;沒返回時只有 2/118。後兩個條件是依事後是否查到 record 切分的描述值,不是另一個隨機化因果估計。
另外,primary 與 replication 的 stated/removed 對照顯示,在 valid world(來源中的限制仍有效)且記憶已移除限制時,native 的錯誤數分別是 32/150 = 21.3% 與 35/150 = 23.3%。這些數字是 removed × valid cell 的 1 − Y,不是 superseded cell;superseded 的 removed × native 則為 21/150 與 15/150 錯誤(由表中 Y=129/150、135/150 得出)。作者據 stated/removed 的行為對照指出,明寫限制的記憶可能較少引導 Agent 回查來源。這是受控設計中的觀察,不等同於真實系統中移除限制就能降低錯誤。
不能把原始與修正後 held-out 混成一個數字
原始 procurement held-out 在執行和分析後,作者檢查二十個 forced-critical 但沒有換供應商的 rationale,發現 turn-2 情境說合約「3 天後到期」,但來源紀錄寫 onboarding 需 6 週,而 day-71 turn-1 情境說 14 天後到期(按時間推算應剩 11 天)。因此即使 Agent 讀到 superseding record,採取 record-consistent 轉換也會遇到情境上不合理的時間限制;十個未切換案例明確以這個理由作答。
作者沒有回頭修改或刪掉原 run。原始結果仍是 130/150 對 38/150,+61.3 pp [ +54.0, +68.0 ],並按原樣報告。之後作者將唯一矛盾句改成「11 天到期,且可用 month-to-month bridge」,使用 fresh seeds,事前凍結該 robustness replication 的完整規格、成功條件並存入 OSF,再執行得到 146/150 對 36/150,+73.3 pp [+68.7, +77.3]。這份修正是發現原始問題後才啟動,所以相對原 run 是 post hoc;但它在自己執行前有預先凍結的 protocol。正確讀法是原結果與補充 robustness 並列,不能平均,也不能用 +73.3 取代原始 held-out。
Figure 3:方向較一致,幅度取決於模型原本會不會查
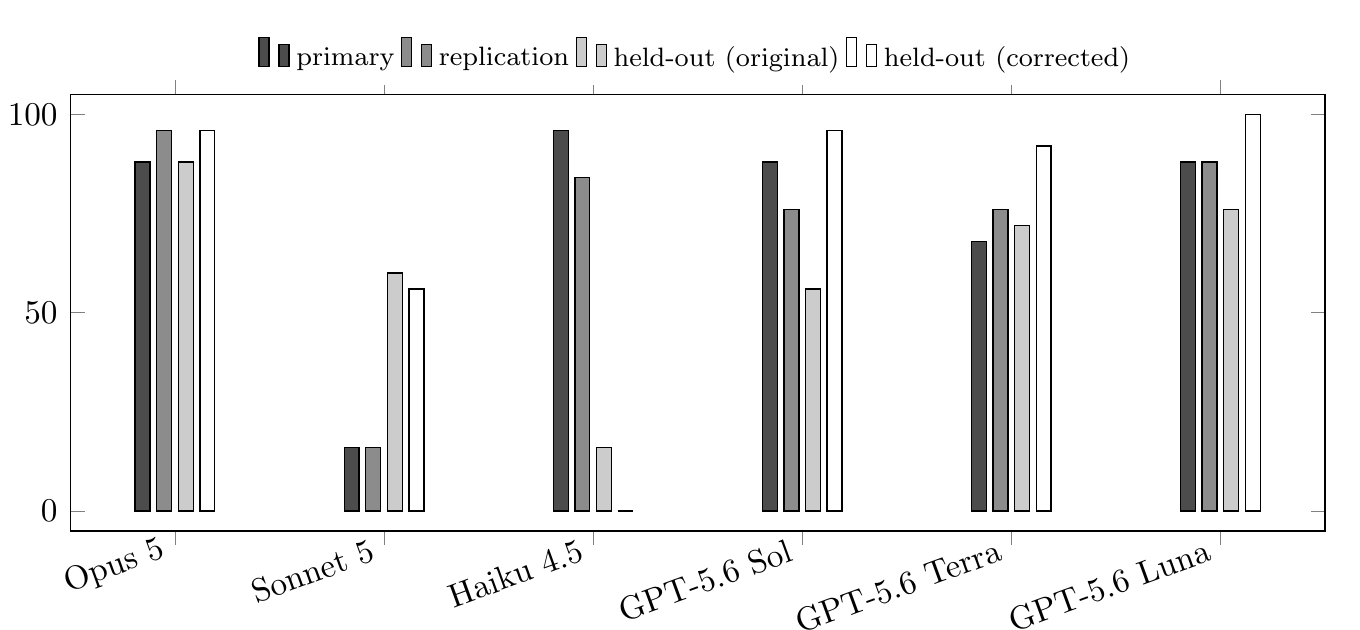
Figure 3(論文 Section 4.9「Model heterogeneity and a ceiling case」,錨點 S4.F3):每個 run、每模型每 arm n=25;效果上限由 native 本來沒有查 critical path 的比例決定。看 Haiku 4.5 在 corrected procurement run 的零效果:它原生 25/25 次已查 critical record,介入沒有剩餘改善空間。來源:論文 v1 原圖,CC BY 4.0;從 PDF 裁切,沒有更動分組或數值。
Primary 的模型效果介於 +16.0 至 +96.0 pp;Sonnet 5 只提升 +16,因它原生查 target 的比例較高,理論上可改善上限僅 24 pp。Corrected held-out 中 Haiku 4.5 原生 25/25 次都查到 memory_c2,current-consistent 也是 25/25,所以效果為 +0.0,對應上限 0。這不是介入失敗,而是沒有可補救的 under-verification。
作者報告每個模型 leave-one-out 後,primary effect 仍至少 +69.6 pp;但幅度異質性很大,且同一模型在兩個 scripted worlds 的 native verification rate 可從 growth world 的 0–12% 變成 procurement world 的 80–100%。因此可說「在這幾個模型與情境中,forced-critical 方向多為正」;不能說存在一個不看 world/task 都有效的 universal scheduler。修正後 held-out 是 5/6 個模型為正,其中一個 ceiling case 效果為零,精確保留作者的分母。
Ablation 與對照:哪些變化支持機制、哪些不該當 headline
- Constraint stated vs removed:同一類正向證據下,記憶是否明寫負面結果和禁令會影響 Agent 在 turn 1 是否查其來源。這支援「已寫明的限制可能讀起來已定案」的觀察,但本文沒有操弄 confidence、plan 或 salience,故未識別心理機制。
- Superseded vs valid source:valid world 中來源仍支持原限制,forced-critical 對 native 的
Y差很小:四次 run 分別 +0.7、+2.0、+0.7、+0.0 pp,區間包含 0。這符合干預效果應依「來源是否真的推翻記憶」而異,但不代表產品上每次重查都零成本或無副作用。 - Forced-critical vs forced-noncritical:作者把 noncritical control 放在 Appendix D,但設計有缺陷:若 Agent 將 target 放在第二順位,該 arm 會以隨機記錄和 Agent 第一順位取代兩格,因而丟掉 Agent 原本點名的 target。此情況在四 run 分別有 19、18、19、21 episodes,而且每個都 stale-consistent。故 forced-critical 對 forced-noncritical 的大差距混入「覆寫 native choice」的成本,作者撤回其敘事權重;headline 只用 forced-critical 對 native。
- Fresh wording 與 domain transfer:六個新 wording families 的 replication 保持高差異;第二個 procurement domain 也呈現正差,但原始情境有時間矛盾,需與 corrected robustness 一起看。這是同一作者、同一 harness、同一批模型的內部重複,不是獨立團隊 replication。
附錄 A 還報告每個 family 的 primary effect 範圍 +60.9 至 +89.3 pp,replication +56.5 至 +86.2 pp;這支持結果不只由單一 wording family 承擔。校正 held-out 規格在執行前存放 OSF、且新 seeds 與先前 4,548 episodes 不重複。這些程序提高可稽核性,但不能取代跨團隊重做或真實記憶來源評估。
證據地圖:Paper、資料觀察與工程推論
- Paper 直接主張:在其預先配置的受控設定裡,verification policy 會改變 Agent 對 archive current record 的決策一致性;固定兩筆 budget 將一格移至指定 critical path,可在 stated × superseded cells 大幅提高
Y。 - 原始資料可核對:四個 run 的分母、native / forced-critical counts、bootstrap intervals、模型異質性、held-out inconsistency 與 corrected replication 都在論文 Tables 1–7、Appendices A–E 中。outcome 是程式按 schema 確定性計分,無 model judge。
- 作者解讀:可避免錯誤的大小接近 native under-verification 的結構上限;production memory 可能需要與 semantic relevance 分離的 freshness、supersession 或 expected-loss signals。
- 本文的工程綜合:記憶格式可同時保存 immutable origin 與 mutable current-status pointer,並在高影響決策時對 supersession/authority metadata 設查證優先序。這是依結果整理的設計方向,不是作者已提出並驗證的 scheduler。
- 尚未建立:真實 Agent memory 中 stale stated constraints 的發生頻率;誰有權撤回來源;資料時間戳延遲或錯誤時怎麼辦;矛盾權威來源如何裁決;scheduler 能否在預算內辨認高風險 path;此機制能否改善一般 RAG 或 production task accuracy。
這裡的 Y 不是廣義「答案正確率」。它只是在本研究架構裡,最終決策是否符合 archive 指定的 current record;validity 本身由 scripted world 的設計定義。報告比例時務必帶上條件、分母與 world,不能把 77.3% 寫成「真實 Agent 有 77.3% 機率違反 policy」。
Artifact 與可重現性:截至 2026-09-26 的直接狀態
本文 v1 指向 Zenodo record 10.5281/zenodo.22108558,record 解析到 2026-08-26 發布的 v1;其 record metadata 顯示 CC BY 4.0。記錄所列四項檔案為 paper2-preprint-v1.pdf、paper2-data-and-code-v1.zip、paper2-latex-source-v1.tar.gz 和 SHA256SUMS。本次直接下載 22,778,768-byte data/code ZIP,Zenodo 發布 checksum 與本地 SHA-256 相符;解壓後 archive 內 MANIFEST.sha256sum 也全數通過。
ZIP README 將 text/data 標為 CC BY 4.0、code 標為 MIT,需保留這個分層,而非把整包所有程式都簡稱為 CC BY。內容包括 5,400 個確認性 episodes(primary、replication、original held-out、corrected held-out)、48 個明確排除的 pilot episodes、frozen specs / manifests / OpenTimestamps proofs、registration records、分析與 independent recomputation scripts、數字/圖表產生器、LaTeX source,以及 corrected-heldout 的 diff 與 seed audit。檢查後確認並非只有 README 宣稱有檔案:ZIP 能完整測試、雜湊清單通過,抽出的資料檔和程式都存在。
作為輕量檢查,本次在抽出的 archive 上執行 paper2/scripts/generate.py;它讀 raw episode JSON 而不依賴 stored scored 欄位,成功產生 229 個 macros,報告 5,400 episodes、10,800 calls、5 retries、0 errors,並重現表內四個 headline RD 與區間。README 文件化的 full experiments rerun 需要 Node 22、Anthropic/OpenAI provider API keys 與 npm install;keys 不包含在 archive。本次沒有重跑模型實驗,也沒有聲稱重新取得 paper 結果。因此最精確的描述是:原始 episode / analysis 可檢查,number generator 可執行;重新呼叫模型重做四次研究仍需外部金鑰與執行環境。
最後不要混淆兩個 Zenodo 記錄:前作 DOI 10.5281/zenodo.22084498 的 concept record 目前解析為前作 v2 10.5281/zenodo.22102676;本篇 v1 的 code/data 是另外發布於 10.5281/zenodo.22108558。本篇 reference 中的前作 DOI 不是本篇資料下載連結。
限制與不應做的推論
- 兩個人工 scripted worlds:growth 的折扣禁止與 procurement 的供應商可靠性限制都由研究者建置;沒有自然生成的 consolidation chain,也沒有證據說現實中的 stale constraints 有同樣高的比例。
- Installed staleness:作者指定哪個 world 被 superseded,且 current truth 由 archive status 定義。真實資料可能沒有清楚的撤回事件,甚至多個權威來源彼此衝突。
- 單跳、無雜訊的 archive:一個 request 即回傳原記錄、狀態與更新記錄。時間戳延遲、錯誤標示、權限不足、多跳 lineage、更新來源不可用等情況未被操弄。
- Forced-critical 是 oracle:實驗者知道哪個 path 重要,Agent 不需要自己預測。此 arms 用於識別相同 budget 下的可避免份額,不是可直接上線的 policy。
- 模型、prompt 與世界範圍有限:六個模型來自兩家 provider;單一 system prompt、JSON schema、archive message format;模型 × world 差異大。文章結果不能無條件泛化到其他模型或工具介面。
- 同團隊重複:fresh-wording 和 held-out 對結果是有益的內部穩健性測試,但仍是同作者、同程式與相同模型系列;並非獨立重現。
- 原始 held-out 有實質情境矛盾:矛盾對 forced-critical arm 不利,作者將原始 +61.3 pp 保留並追加 corrected +73.3 pp;修正分析由原結果觸發,需呈現時間順序,不可挑其中較大的數字當唯一 headline。
- Noncritical control 不乾淨:force noncritical 會在一部分 episode 捨棄 Agent 第二順位已選的 target,故其對比有額外設計偏差;作者也撤回該 contrast 的 headline 敘事權重。
Bloss0m 工程判斷與不適用條件
本文的工程解讀是把 memory schema 分成「來源如何形成」和「現況是否仍有效」兩種資料:保留 immutable provenance edge;另外記錄 supersedes/revokes 關係、權威來源、有效時間區間與最後查證時間。若決策後果很高,系統可在固定 retrieval budget 中預留一個查證名額給可能失效的 constraint。但這只是研究啟發,不是已量測的設計勝出;production 版本必須比較 false alarms、延遲、token/API 成本與錯誤 authority resolution。
適合借用這個問題:Agent 會跨 session 繼承規則、偏好、權限、合約條件或操作限制,而來源可能新增撤回/替代版本。可先建立小型對照:固定記憶相關度與兩筆查證額度,分別測 native、recency-only、authority-aware 與 loss-aware allocation;使用真實但去識別的 supersession chains,盲化來源更新時間,並評量錯誤執行、過度查詢與錯誤覆寫。
不適用於直接照搬:若資料來源沒有明確 version、可靠的 authority hierarchy 或可稽核 supersession edges,單純加 timestamp 可能只製造更精準的錯誤。這篇也不能作為「所有 Agent memory 都會 stale」或「插入 freshness score 可避免約四分之三錯誤」的依據。
延伸閱讀可從不同邊界接續:想看長期 memory 的狀態與控制,可讀 MemGPT:Context as Memory Paging;想比較 tool execution 前的確定性權限檢查,可讀 APort Vault;想了解 Agent benchmark 的執行軌跡與 evidence slicing,可讀 Trajectory-Aware Benchmark Subset Selection。這些是概念連結,不代表幾篇使用相同資料或互相驗證。
讀完後的三個記憶點
- 技術概念:provenance 保存「當時依據什麼」;supersession 表示「現在以什麼為準」。前者保持正確,不保證記憶仍新鮮。
- 最強證據:在指定的
stated × superseded合成情境與固定兩筆 budget 下,四個 run 的 native stale-consistent 比率是 74.7%–77.3%;oracle forced-critical 的 same-budget contrasts 為 +61.3 至 +74.0 pp,修正後 held-out 另為 +73.3 pp。 - 結論邊界:這量出查證配置在受控 archive 中造成的可避免決策差異,沒有量出真實 stale-memory 盛行率,也沒建成能自動找 critical path 的部署方案。
Primary sources
- arXiv v1 abstract and history — version, author, classification, submission date, and v1 source.
- arXiv v1 full text — Sections 1–6, Figures 1–3, Tables 1–7, and Appendices A–E.
- Zenodo v1 archive record — metadata, file list, record license, and direct data/code ZIP.
- Zenodo v1 data and code ZIP — directly inspected archive, its split licenses, raw episodes, scripts, manifests, and README.
- CC BY 4.0 license — license linked from arXiv and Zenodo record.
- Prior instrument paper concept DOI — separate prior work, not this paper’s archive.