論文精讀
Agent 回歸測試論文精讀:依執行軌跡挑選評測子集
原文:Trajectory-Aware Benchmark Subset Selection for Cost-Efficient Software Engineering Agent Regression Testing
本文讀 arXiv v1 完整論文 與作者連結的 swe-agent-subset-selection replication repository。v1 包含 Sections 1–9 與 References,未列出獨立 appendices;論文於 2026-09-21 提交,本文按 2026-09-24 可見的 v1 撰寫。它是預印本,不代表已同儕審查或正式定稿。這是 empirical benchmark/evaluation paper:作者沒有提出新的 agent,而是研究如何在開發期更便宜地估計軟體工程 agent 在完整 benchmark 上的 resolve rate。
90 秒掌握論文
- 問題:改模型、prompt 或 agent framework 後,團隊想知道回歸測試表現是否變好或變差;完整 SWE benchmark 對每次迭代太貴。隨機抽少量 issue 雖省執行成本,卻可能抽到偏難或偏易的子集,讓 resolve rate 估計不穩。
- 核心洞見:先依 agent 在過去完整 run 的 pass count 分層,固定子集中各難度層的比例;再只在每層內,以去除明確結果洩漏的過往 agent trajectory embedding 做幾何選樣。outcome strata 守住難度組成,embedding 幫忙挑行為較具代表性的實例。
- 最強證據:論文比較 76 種 subset-selection 配置,在三種回歸情境共 31,779 條 trajectory、58 runs、五個 framework 上做時間交叉驗證。10% Centroid Pooled 在 Multi-model 與 Multi-agent 的 median RMSE 為 0.0431 與 0.0400;成本實驗測得每次平均 token cost 約按樣本數比例縮減,10% 子集估計可由 3.44B 降至約 345M tokens。
- 主要邊界:這是 SWE-Rebench 與 SWE-Bench Verified 上的軟體修復 agent 回歸估計,不是任意 agent task 的縮小版 benchmark。多數結果在不同配置間不完全一致;過時軌跡、任務分布改變、清理不完全或跨任務 transfer 都可能使選樣失準。
核心工程判斷:這篇研究最有說服力的訊息不是「10% 永遠足夠」,而是隨機抽樣的不穩定性可以拆成兩個不同問題:保住歷史難度組成,再減少層內選樣的行為代表性誤差。作者的 trajectory signal 在特定 SWE regression 設定中提供增益,但全文也顯示結果依 subset size、run history 和 scenario 而變;小子集可作快速預警,不能取代定期 full evaluation。
既有方法為什麼不夠:子集要估計哪個 full-run 數字?
在 SWE-agent benchmark 中,每個 instance 通常是一個既有 repository 的 GitHub issue。agent 讀取程式碼、呼叫工具、修改檔案並測試,最後以 issue 是否解決計為 pass 或 fail。resolve rate 是成功 instance 的比例。開發者每次更新 agent 都想重新量一次,但一個 instance 會經過完整的 LLM 與工具循環,因此把全 benchmark 放進每個 CI iteration 會花掉大量時間與 token。
這篇論文的目標是:根據既有 full runs 建出固定子集,在未來 run 只跑該子集,再以子集 resolve rate 估計同一 benchmark 全體 instance 的 resolve rate。它不是要找「最快暴露新 bug 的測試排序」,也不是維持一組適合比較多個模型排名的靜態問題。作者關注單一 agent 在多次更新間的回歸訊號,因此 target quantity 是當次全套 benchmark 的 resolve rate。
單純隨機抽樣的問題不只是平均誤差。小子集可能偶然漏掉重要的難題行為,帶來長尾的大幅誤估。只看 repository 分布則把 repo identity 當 difficulty proxy,但同 repo issue 對 agent 可能差異極大。以歷史通過與否分層能先控制 outcome composition;然而同一 pass/fail 組仍可能包含不同的除錯、編輯、測試與錯誤處理方式。作者於是加入歷史 trajectory 作第二種訊號(Introduction Section 1;Background Section 2.2)。
核心直覺:先保留難度比例,再找層內的典型行為
歷史 pass count 與軌跡向量扮演不同角色。若某 benchmark 中 60% 的 issue 歷史上總是通過,子集也應大約保留該比例;不然子集 resolve rate 會偏向困難或容易題。接著,在同樣的 outcome 組內選擇 trajectory embedding 空間裡較典型的 instance,盡可能避免隨機抽樣偶然挑中一群相似但不具代表性的任務。
這個分解能說明常見替代方法為何有限:
- Uniform Random 不用歷史資訊,組成與層內挑選都靠抽籤。
- Repository Stratified 保留來源 repo 比例,但 repo 不等於 agent difficulty。
- Difficulty Stratified 用過去多數 run 的 easy/hard 二分法;Consistency Stratified 則按確切 pass 次數分組,能區分「常常通過」與「偶爾通過」的 instance。
- 純 trajectory clustering 找行為相似的群,但相似行為不保證相同 resolve probability,可能混合 easy 與 hard。
所以論文的主張是「outcome grouping + trajectory geometry」互補,不是 embedding 單獨取代傳統 outcome stratification(Approach Sections 4.3–4.4)。
用一個具體例子走完整個方法:從三次 full run 到未來估計
以下是依方法描述構造的解釋例子,不是額外實驗資料。想像 benchmark 有 1,000 個 issue,先前已完成三次相同 benchmark 的 full run,agent 分別解決每題 1 次、2 次或 3 次。
- 輸入:三份有時間先後的 full-run 結果,以及每題每次執行的 agent trajectory(思考記錄、工具動作和觀察)。
- 統一表示:解析不同 framework 的記錄形式,例如 OpenHands 扁平訊息序列、Moatless 搜尋樹,轉為共用 JSON 結構,保留 step、action、observation 等可比較欄位(Figure 3 / Section 4.1)。
- 去洩漏與向量化:移除或遮罩「tests passed」、exit code、repository/test harness token 等會讓模型直接猜 outcome 或 task identity 的線索;再把每一步的 sanitized action 與 observation 嵌入向量空間。
- 分組與選樣:按每題過去 0、1、2、3 次 pass 分四組,子集名額依原 benchmark 比例配置;在各組選擇距離該組 embedding centroid 最近的 issue,直到湊滿目標大小。
- 未來測試與誤差:模型或設定更新後,測試該 subset。把 subset resolve rate 與同一個未來 run 的 full-suite resolve rate 比較,量化估計誤差。若過去軌跡已不代表新 agent,或者 agent 行為大幅改變,這個 subset 仍可能漏掉新失敗模式;它必須以之後的 full run 更新。
這條路徑是 past full-run outcomes + sanitized trajectories → historical strata + embeddings → fixed subset → later unseen run → subset/full resolve-rate gap。資料洩漏清理是有效比較的前提,不是選樣後的附加美化。
方法機制:trajectory 如何被去洩漏與嵌入
四階段 trajectory sanitization
論文先把各 framework 的原始 log 解析為共同格式,再做四階段清理(Approach Section 4.2):
- 發現 corpus 特有噪音:掃描整體 token,利用字母/數字 pattern 找出 UUID、commit hash、隨機 seed、暫存路徑等近乎每次都變的識別碼;也找出高頻 boilerplate。研究者人工檢視一次候選 pattern,按 dataset 建 regex 規則。
- 偵測結果與身分洩漏:先明確找 outcome 詞、exit code、repository 名稱、repository 特定工具/字串,以及 test harness artifacts。前者可能直說 pass/fail,後者可能讓 embedding 依 repository 而非 agent 行為聚集。
- 清理與遮罩:移除通用 boilerplate 與明確洩漏詞;將 identifier 遮成具型別 placeholder(例如
[PATH]、[RANDOM_SEED]),保留「有路徑/隨機值」這一結構訊息,但消除其實際身分。 - 驗證清理效果:用 TF-IDF 加 logistic regression 檢查 outcome 分類器改依賴哪些詞。分類準確度沒有大幅下降(例如 Single-setup raw 68.9%、sanitized 65.7%;其他兩組甚至小幅上升),但最高係數詞從
passed、repo token 轉為scope、hypothesis等任務語詞。再從每個 dataset 抽 200 條清理後軌跡掃描已標記詞,未見殘留。
這組檢查支持「明確 outcome/repository 線索已被處理」,但不能說 outcome 完全不可預測:sanitized corpus 仍可憑 task-related words 以 65.7–80.3% 準確率預測 pass/fail。作者在 Threats to Validity 明確承認結果與任務本身仍可能相關。Sanitization 候選詞需按 dataset 校準,也意味著移到新 benchmark 前不能照抄同一組停用詞。
兩種 embedding 與五種幾何選樣
作者以 Nomic Embed v1.5 編碼每個 trajectory step 的 sanitized action 與 observation,輸出 768 維向量;該模型 8,192 token context window 可容納長 traceback。files_touched、edit_size 等其他解析欄位不會放進這個文字 embedding。
- Pooled embedding:對所有 step vectors 算 768 維平均與標準差,捕捉整體語意中心與跨步變異;再串接開頭、中間、結尾 step 向量,得到 5 × 768 = 3,840 維表示。這保留幾個時間錨點,但不是完整事件次序。
- Time-series embedding:保留完整的 T × 768 step 序列,較完整地保留動作順序,但比較和選樣成本較高。結果裡它沒有普遍勝過 pooled。
幾何選樣只在前述 outcome group 內執行:Centroid 選離群內向量平均最近的 instance;Facility Location 逐一選能最大化代表未選 instance 相似度的樣本;Medoid 選總距離較小的真實樣本並逐步擴展覆蓋;Kennard–Stone 逐次選最遠離已選集合的樣本以拉開多樣性;Core/Edge 將 group quota 的 90% 給 centroid 附近典型樣本,10% 給 Kennard–Stone 式邊緣樣本。這些規則在同樣歷史 run、embedding 和子集大小下為 deterministic,無 seed 隨機抽樣(Section 4.4.2)。
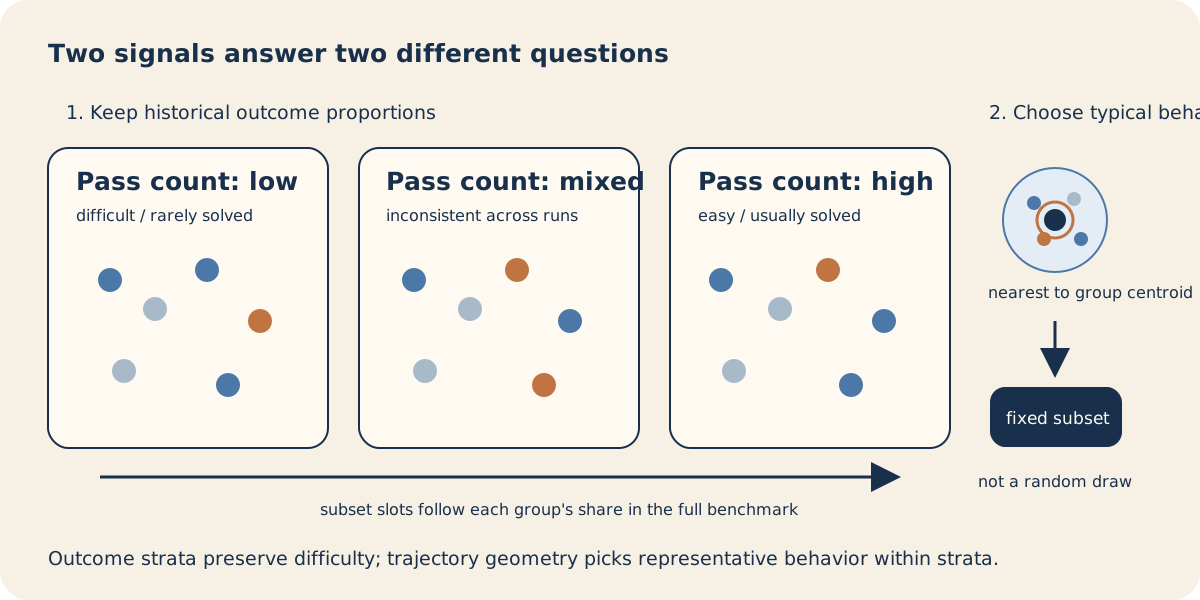
原創解釋圖,非論文原圖:此圖將 outcome-stratified sampling 與 embedding-within-strata 並列說明;歷史 pass-count strata 保留各 outcome 組比例,centroid 只是層內幾何選樣之一。對應論文 Figure 3、Section 4.4.2;請注意作者沒有授予可重用原圖的明確授權,arXiv v1 僅列 arXiv perpetual non-exclusive distribution license,因此這裡不複製原圖。來源:Figure 3 / Section 4 · 授權資訊。
評估設計:三種變動,嚴格只用過去預測未來
資料包含 31,779 條公開 trajectories、58 次 runs 與五種 agent frameworks,分三種情境(Evaluation Setup Section 5.1):
| 情境 | 資料 | 它測試什麼 |
|---|---|---|
| Single-setup | OpenHands + Qwen3-Coder,SWE-Rebench,3,188 instances、25,279 trajectories、45 runs | 同一 agent 設定反覆執行,主要是 model stochasticity |
| Multi-model | OpenHands 不同模型/執行設定,SWE-Bench Verified 500 instances × 6 runs = 3,000 trajectories | foundation model、推理設定或 iteration limit 改變 |
| Multi-agent | OpenHands、Moatless、Lingxi、Trae、Refact,SWE-Bench Verified 500 instances × 7 runs = 3,500 trajectories | agent framework 與解題策略改變,跨方法較大的 shift |
前兩組較像近期 agent 更新;Multi-agent 是較嚴苛的 transfer 條件。Multi-model 和 Multi-agent 另外由 500 個來源 issue 做 1,000 個 250-instance synthetic test-suite distributions,分散在 10% 至 90% 的九種 resolve difficulty level。Single-setup 有足夠 empirical reruns,未生成同樣 synthetic distributions。
Temporal cross-validation 將 run 按時間排序。對每個窗口大小 ,枚舉可用的 個歷史 run 組合;只能用這些 past runs 建 outcome groups、算 embeddings 和決定 subset,並且只在時間上較晚、未被用來選樣的 run 測試。落在訓練資料以前或訓練區間中間的 run 不計入該 split 的測試。Multi-model 的 有 10 個可用 split;這是刻意檢視不同歷史窗口的 stress test,部分歷史組合不連續,可能比真實部署更舊(Table 2 / Section 5.2.2)。
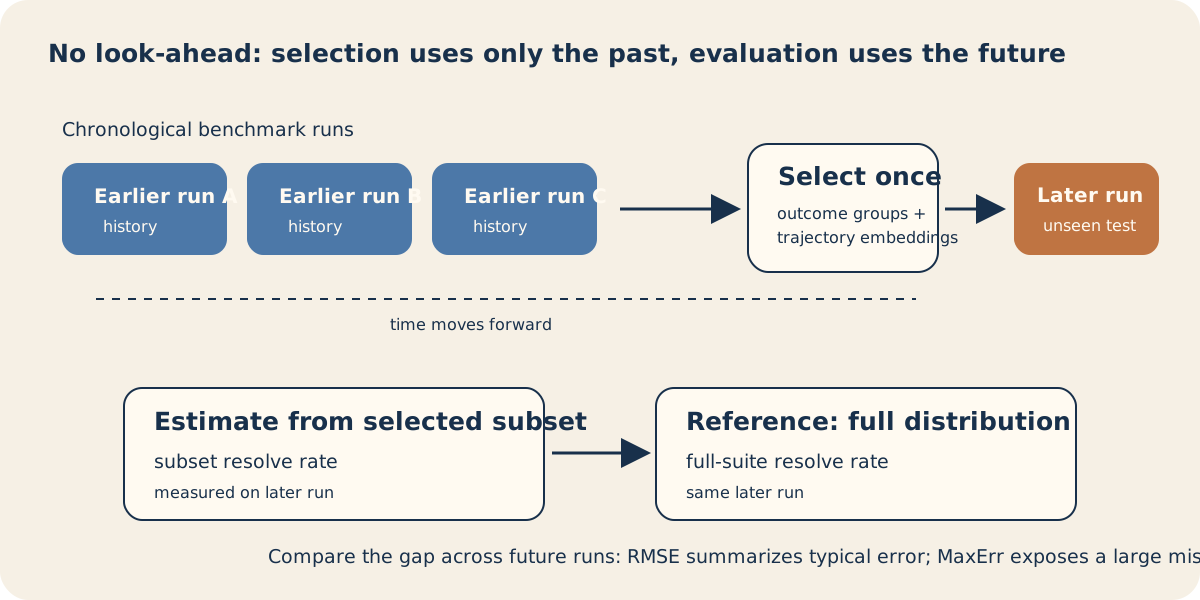
原創解釋圖,非論文原圖:過去 run 產生 selection state,較晚 run 才測試估計誤差;這個時間隔離防止選樣偷看未來 outcome。對應論文 Figure 4、Section 5.2.2;作者沒有明確授予原圖重用授權,arXiv v1 僅列 perpetual non-exclusive distribution license,故圖為獨立繪製。來源:Figure 4 / Section 5.2 · 授權資訊。
作者主要用 RMSE 看 subset resolve rate 與完整 instance pool 實際 resolve rate 的整體差距;MaxErr 是該 subset 在某一次 unseen run 上最大的差距,專門看最糟失準,而非平均。隨機 baseline 每個 synthetic distribution 和 temporal split 跑 500 個 seeds,報 median、P95、worst per-seed MaxErr。結果比較使用配對 Wilcoxon signed-rank,對同一 comparison family 作 Holm–Bonferroni 校正,並報 Cliff’s delta;不把 p-value 單獨當作實務效果。1000 個 synthetic distributions 彼此重疊,作者承認相依性使 Wilcoxon p-values 可能偏樂觀,並以效應量與 difficulty-level robustness checks 補充解讀(Sections 5.3–5.4、8.4)。
結果一:歷史 outcome 是好的 baseline,但隨機層內抽樣仍有長尾
六種 baseline 中,一致性分層(Consist-Strat)整體最強:依不同過往 run 的確切 pass count 分層,再按原始比例隨機抽。相較 Uniform Random,它將 median RMSE 降低 51%(Single-setup)、31–32%(Multi-model)、40–42%(Multi-agent);repository stratification 的提升很小,多數情況不足 2%。歷史結果因此比 repository 名稱更接近本研究所需的難度訊號(Table 3 / Section 6.1)。
但是平均誤差之外仍有大風險:5% 子集下,Consist-Strat 的典型 draw MaxErr 約 14%,最差 seed 可達 31–35%;即使 30% subset,最差 seed 仍約 10–11%。這解釋了作者為何不是只說「分層抽樣已經夠好」:開發者如果以低估的 subset resolve rate 錯誤回退有效更新,或高估而漏掉真 regression,長尾估計誤差會直接改變決策。
結果二:trajectory geometry 改善部分情境,不能把最佳方法說成到處贏
在多個 subset sizes 與資料組合中,Centroid Pooled 是表現最好的 trajectory-aware 組態之一,但改善幅度依 scenario 變化。Multi-model 的 10% subset 中,它相較 Consist-Strat 的 median RMSE 由 0.0498 降到 0.0431(相對減少 11.4%,、Cliff’s );Multi-agent 則由 0.0422 降到 0.0400(減少 3.1%)。兩者都不是同樣幅度。5% 時 Centroid Pooled 在兩組均有提升;到了 20% 或 30%,若干方法在某些資料集反而不及 baseline,顯示「trajectory-aware」這個總標籤不能替代逐格讀表(Table 5 / Section 6.2)。
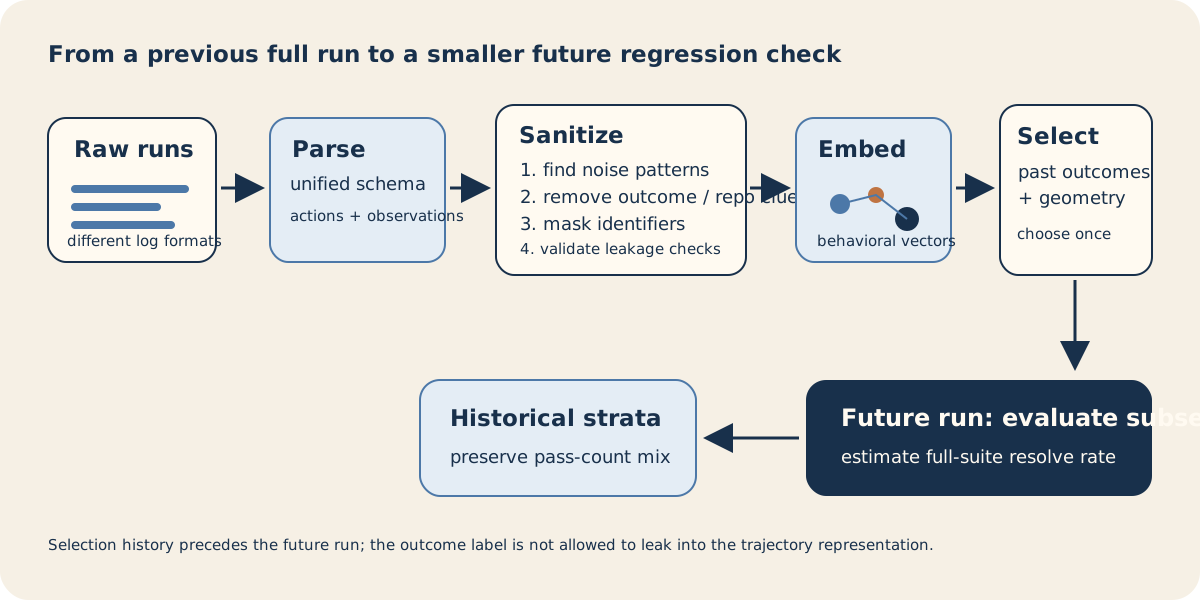
原創解釋圖,非論文原圖:圖中呈現解析、四階段 sanitization、step embedding、歷史 outcome strata、選樣與未來 run 估計的資料流;不代表量測結果。對應論文 Figure 2、Sections 4.1–4.4;原圖未獲明確重用授權,arXiv v1 僅列 arXiv perpetual non-exclusive distribution license,故採獨立原創圖。來源:Figure 2 / Section 4 · 授權資訊。
Worst-case 指標也有增益但比較基準要說清楚:5% 與 10% 子集下,Centroid Pooled 的 MaxErr 相較強 baseline 的典型 draw 降低約 4–11%,相較其 P95 draw 降低 38–46%;在 10% 時,強 baseline 典型 draw 最差誤差約 10 個百分點,P95 draw 約 15–16 點,Centroid Pooled 約 9 點。這個比較不是把所有 500 個 baseline seed 中最高的值都拿來對 deterministic 方法,而是按 paper 明定的 median/P95/worst per-seed 統計層級比較(Table 6 / Figure 6)。
為什麼 outcome grouping 和 geometry 都重要?
76 種配置的分析同時測不同設計決策:六種 random/stratified baselines、兩種 trajectory embedding(pooled、time-series)、多種幾何選樣、候選 shortlist 與 clustering family,以及 outcome grouping 有無。作者指出 outcome grouping 是必要的:移除後,純 embedding 方法 RMSE 在 Multi-model 增加 36.7%,Multi-agent 增加 30.5%。用 K-means/HDBSCAN 依行為相似性分群也不能取代 outcome grouping,最好的 clustering 配置仍比 Centroid Pooled 高 15.7%(Multi-model)與 9.0%(Multi-agent)RMSE。原因是行為相似不等於 pass probability 相同,聚類可能混合難易不同的 issue。
用 geometric selection 縮候選池後再隨機抽,也比直接 deterministic 選樣差:best shortlist RMSE 在 Multi-model 高 20.8%、Multi-agent 高 25.5%。固定但不看軌跡的 Stability-Stratified control 亦未完全重現 centroid 的優勢。這組 ablation 支持作者的機制解讀:歷史結果負責 outcome composition,geometry 負責各 outcome 組內的 behavior representative。它不證明這兩個組件是所有 agent benchmark 的唯一解法(Table 7 / Figure 7 / Section 6.3)。
另有兩點避免過度總結。第一,pooled embedding 在多數配置與結果中匹配或超過 time-series,表示完整保留 step 順序並沒有普遍增益;不能說「時序資訊愈多愈好」。第二,超參數/subset size 會改變勝負:Centroid 10% 在 Multi-model 獲得較大增益,但 Multi-agent 只有小幅提升,而 20%/30% 某些列由 Consist-Strat 或其他方法占優。文章摘要中的 median error <5% 概述最佳 10% 方案,不等於每一個 regression split 的單次誤差皆小於 5%。
token 成本:90% 是平均期望,不是每一次都剛好省九成
成本分析使用 Multi-model 的六次 OpenHands runs、3,000 條 trajectories,對每次 run 抽 10,000 組隨機子集,計算 token 消耗占 full run 的比例。各 instance token 成本差異最高達 492 倍,因此任一抽樣可能明顯高於或低於比例預期;10% subset 隨機抽樣的最寬 95% range 為 5.7%–15.0%。Centroid Pooled 10% 在所有 temporal splits 平均消耗 full-run tokens 的 10.48%,處於該隨機範圍內,未顯示偏好便宜或昂貴 instance。作者以約 3.44B 降到 345M tokens 表達 90% 平均節省(Table 9 / Section 6.4)。
這是選了 10% 的 benchmark instances 後,agent 執行 token 成本約按比例下降;它沒有計入一次性 dataset 清理、embedding 建置、下載向量或維護完整 benchmark 的所有組織成本,也沒有宣稱整個研發流程成本必然下降 90%。而且若抽中的任務恰好特別昂貴,單次 run 的實際節省會不同。
76 種配置與主要失敗模式
論文的 76 是 subset-selection configurations,不是 76 個互相獨立 benchmark,也不是 76 個 agent。組態包括傳統基線、outcome-stratified 的幾何方法、純 embedding、以 trajectory 或簡單軌跡特徵進行 clustering、shortlist hybrid 等;常規比較也測不同的四種 subset sizes(5%、10%、20%、30%)。因此解讀總體 best row 時,要一併看它是哪個 scenario、history window、embedding family、subset size,不能只摘出最強值。
論文與結果表顯示幾類會讓方法失效或退化的情形:
- 歷史已過時或 agent 大改:子集由以前的 run 固定建立,若 model、tool policy、prompt 或 framework 造成行為 shift,歷史 embedding 可能不再代表未來。Multi-agent transfer 就是更困難的情境;不宜視為歷史 subset 免更新。
- 只保 outcome 或只保 behavior 都不夠:只保 pass-count mix 時,層內隨機抽樣仍有高 MaxErr 長尾;只按 behavior clustering 時,難易不同的 instance 可能混組。
- 清理會殘留任務代理訊號:classifier accuracy 仍 65.7–80.3%,所以 sanitizer 移除了直接字詞,沒有把任務內容與 outcome 的所有相關性洗掉。新 dataset 必須重校準並驗證。
- 時序 representation 不是免費增益:pooled 對事件序列順序不敏感,time-series 保存順序,但實驗未見它系統性更好;順序敏感 representation 仍需針對該 benchmark 驗證。
- 最大誤差不等於每種安全性問題:RMSE 與 MaxErr 評估的是 resolve-rate estimation,不能代替新 issue coverage、錯誤類型召回、回歸 detection power 或模型 ranking。
- 統計切分有相依性:synthetic distributions 來自同一 500-instance pool,平均 Jaccard overlap 約 0.35。作者說這會讓 Wilcoxon p-values 偏樂觀,並補報 Cliff’s delta、九個 difficulty level robustness check;讀者不應只看小 p-value。
限制與結論邊界:哪些推論仍未成立
本文的最強結果是針對 SWE repair benchmark resolve rate 的估計誤差,不是 agent 整體品質或每一類新 regression 的檢出率。三種情境雖跨越同一 agent 重跑、改 model/configuration 與改 framework,仍屬 SWE-Rebench 和 SWE-Bench Verified;作者也將跨到 web navigation、tool-use 等其他任務列為後續研究。歷史資料若已老化或 coding agent 的行為改變,先前選出的固定 subset 可以失去代表性。
另外,sanitization 的 classifier 結果顯示直接 outcome token 已減少,但任務文字仍含可預測 pass/fail 的訊號;這不等於洩漏已完全消失。1000 個 synthetic distributions 來自重疊的 500-issue pool,使顯著性檢定的獨立性假設受限。最後,10% 子集的平均 token 成本約為 full run 的 10%,但每個 issue 的成本差異最高 492 倍,因此單次執行可能超出期望。以上限制表示讀者應把 subset 當作同 benchmark 的較便宜估計器,保留 periodic full run 和各自的 task coverage 驗證。
證據地圖:Paper、Evidence 與工程判斷
| 層次 | 本文的說法 |
|---|---|
| Paper 直接支持 | trajectory parsing/sanitization/embedding、outcome-stratified geometric selection、三種 evaluation scenarios、RMSE 與 MaxErr、76 個配置及 ablation 的定義與結果。 |
| 作者解讀 | outcome grouping 保難度組成,trajectory geometry 在各層挑代表行為;兩者結合可在特定 SWE regression setting 降低估計誤差與長尾風險。 |
| 實驗觀察 | 10% Centroid Pooled 的 Multi-model median RMSE 0.0431,Multi-agent 0.0400;成本 sample 平均 10.48%;移除 outcome grouping 的 RMSE 增幅為 30–37%。 |
| Bloss0m engineering synthesis | 將小子集視為頻繁、低成本的 regression signal,同時排程較慢的 full run;以 error budget 決定哪些更新可先合併、哪些結果必須等待 full suite。這是部署建議,不是本文測得的 CI policy。 |
| 尚未建立 | 跨出程式修復任務的有效性、任意 agent framework/benchmark 的 10% 充分性、所有 config 下的普遍優越性、對新失敗類型的 recall、subset selection 替代 full evaluation。 |
Bloss0m 工程判斷與不適用條件
Bloss0m 工程化整理(非作者提出的額外流程):若團隊考慮把類似方法放入 CI,可先確認三項條件。其一,每次 subset 的歷史 full-run outcome、trajectory 和 benchmark version 可對齊,且只用時間上已存在的資料建 subset。其二,執行資料已依該 benchmark 具體移除顯式結果 token、repo identity 和 log boilerplate,並以分類器/抽樣檢查確認清理。其三,subset 與 full suite 定期做同 run 對照,監看 RMSE 之外的最大偏差、未涵蓋 task categories 和重大 regression;當模型/框架大改或偏差超過團隊門檻時重建子集。這些是實務化檢核,不是 paper 評估過的完整 production protocol。
適用條件是:有歷史完整 run、instance 集合可跨 run 對齊、未來目標仍是同一 benchmark 的 resolve rate,而且每個變更無法承受頻繁 full evaluation。相反地,如果 agent 已換成新工具/新框架、benchmark task domain 變化、資料沒有足夠的歷史 run、清理程序無法確認 outcome leakage,或目標是找罕見安全/品質失敗而非估計平均 resolve rate,就不要只依賴此 subset。可以把它當早期訊號,但應搭配 full run、任務分層 coverage、targeted regression tests 與明確 rollback 門檻。
Artifact 與可重現性(截至 2026-09-24)
作者連結的 GitHub replication package 公開可瀏覽。當日檢視 README 與 repository root:可見 results/、四個 RQ reproduction script、共用分析程式、pipeline/、entry-point reproduce.py 和 requirements;README 說明可直接從已提供 results 重製多數表格、圖與數值(python reproduce.py results),這不需下載原始 trajectories。這是可用的分析與 results artifact,但該 repository 的 LICENSE 目前寫明 replication package 尚未選定授權,因此不得假設可以自由再散布程式碼或資料。
若要重跑從 trajectory 到結果的 pipeline,README 另外要求下載各組 vectors、repository map 或 raw trajectories。2026-09-24 直接檢視 vectors dataset card 可見三個向量檔案清單、MD5 manifests 與約 5.57 GB 總大小;卡片說明 embedding 檔案可下載,但沒有標出 vector dataset 的明確 reuse license,並指出原始 trajectories 仍受各來源條款約束。它列出的 multi-agent archive 有 3,499 個 vectors,少於 paper scenario 的 3,500 條 trajectories,原因是其中一條空 trajectory 無向量。SWE-Rebench trajectory dataset 頁面可瀏覽 67.1K rows、CC BY 4.0 與讀取範例;SWE-bench experiments repository 也公開可瀏覽。本次沒有實際下載數 GB archives,也沒有端到端重跑,因此可確認公開列出與可檢視,不能報稱已重現整個 pipeline。README 估計部分全流程需數小時,embedding 還可能耗數十至數百小時。repo checkout 本身不等於所有 inputs 都一併附上,vector fetching、source-specific access 和長時間重算仍是額外依賴。
紙本圖表本身也要區分授權。arXiv v1 頁面標示的條款是 arXiv.org perpetual non-exclusive distribution license,不是明確的 CC BY figure reuse grant;repository LICENSE 同樣未選定。本文因此不複製論文原始 Figures 2、4、6,改用三張原創解釋圖,逐張連回 paper anchor,沒有重繪原圖 layout 或冒稱來源圖。這些圖是 Bloss0m 作者繪製的講解素材,不是新的實驗證據。
下一步閱讀與三個記憶點
如果你也在想 trajectory 訊號應如何解釋,可接著讀 BTS AgentBench 的可重播 telemetry;若關心 Agent 工具過程是否可觀測,可對照 Agentic RAG 因果失敗歸因。兩篇工作問題不同,但都提醒讀者:終局分數無法取代對過程資料與評估單位的仔細定義。
- 技術想法:歷史 pass-count 分層控制 subset 的 difficulty mix,trajectory embedding 只在 strata 內幫忙挑代表行為;這兩個選樣訊號不能互相代替。
- 證據:作者在 31,779 trajectories、58 runs、五種 frameworks 和 76 configurations 上做 future-run evaluation;10% Centroid Pooled median RMSE 在 Multi-model/Multi-agent 為 4.31%/4.00%,成本實驗的平均 tokens 下降約 90%,但不同資料與 subset size 有勝負變化。
- 邊界:這仍是 2026 arXiv v1、SWE-Bench Verified 與 SWE-Rebench 的 coding-agent regression study;它不能推出其它 agent task 可縮成 10%,也不能取代 full evaluation。
Primary sources
- Mahmoud Ayyad et al., Trajectory-Aware Benchmark Subset Selection for Cost-Efficient Software Engineering Agent Regression Testing, arXiv:2609.24928v1(submitted 2026-09-21;預印本,未同儕審查)。
- arXiv abstract and license metadata(arXiv.org perpetual non-exclusive distribution license)。
- Author-linked SWE-agent subset selection repository(README、results、reproduction scripts、pipeline;repository LICENSE 尚未選定)。
- SWE-Rebench trajectory dataset;published embedding vectors;SWE-bench experiments。