論文精讀
HyPE 論文精讀:用假設性提示嵌入改善 RAG 檢索
原文:Bridging the Question-Answer Gap in Retrieval-Augmented Generation: Hypothetical Prompt Embeddings
90 秒掌握論文 / The paper in 90 seconds
- 問題:一般 dense RAG 把使用者的疑問直接嵌入,再拿它與宣告式、說明式的文件 chunk 比相似度。問題的語氣像「我要查什麼」,文件卻像「這裡描述什麼」;兩者不只內容不同,表達形式也不同。
- 核心洞見:HyPE(Hypothetical Prompt Embeddings)把「生成一段可能的回答」這件事從 query time 移到 indexing time。每個 chunk 先由 LLM 生成多個可能會被問到的問題,再把問題向量連回原 chunk;線上 query 因而變成 question-to-question matching。
- 最強證據:在六個資料集的 aggregate Table IV,HyPE 的 retriever claim recall 是
71.5 ± 12.5,Naive RAG 是53.6 ± 19.0;context precision 是63.5 ± 13.8對42.3 ± 17.4。不過這些是固定 bge-m3、Mistral-NeMo、RAGChecker 與論文 preprocessing 下的結果。 - 主要邊界:HyPE 不是免費的「換向量就好」。每個 chunk 至少要一次 indexing LLM call,索引中還會為同一 chunk 保存多個向量;問題生成品質、chunking、corpus freshness 與 query 分布,決定離線成本能不能換到線上收益。
核心工程判斷:HyPE 的價值不只是多生成幾個 query,而是重新安排 RAG 的成本位置:用一次性的假設問題生成,改善長文或問法差異大的 corpus 對齊,讓線上服務不必為每個 request 再呼叫一次生成模型。它適合當成 retrieval layer 的可插拔實驗;但論文並未證明它在所有 corpus、所有 embedding model 或所有生成器上都會優於 Naive RAG 與 HyDE。
論文身分、範圍與證據地圖 / Identity, scope, and evidence map
本文閱讀的是 arXiv 2607.29402 v1 的完整 HTML 與 v1 PDF。作者是 Domen Vake、Jernej Vičič 與 Aleksandar Tošić;arXiv 頁面標示 v1 於 2026-07-31 提交,並列出 IEEE Access 13(2025)期刊資訊。這裡同時保留兩個時間:期刊 citation year 是 2025,arXiv v1 是 2026 的後續公開版本;不能把 arXiv 提交日當成期刊出版日。
論文類型是 retrieval method + empirical benchmark paper。它提出一個改變 indexing/retrieval 對齊方式的框架,再以六個資料集、三條 pipeline、四種 retrieval depth 與多個 RAGChecker 指標做比較。它不是新的 embedding backbone,也不是新的 generator;它改的是「我們用什麼文字產生向量、向量在什麼時間被建立、線上 query 如何找到原始 chunk」。
| 層次 | 本文採用的說法 |
|---|---|
| Paper 直接支持 | HyPE 的 offline hypothetical-question generation、向量—chunk index、Naive RAG/HyDE/HyPE pipeline、六個資料集、bge-m3、Mistral-NeMo、RAGChecker 指標與 Table III–V 的數字。 |
| 作者解讀 | question-to-question alignment 能減少 query 與 document style mismatch;離線生成可降低每個 request 的額外 LLM call;改善 retrieval context 後,generator 指標也可能改善。 |
| Evidence 尚未建立 | 所有領域都提升、任何 embedding model 都同樣有效、索引期成本一定低於 query-time 成本、HyPE 在不重建索引下能處理快速變動 corpus,或它能保證 production answer faithfulness。 |
| Bloss0m 工程化整理 | 把 HyPE 當成一個需要版本化的 indexing contract:保存 source chunk、generated prompt、generator version、embedding version、更新時間、重建原因與 query-to-chunk evidence path。 |
Paper Essence Contract:六個問題的短答案
- 它解決什麼問題? 它要處理 query 的疑問句形式與 corpus chunk 的說明句形式之間的 embedding alignment gap。
- 為什麼既有方法不夠? Naive RAG 直接比較 query 與 document;HyDE 在每次 query 時生成 hypothetical answer,可能改善 alignment,卻增加線上推理成本,且生成答案未必熟悉 niche domain。
- 核心技術想法是什麼? 對每個 chunk 離線生成多個 hypothetical prompts,嵌入這些 prompts 並將每個向量映射回原 chunk,讓實際 query 與假設問題互比。
- 一個 input 怎麼走?
document → chunk → hypothetical questions → embeddings → vector–chunk index是 indexing path;user query → query embedding → ANN nearest hypothetical questions → original chunks → generator是 online path。 - 什麼證據支持 headline? Table III 的跨資料集、跨
k比較,Table IV 的 mean ± sd aggregate,Figure 4/5/7/8 的分布與 dataset-level 視圖,以及 Table V 的 Wilcoxon/Cliff’s delta。 - claim 在哪裡停止? 結論停在六個 benchmark、固定 bge-m3、固定 Mistral-NeMo、作者的 chunking 與生成 prompt;它沒有測試 corpus update churn、更多 generator/embedding model、真正服務流量或完整 indexing cost。
先理解三個 retrieval 物件 / Three retrieval objects first
Query、chunk 與 hypothetical prompt 不是同一種文字
一個 RAG corpus 可以先切成 個 chunks。Naive RAG 對使用者 query 做 embedding,得到 ,再直接與代表 chunk 的向量比較。假設 query 是「什麼情況會觸發帳戶鎖定?」;文件 chunk 可能寫成「帳戶連續五次驗證失敗後會進入鎖定狀態」。兩者描述同一件事,但句法與資訊視角不同。
HyPE 對每個 chunk 讓 generator 產生 個假設問題:
再以 embedding model 將每個假設問題變成向量:
索引不是只保存一個 chunk vector,而是保存多個向量—chunk pair:
這裡的 是每個 chunk 產生幾個 hypothetical prompts,不是線上 ANN 要回傳的 top- chunks;論文的 Algorithm 1 與 Algorithm 2 使用同一個字母語境,讀者實作時應把兩個參數分開命名。這不是數學小事:前者影響 indexing token、向量數量與 coverage,後者影響線上 context breadth、重複與 generator noise。
核心直覺:把「每次猜一段答案」改成「事先列出可能的問題」 / Core intuition
Naive RAG 的控制點是:query 到來後,直接問 vector index 哪些 chunk 看起來像 query。HyDE 的控制點是:query 到來後,先讓 LLM 生成一段假設答案,把 query 轉成 answer-like text,再用這段 synthetic text 找真的文件。兩者都把額外工作放在線上。
HyPE 則反過來。文件加入 corpus 時,就問:「未來的人可能會用哪些問題來尋找這個 chunk?」這些 hypothetical prompts 是 offline 的對齊層。線上 query 只需以同一個 embedding model 產生向量,找到最像的 hypothetical questions,再沿著它們回到原始 chunk。於是它不是把真實文件改寫成答案,也不是把文件永久附加上問題文字,而是保存一組指向同一 chunk 的 query-like vector。
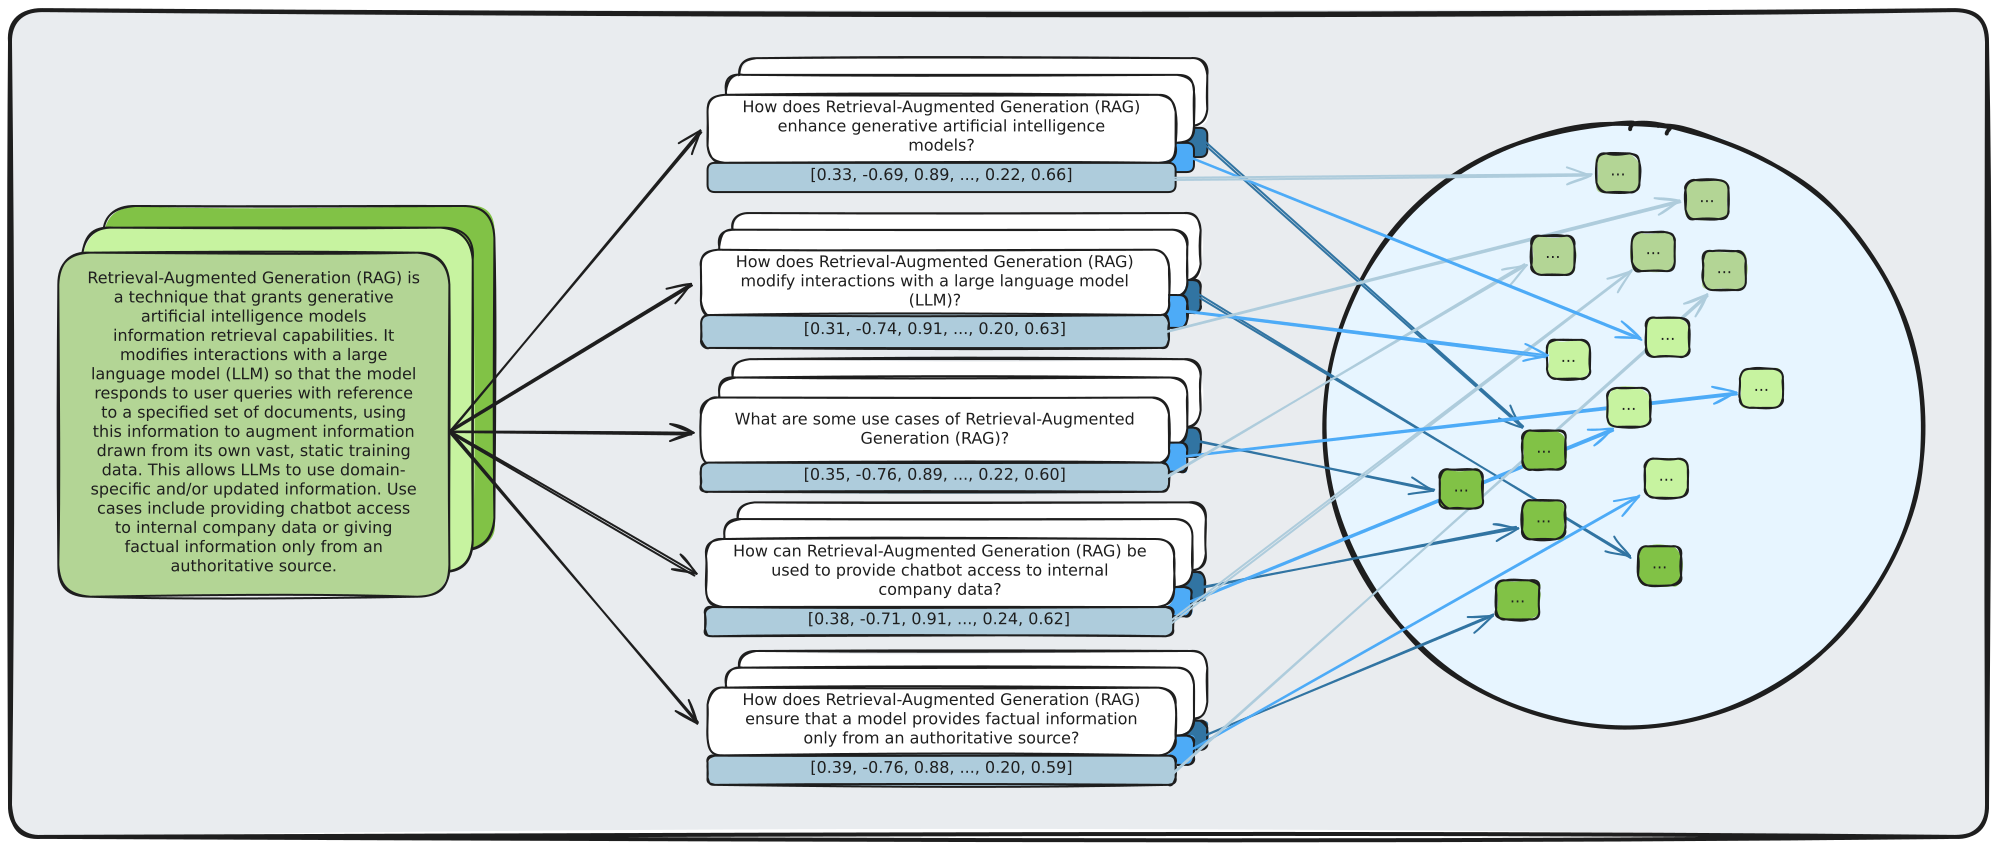
圖 1(原論文 Figure 1,Section II 結尾的 HyPE framework overview):左側是 corpus chunk,中央是多個 hypothetical questions/embeddings,右側是 query-time retrieval 回到原始 context;讀者應注意「生成」位於 indexing path,而不是每次 request。原始 Figure 1 anchor · 原始 SVG endpoint。arXiv HTML 頁面標示 CC BY 4.0;本文直接使用 v1 原圖並保留 attribution,重用須遵守原授權與版權限制。

用一個例子走完整個方法 / Walk one example through the method
以下是依照論文機制改寫的說明例,不是論文新增的實驗結果。
- Input:一個 source chunk。 文件包含:「服務在 15 分鐘內連續五次驗證失敗時,會鎖定帳戶;管理員可在 30 分鐘後解除。」
- Indexing representation:hypothetical prompts。 generator 可能產生「什麼時候帳戶會被鎖定?」「連續幾次失敗會觸發鎖定?」「管理員多久後可以解除鎖定?」三個假設問題。每個問題各自由 bge-m3 轉成向量,並都指回同一 chunk。
- Decision:使用者 query。 使用者問「驗證錯幾次會鎖住帳戶?」線上只做 query embedding 與 ANN search;它若靠近第二個 hypothetical prompt,就把原始 chunk 拉回來。
- Output:generator context。 Mistral-NeMo 看到的是原始文件 chunk,不是 synthetic question。這讓回答仍能依據 source text,而 hypothetical prompt 只作為索引入口。
- Likely failure point:prompt 品質或 freshness。 如果 generator 沒想到「驗證失敗」這種問法,或文件更新後仍沿用舊 prompt,向量可能無法覆蓋真正 query。若同一 chunk 的多個向量重複出現在 top-k,generator 也可能看到被放大的 relevant noise。
這個例子顯示 HyPE 的改變點很窄但很清楚:它沒有重寫 answer,也沒有改變 online generator;它改變的是 ANN search 的入口表示。
三條 pipeline 到底差在哪裡 / The three pipelines
論文 Table I 把比較寫成三條 pipeline:
| Pipeline | 何時增加 hypothetical content | 比較的 representation | 線上額外 LLM call |
|---|---|---|---|
| Naive RAG | 不增加 | prompt-to-document | 0 |
| HyDE | inference time 生成假設答案 | document-to-document | 1 次 query-level generation |
| HyPE | indexing time 生成假設問題 | prompt-to-prompt | 0 |
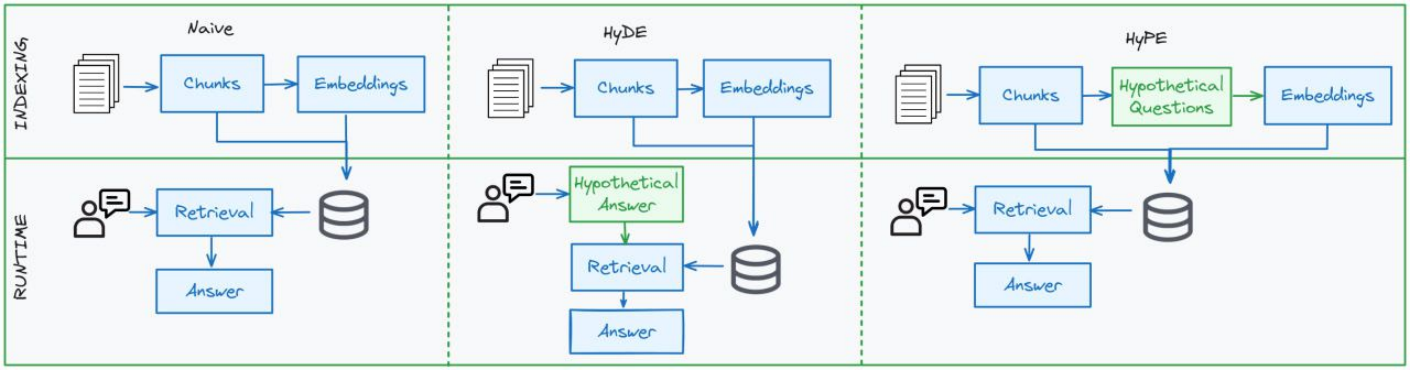
圖 2(原論文 Figure 2,Section III Methodology):圖中最重要的不是三個框架名稱,而是 augmentation stage 的位置:HyDE 把生成放在線上,HyPE 把生成放在 indexing;兩者最後都回到真實 document chunk。原始 Figure 2 anchor · 原始 PNG endpoint。原文頁面標示 CC BY 4.0;本文使用 v1 原圖並保留 attribution,重用須遵守原授權與版權限制。

Indexing cost 不是消失,而是換了時間
論文指出,一個有 個 chunks 的 corpus,HyPE 約需 次 LLM call;每個 chunk 一次 call,再一次生成 個 prompts。m 增加會擴大 question coverage,但不必線性增加 call 次數,因為多個 prompts 可在同一次 call 產生。代價被移到離線:
- 生成成本:需要 generator LLM 在每個 chunk 上產生 prompts;大型、頻繁更新的 corpus 會反覆支付。
- 索引大小:每個 chunk 對應多個向量,向量數可能是原始 chunk 數的數倍。
- 更新一致性:source chunk、prompt generator、embedding model 任一變更,都可能需要重建或版本化。
- 線上好處:query path 仍是 query embedding + ANN search,不需要像 HyDE 每次再做 synthetic answer generation。
因此更精確的 claim 是「不增加 query-time LLM latency」,不是「完全沒有額外計算」。下面的 [Bloss0m engineering synthesis] 是:若 query volume 很低、corpus 更新很快,HyPE 未必比 HyDE 或更簡單的 reranker 划算;若 corpus 穩定、query volume 高、且 query/document style mismatch 明顯,預先付費才可能合理。
實驗如何讀:六個資料集與固定控制 / Experimental setup
論文用六個資料集覆蓋不同 retrieval 情境:MS MARCO、RAGBench、Ragas-WikiQA、RAG-dataset-12000、MultiHopRAG 與 Single-Topic RAG。Table II 的 Q&A pairs 分布從 Single-Topic 的 80、Ragas-WikiQA 的 232,到 MS MARCO 的 82,326 與 RAGBench 的 73,286;平均 chunk 長度從 82 tokens 到 688 tokens 不等。RAG-dataset-12000 與 MultiHopRAG 由作者以最多 500 tokens、50-token overlap 重新切分,其餘採用既有 segmentation。
控制條件包括:
- 三條 pipeline 都使用同一套資料與 chunking 流程;
- embedding model 固定為 bge-m3;
- generator 固定為 Mistral-NeMo,讓 generation metrics 的改變主要反映 context 差異;
- retrieval depth 測試 ; 時比較 cosine 與 Euclidean distance;
- RAGChecker 同時量測 retriever、generator、overall 與 noise metrics。
這些控制讓比較比較像「只改 retrieval augmentation」;但也同時限制了 external validity。論文沒有把不同 embedding family、不同 generator、不同 chunker 或不同 prompt generator 做成完整 factorial study。
RAGChecker 指標要分層看
- Retriever context precision:抓回來的 passages 有多少直接符合 query needs。
- Retriever claim recall:必要資訊有多少被抓回。
- Generator context utilisation:generator 實際使用 retrieved context 的程度。
- Faithfulness:回答是否受 retrieved passages 支持。
- Hallucination:unsupported claims 的程度;數值越低越好。
- Noise sensitivity:在 relevant/irrelevant context 受干擾時的錯誤敏感度;此處是 downside 指標。
- Self-knowledge:模型知道自己缺少資訊的程度,讀表時不能和 precision/recall 當同一類成功率。
主要結果一:HyPE 對 precision/recall 的改善集中在哪裡? / Result 1
Table III 顯示,HyPE 在很多資料集與 retrieval depth 都領先,但不是每一列都領先。以 RAG-dataset-12000 為例,@1 的 context precision 是 Naive 55.8、HyDE 55.1、HyPE 82.6;claim recall 是 34.7、33.3、63.6。到 @10,HyPE 的 claim recall 是 84.6,Naive 是 56.1,HyDE 是 55.6。
MS MARCO 是重要反例:@1 的 HyPE precision 68.7、recall 50.2,低於 Naive 的 73.6/56.2;到了 @10,HyPE 62.5/84.0,略高於 Naive 的 precision 61.5、但 recall 仍略低於 85.7。這不是「HyPE 失敗」的充分證據,卻是提醒:當 query 與短 passage 原本就有高 lexical overlap,style bridge 的剩餘空間很小。
Single-Topic RAG 則相反。@1 的 precision 從 Naive 28.7、HyDE 22.5 跳到 HyPE 68.8;@10 的 claim recall 從 36.8、36.4 到 81.4。這與論文的解讀一致:在窄域、長文、問法與內容形式差距較大的資料上,hypothetical question vectors 可能覆蓋到原始 chunk vector 沒有覆蓋的 query phrasing。
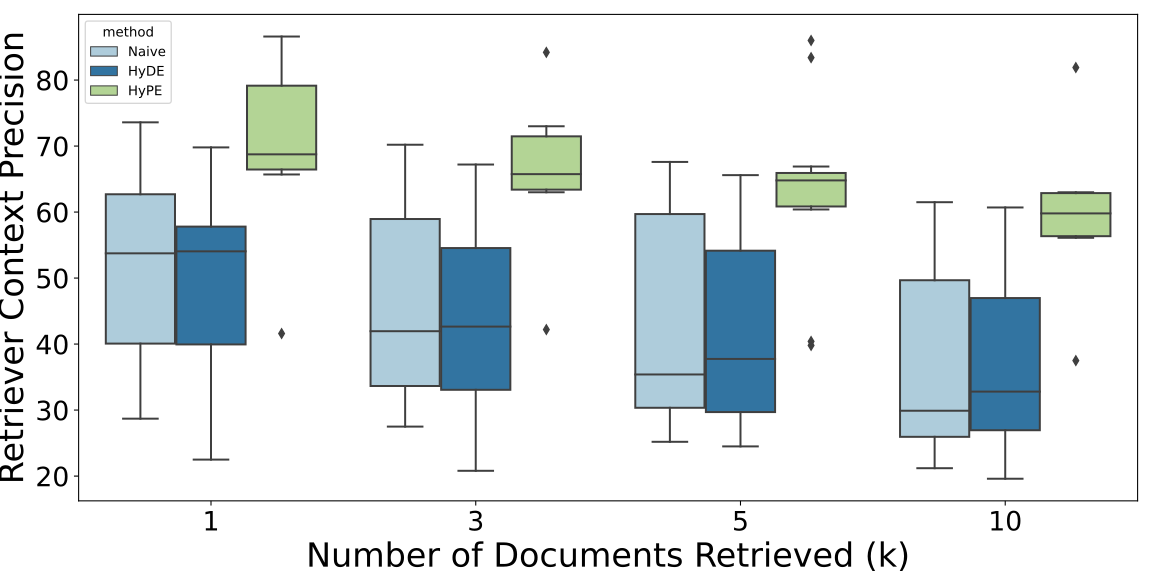
圖 4(原論文 Figure 4,Section V Results):箱形圖提供比單一平均值更重要的資訊:HyPE 的 context precision 在多個 上較高且分布較窄,但這仍是作者六資料集設定下的 paired retrieval 評估,不是所有 query distribution 的保證。原始 Figure 4 anchor · 原始 SVG endpoint。原文頁面標示 CC BY 4.0;本文使用 v1 原圖並保留 attribution,重用須遵守原授權與版權限制。

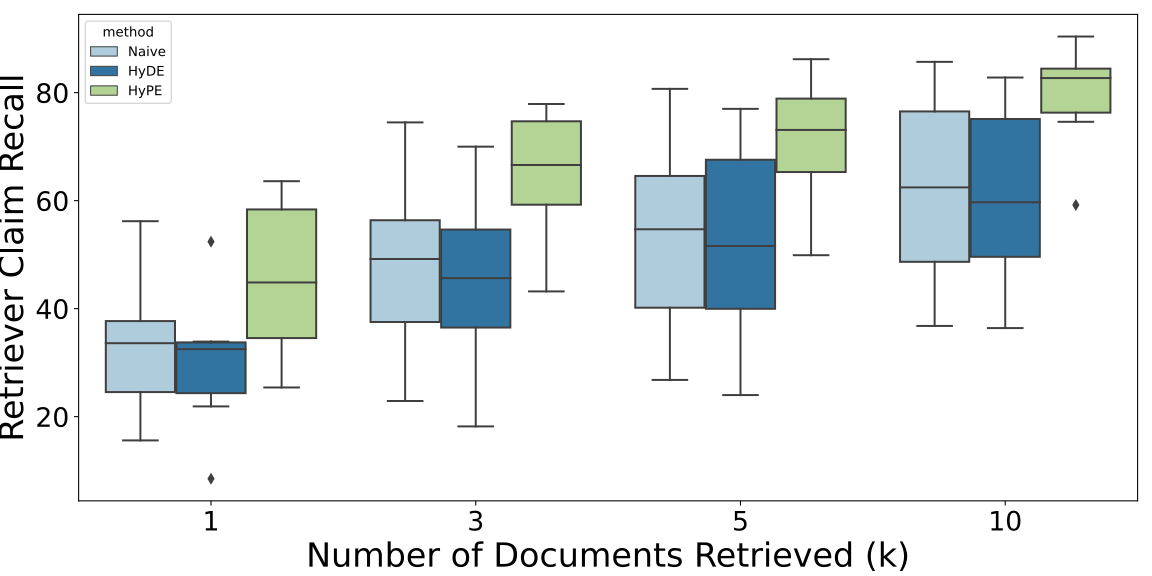
圖 5(原論文 Figure 5,Section V Results):claim recall 的改善補足 Figure 4 的 precision 視角;讀者應把「抓回更多必要資訊」與「抓回來的內容較少混雜」分開判讀。原始 Figure 5 anchor · 原始 SVG endpoint。原文頁面標示 CC BY 4.0;本文使用 v1 原圖並保留 attribution,重用須遵守原授權與版權限制。

Aggregate 數字很吸引人,但要一起看 spread
Table IV 的六資料集平均如下:
| 指標 | Naive RAG | HyDE | HyPE | 讀法 |
|---|---|---|---|---|
| Retriever claim recall ↑ | 53.6 ± 19.0 | 52.6 ± 17.8 | 71.5 ± 12.5 | 必要資訊的涵蓋較高,且跨資料集 spread 較小 |
| Retriever context precision ↑ | 42.3 ± 17.4 | 41.6 ± 15.9 | 63.5 ± 13.8 | 找到的 context 較集中 |
| Generator faithfulness ↑ | 52.2 ± 15.0 | 51.4 ± 14.8 | 69.3 ± 6.0 | 固定 generator 下的 context 對回答 grounding 的影響 |
| Generator hallucination ↓ | 26.0 ± 11.9 | 25.1 ± 11.4 | 19.9 ± 8.2 | 低較好,但仍不是 production hallucination rate |
| Noise sensitivity in relevant context ↓ | 13.8 ± 7.8 | 14.2 ± 6.6 | 21.0 ± 4.4 | HyPE 反而較差,這是重要 trade-off |
| Overall F1 ↑ | 27.9 ± 9.7 | 27.2 ± 9.6 | 37.6 ± 7.7 | 將多個 precision/recall 面向合併的總覽 |
最不能忽略的是 relevant-context noise sensitivity。論文明確說這個指標越高越差;作者推測 HyPE 可能讓相關 chunk 以多個相近向量被重複拉回,對 generator 而言,relevant information 與它的 noise 也被重複。這讓「retrieval 更對齊」與「context 裡的重複更少」成為兩個不同 optimization target。
主要結果二:生成器真的更好嗎?先看它只是同一個 generator / Result 2
HyPE 只直接改 retrieval path,generator 固定為 Mistral-NeMo。因此 Figure 7 的 faithfulness、hallucination、context utilisation 等變化可以當成「不同 retrieved context 對同一 generator 的 downstream effect」,不能寫成 HyPE 本身是一個更好的生成模型。
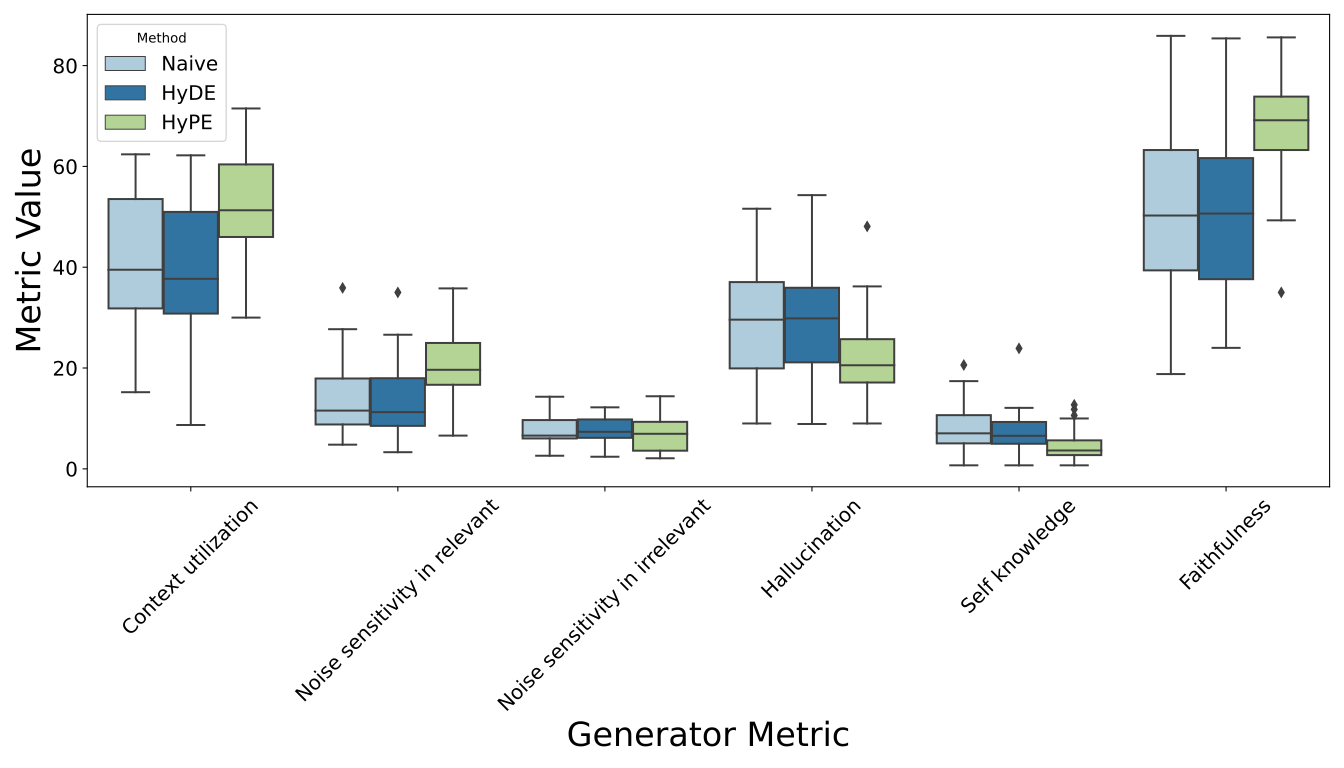
圖 7(原論文 Figure 7,Section V Results):generator metrics 的差異是 retrieval context 經過固定 Mistral-NeMo 後的結果;其中 faithfulness 與 hallucination 變好,不能抹掉 relevant-context noise sensitivity 變差這個反證。原始 Figure 7 anchor · 原始 SVG endpoint。原文頁面標示 CC BY 4.0;本文使用 v1 原圖並保留 attribution,重用須遵守原授權與版權限制。

論文 Table V 以 paired Wilcoxon signed-rank test、Holm adjustment 與 Cliff’s 比較 HyPE 與兩個 baseline。HyPE 對多個指標有中到大的 effect size;但有兩個讀法限制:第一,資料集數量很小,作者採用 distribution-free test;第二,調整後 p-value 的門檻與 minimum attainable exact level 需要依表格讀,不能把「五個指標達到較嚴格門檻」改寫成所有指標都顯著。
主要結果三:距離函數不是主角 / Result 3 and a controlled check
論文在 比較 cosine 與 Euclidean distance。Figure 6 顯示三條 pipeline 的 claim recall 與 context precision 在兩種 distance 下沒有顯著差異。這個結果的實務含義不是「距離函數永遠不重要」,而是:在這組 bge-m3、索引、資料與 的條件下,HyPE 的主要差異更可能來自 representation 與 indexing stage,而不是單純改 distance metric。
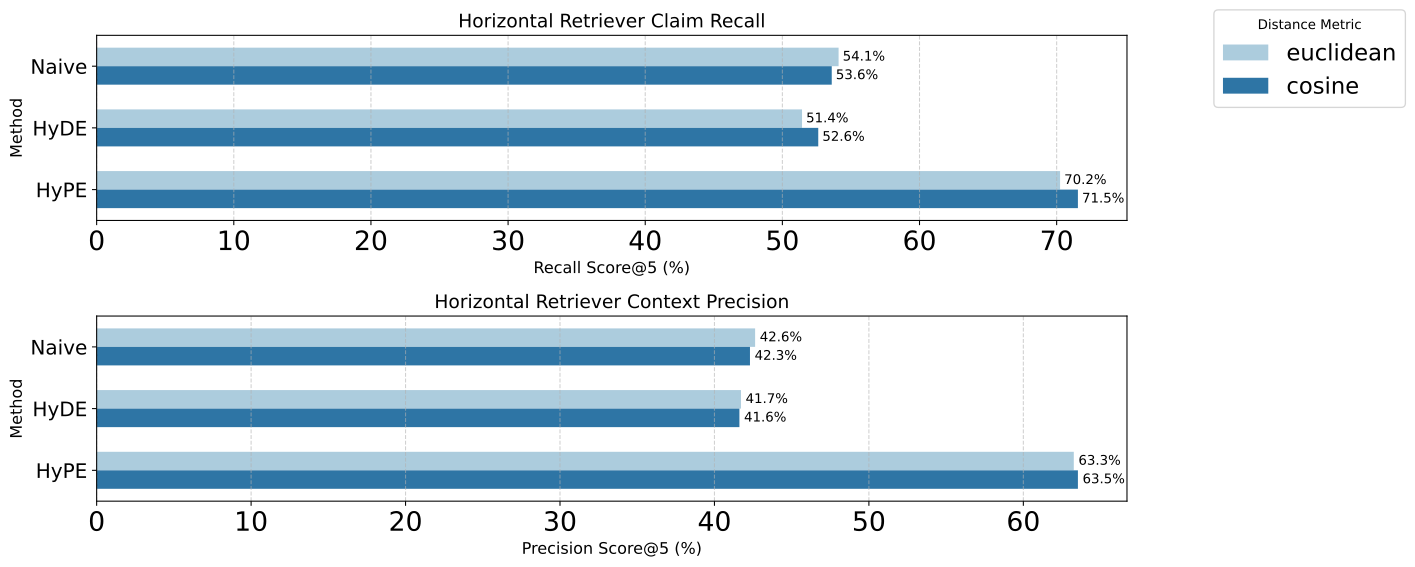
圖 6(原論文 Figure 6,Section V Results):這是控制性比較,幫助把「question-question representation」與「distance function」的影響拆開;結果不能外推成所有 embedding model 都對距離函數不敏感。原始 Figure 6 anchor · 原始 SVG endpoint。原文頁面標示 CC BY 4.0;本文使用 v1 原圖並保留 attribution,重用須遵守原授權與版權限制。

主要結果四:跨資料集 F1 的故事是「不是每個 corpus 都需要 style bridge」 / Result 4
Figure 8 把六個資料集的 F1 拆開。HyPE 在 RAG-dataset-12000、Single-Topic 與 WikiQA 等具有較長或較特定內容的資料上更容易拉開距離;MS MARCO 則三者接近。這種分布比「平均提升 16 個 recall points、20 個 precision points」更有工程價值,因為它提示採用條件:先找出 query/document style mismatch,再決定是否為整個 corpus 生成 hypothetical prompts。
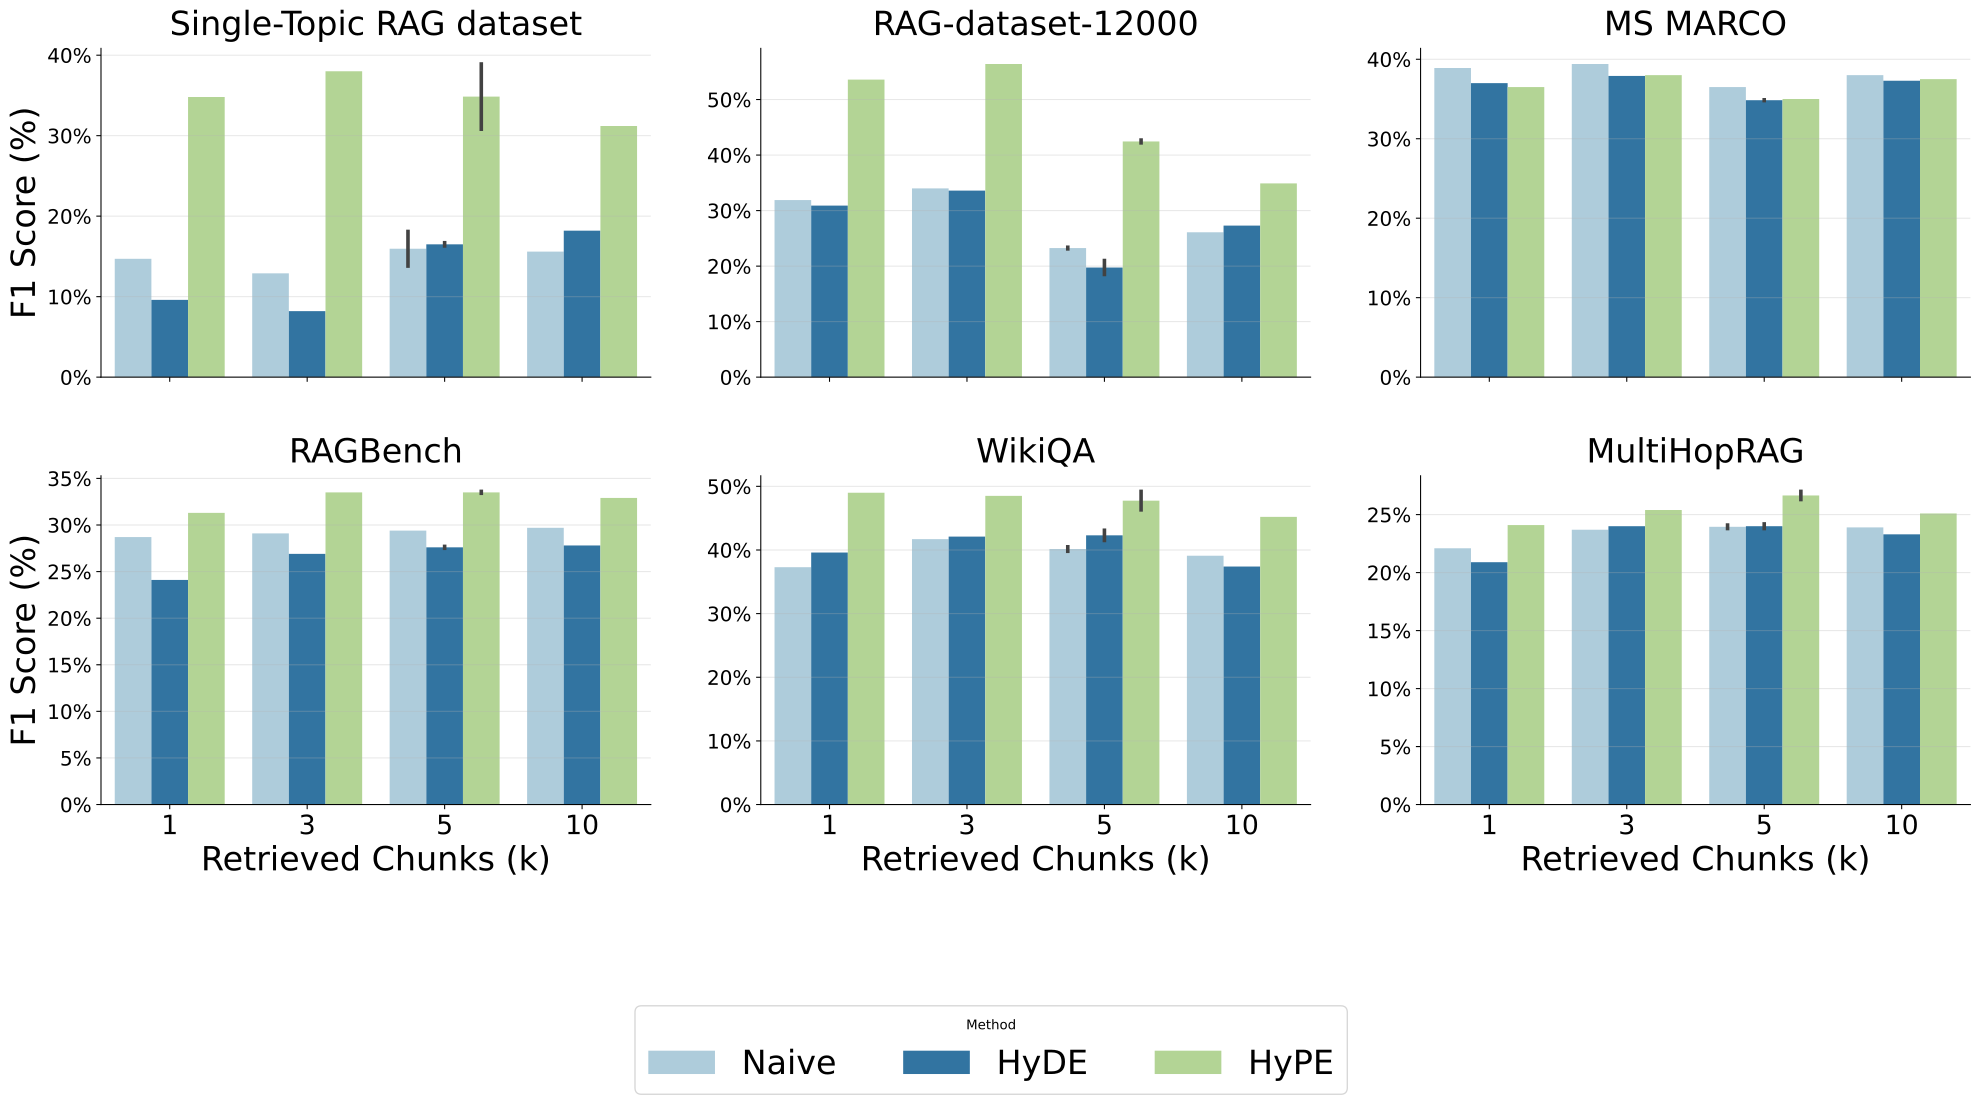
圖 8(原論文 Figure 8,Section V Results):每個子圖按 dataset 與 展開 F1;MS MARCO 的接近是重要 boundary,不能只用 aggregate mean 宣稱 HyPE 普遍優於 baseline。原始 Figure 8 anchor · 原始 SVG endpoint。原文頁面標示 CC BY 4.0;本文使用 v1 原圖並保留 attribution,重用須遵守原授權與版權限制。

Ablation、失敗模式與尚未回答的問題 / Ablations, failure modes, and open questions
Prompt quality 被平均化了
HyPE 目前把一個 chunk 的 hypothetical questions 等權處理,沒有再判斷哪些問題比較代表性、哪些是 hallucinated 或太相似。這讓 method 很容易解釋,卻留下明顯的 quality gate 缺口:一個糟糕的 prompt 不是單純少一個向量,而可能把錯誤 phrasing 寫入 index,讓 ANN search 對錯的 query 形式變得過度自信。論文把 prompt scoring、domain-conditioned generation 留作 future work。
Chunking 仍然是共同變數
作者為了公平讓三條 pipeline 使用相同 preprocessing,但這不代表 chunking 是最佳的。長 chunk 對 context 完整性有幫助,卻可能稀釋 vector specificity;短 chunk 讓向量更精確,卻可能丟掉周邊條件。HyPE 只是在每個 chunk 上增加多個問題向量,並沒有消除 chunk boundary problem。若它在某個資料集有效,不能直接歸因為「prompt-to-prompt alignment」而忽略 chunk segmentation。
Relevant noise 的反向訊號
HyPE 的重複向量可能提高找到相關 chunk 的機率,卻也讓相關資訊在 top-k context 中重複。論文的 noise-sensitivity result 正好提醒:retriever precision 與 generator robustness 不一定同向。生產系統應記錄 chunk identity、hypothetical prompt identity 與 duplicate count,不要只把 top-k 去重當成 UI 清理;它可能改變 generator 看見的 evidence mass。
單一 generator 與未量化的 indexing bill
實驗固定 Mistral-NeMo 以提升可重現性,這是合理控制,但不代表另一個 generator 會以同樣方式受益。更大的 gap 是論文雖然說明每個 chunk 一次 call,卻沒有提供完整 indexing token、generation latency、向量儲存量與 corpus refresh cost 表。因此「cost-effective」目前應理解成 query-time call 的結構性減少,不是已完成的 end-to-end TCO study。
統計結果要保留分母與選擇方式
論文在六資料集 aggregate 上報告 mean ± sd,並以 paired Wilcoxon 與 Holm–Bonferroni 調整做比較;這使得 reader 能看到 spread 與配對差異。但資料集不是大量獨立使用者 query 的 production sample,且 prompt generator、chunking、retrieval depth 與 model 都是研究者設定。效果量很有訊號,外部效度仍需要更多 corpus、更多 backbone、跨語言與長期更新實驗。
Bloss0m 工程判斷與不適用條件
值得做一個 bounded pilot 的情況
以下是 Bloss0m engineering interpretation,不是論文作者提出的 checklist:
- corpus 相對穩定,或可以接受在 source change 後增量重建 prompts;
- query volume 高,query-time LLM call 的 latency/cost 明顯高於一次 indexing;
- query 是疑問式,而文件是長篇、說明式或領域特定文字;
- 團隊能保存 source chunk、prompt、model version、embedding version 與生成時間,以便 audit 與 rollback;
- evaluator 同時看 recall、precision、faithfulness、duplicate context 與 relevant noise sensitivity,而不是只看一個 top-k 指標。
不應直接採用的情況
- corpus 每分鐘更新、且每次更新都要求最新 evidence;
- 資料量大到 indexing LLM bill、向量數量或 refresh window 未知;
- prompt generator 沒有 domain knowledge,卻要在法律、醫療或安全決策中直接把生成的 hypothetical questions 當成 coverage guarantee;
- query/document 已經高度 lexical overlap,例如論文中 MS MARCO 的短 passage;
- 系統不能追蹤 vector 對應的 source chunk,或無法在 source 更新後撤銷舊 prompt vector;
- retrieval 要求嚴格 evidence provenance,卻只保存 synthetic prompt 而沒有保存原始 chunk、版本與實際被 generator 使用的 context。
一份可實作的版本化 contract
Bloss0m engineering synthesis: 若把 HyPE 放進生產 RAG,我會讓每筆 index record 至少包含:source_chunk_id、source_version、hypothetical_prompt_id、prompt_generator_model、prompt_generation_time、embedding_model、embedding_version、chunker_config、prompt_quality_state、supersedes 與 expires_at。線上 trace 則記錄 query vector 命中的 prompt IDs、去重後的 source chunk IDs、最後送入 generator 的 context,以及是否因 freshness/quality policy 被拒絕。
這份 contract 不是 HyPE 論文的正式 protocol;它是把論文的 indexing/retrieval separation 轉成可審計工程邊界。最重要的設計決定是:synthetic prompt 可以幫助「找到」source,但不能取代 source 作為回答 evidence。
Artifact 與可重現性 / Artifacts and reproducibility
截至 2026-09-19,研讀範圍涵蓋 arXiv full HTML、v1 PDF、作者列出的 RAGChecker repository,以及論文中的資料端點。狀態要分開記錄:
| Artifact | 狀態 | 可做什麼 | 仍缺什麼 |
|---|---|---|---|
| Paper figures | usable | arXiv HTML 提供 flow、pipeline、precision/recall、distance、generator 與 F1 figures;本文保存 Figure 1、2、4、5、6、7、8 的 v1 原圖 | 仍受 CC BY 4.0 attribution 與原始版權條件限制 |
| RAGChecker | usable | public Apache-2.0 repository 提供安裝與 input schema,含 retriever/generator diagnostic metrics | 不等於 HyPE 作者的完整 experiment runner 或 exact preprocessing release |
| Ragas-WikiQA | usable | Hugging Face dataset endpoint 可讀取 232 rows | endpoint 會 redirect 到維護者的新 namespace,需固定 snapshot 才能長期重跑 |
| RAG-dataset-12000 | endpoint usable | Hugging Face dataset page 可訪問,可作資料入口 | 本文未驗證它與作者當時 preprocessing、chunking 與 exact split 完全一致 |
| Single-Topic RAG | external dataset workflow | 論文提供 Kaggle URL,可作為資料來源 | 本文未把 Kaggle download、版本與 credential 流程當作已完成 reproduction |
| HyPE implementation | not released as a dedicated repo | Algorithm 1/2、公式與 figure 足以重建概念流程 | 未找到作者專用 code、prompt generator template、完整 index files、token bill、seed 與 exact run script |
| Mistral-NeMo/bge-m3 | public upstream models | 可依官方來源取得模型與重新建立 baseline | model revision、hardware、batch size、ANN implementation 與 preprocessing 仍需自行固定 |
因此,本文不把 HyPE 寫成「有公開 repo、可一鍵重現」。較準確的 reproduction path 是:先固定六個 dataset snapshot,再用同一 chunking、bge-m3、Mistral-NeMo、RAGChecker 與作者的 hypothetical prompt template 重做 Naive/HyDE/HyPE;沒有 exact prompt、indexing parameters 與 full logs 時,只能做 method-level reproduction,而不是 claim-level reproduction。
與其他閱讀的連結 / Next reading
這篇適合接在 RAG-ANYTHING:多模態資料如何進入檢索、Dense Passage Retrieval:向量檢索的基本單位、RAGSieve:如何檢查 retrieval integrity 與 Predicting Partial Answer Quality in Agentic RAG 後面讀。它補上的不是另一種 generator,而是 indexing representation 與 query-time budget 的選擇。
讀者若要實作,建議先做一個小型 A/B:同一批 source chunks、同一 embedding model、同一 generator,對比 Naive、HyDE、HyPE 的 precision、claim recall、duplicate context、relevant noise sensitivity、indexing cost 與 refresh lag;先找出自己的 corpus 是否像 Single-Topic,還是其實更像 MS MARCO。
讀完後的三個記憶點 / Three things to remember
- 技術想法 / Technical idea:HyPE 把 hypothetical content 從 query-time answer generation 改成 indexing-time question generation,讓 retrieval 變成 question-to-question matching,但最後仍返回原始 chunk。
- 最強證據 / Evidence:六資料集 Table IV 的平均 retriever recall/precision 明顯上升,Figure 8 也顯示長文與窄域 corpus 最受益;同時 MS MARCO 的低增益與 relevant-context noise sensitivity 反向變差,證明效果有條件。
- 採用邊界 / Boundary:它降低的是 query-time LLM call,不是總成本;若 corpus 變動快、prompt 品質不可控、無法版本化 source 與 index,離線生成的收益可能被 freshness、storage 與 evidence provenance 吃掉。
Primary sources
- Bridging the Question-Answer Gap in Retrieval-Augmented Generation: Hypothetical Prompt Embeddings — arXiv 2607.29402 v1
- Full paper HTML with Figures 1–8, Tables I–V, Algorithms 1–2, and Sections I–VI
- v1 PDF
- IEEE Access DOI record
- RAGChecker official repository
- Ragas-WikiQA dataset endpoint
- RAG-dataset-12000 dataset endpoint
- Single-Topic RAG evaluation dataset
- Mistral NeMo official model announcement