論文精讀
Completed Pairs Hide Capped Failures 精讀:配對評估的停止規則與未知結果
原文:Completed Pairs Hide Capped Failures: A ReVerPi Case Study of Selective Context Projection
90 秒掌握論文
- 問題:如果一個實驗先跑 full context,再跑 projected context,而且第一個分支沒有在資源上限內完成就中止整組配對,那麼「只分析完整配對」會留下什麼樣的結果?第一個分支的 cap 已經是失敗證據;被略過的另一邊卻還沒有 outcome。兩種狀態都會被 complete-case filter 隱藏。
- 核心洞見:評估 runner 是 treatment protocol 的一部分。它決定哪些反事實被觀察到;若 companion 是否執行取決於 first arm 是否完成,配對結果就不是單純缺幾列,而是由已觀察的 outcome 控制缺失機制。
- 最強證據:這個 86-run、641-request campaign 的 27 個 paired/capture boundaries 中,只有 15 組成為完整配對;每個 arm 在這 15 組都答對 12 題。保留停止組後,有限 frame 中 projected 相對 full 的成功差只能落在 -9 至 +1 題,而不能再說兩邊平手(Section 5.2、Table 3)。
- 主要邊界:這是單一 ReVerPi/Pi 設定、adaptive source-reading campaign 的方法個案。它說明這種 stop rule 如何遮住本次資料中的 bounded failures,不估計其他 benchmark runner 發生同類偏差的比例,也不支持 context projection 的一般優劣。
這篇論文的故事不是「壓縮一定會讓 agent 更差」。作者先在 ReVerPi 中保留完整 observation archive,於每次 outgoing request 將符合條件的舊 observation 換成較短 excerpt 與可定址 handle;agent 因而可能少重送文字,也可能多花 model turns 搜尋、讀取證據。接著作者回頭拆解實際 runner:它依序執行 full 與 projected continuation,第一個分支若因 request cap 而非 completed,就停止整個 pair。結果是 completed-only 分析同時去掉 cap failure 與沒有執行的 companion。作者用固定已記錄 frame 的 worst-case bounds 保留 unknown,再把 selector fitting 案例、已知兩邊正確的成本層,以及單次 retrieval failure 分開讀。這是一篇關於「要如何評估一個資源介入」的案例,不是 context projection 勝負賽。
本文讀 arXiv v1(2026-09-25),目前是 preprint;來源頁未建立同儕審查狀態。全名是 Completed Pairs Hide Capped Failures: A ReVerPi Case Study of Selective Context Projection。
評估問題:context 變短,不代表完成任務的成本變低
Agent 的 context projection 會把舊工具輸出移出當下對話視窗,保留一小段 head/tail excerpt 與 archive handle。當模型之後真的需要舊證據時,它可以搜尋 archive,或用 handle 讀回精確區間。這種設計的直接效果是 outgoing request 裡可能少了大量重複 input;間接效果則可能是多幾輪 retrieval、更多新的模型請求,甚至在拿到答案以前耗盡上限。
因此,實驗單位不能只看每次 request 有多少 token。至少有三個不同問題:一個 continuation 是否在固定 cap 內給出正確答案;它在整段過程用了幾個 suffix requests;以及把共享 prefix 算回每一個可部署的 arm 後,總 token expenditure 如何改變。若只留下兩個 arm 都完成的 pair,就會把「完成」先當成進入成本比較的資格,再把這群人的成本差誤讀成全體介入成本。這篇論文把 runner 的停止條件和資料 filter 一起當作研究對象,正是因為 harness 的控制流程能改變被看見的證據。
方法機制與實驗流程:共同 prefix、兩條 continuation、一次 cap 決定是否看見 companion
ReVerPi 的記錄歷史仍保留原始 observation;projected continuation 只改寫送往模型的 request view。舊工具輸出要至少 10 KiB、曾在兩個已完成 full-observation requests 中出現,且不能是最近一筆、error、archive recovery 或 revalidation result,才符合 projection eligibility。符合時,預設 1,024 bytes 的 excerpt 由原 observation 的 head 與 tail 組成,完整內容則以 content-addressed archive 保存。模型可用 search_evidence 找 literal substring,或用 recover_evidence 讀取 handle 指定的區間;兩者共用三次成功操作的 quota。這個 campaign 只用 reading/archive access,並非完整 ReVerPi 所有能力的比較(Section 3.1、Table 1、Figure 1)。
Capture 階段先以 full observation 走到第一個可介入的 dispatch boundary。控制器暫停在 request 送出以前,封存已完成的共同 prefix tape,再從同一個 prefix replay full(F)和 projected(P)兩條 continuation。兩邊第一個實際 suffix request 除了工具結果呈現方式以外,工具、模型設定及其他欄位必須相同;後續工具選擇、回答與呼叫數可以不同。也就是說,配對是「同一已實現 prefix 的兩個後續分支」,不是兩個獨立 seed 的 population sample。每個 paired plan 對 suffix 設 12 個新 model requests 的 cap。錯誤答案也算 runner 的 completed state;沒有 final answer 而用完 cap 則不算完成(Sections 3.2–3.3、4.1)。
這 76 個 paired/capture submissions 內,44 個在符合 eligibility 以前就結束,5 個於 capture 停止,27 個到達已驗證 boundary;研究另有 10 個單臂 integration runs,其中 6 個到達 single-arm boundary。不要把 86 次 submitted run 當作 86 組配對,也不要把單臂資料補成不存在的 counterfactual。作者記錄 641 次已完成 model requests,這些 request 是整個 campaign 的資料量,不等於 641 個獨立實驗單位(Figure 2、Table 12)。
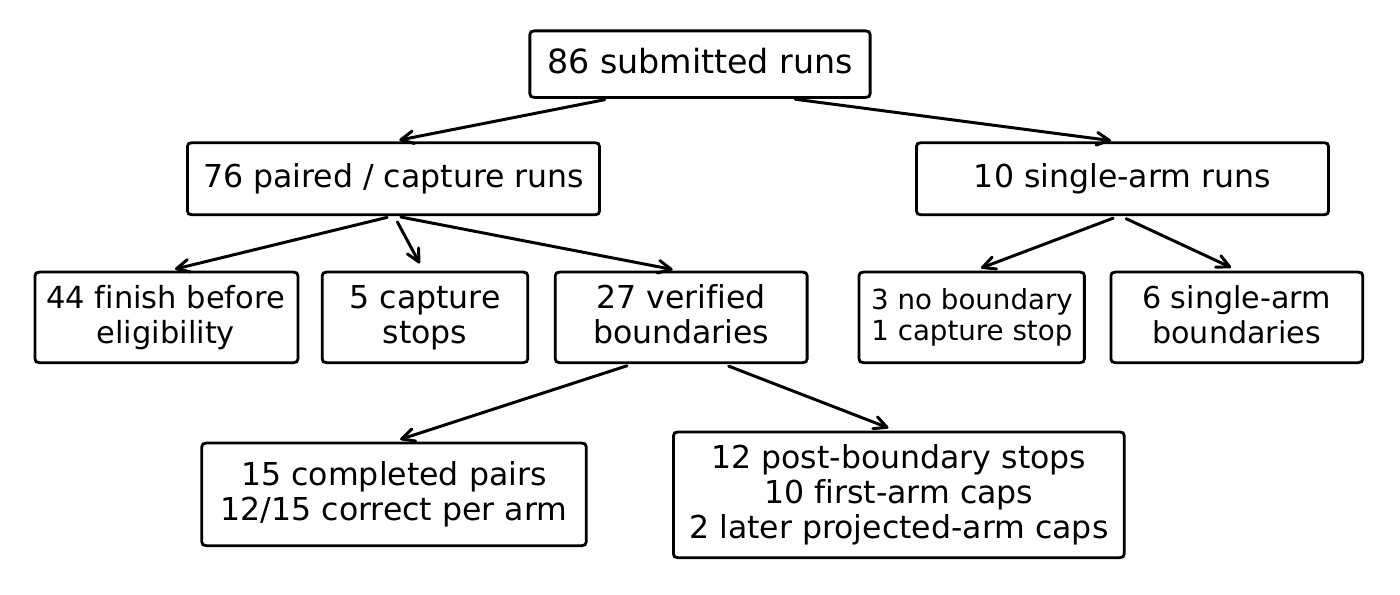
Figure 2(論文 run-flow 圖):86 次 submitted runs 分成 76 次 paired/capture 與 10 次 single-arm integration;paired/capture 中只有 27 次到達 boundary,並再分為 15 組完成配對與 12 組停止。重點是完整配對 filter 丟掉了哪些 boundary,而不是各類比例可推廣到其他 campaign(Section 5.1)。原始 Figure 2 取自 Zhang, “Completed Pairs Hide Capped Failures,” arXiv v1,圖檔位於 arXiv source archive 的 figures/run_flow.pdf;依 CC BY 4.0 重用。
核心直覺:配對名單由完成順序選出
設每一題分配兩個 branch。在「兩邊都先排好,再由 cap 決定分析樣本」的設計裡,未完成一邊可能是因為該方法難以收斂,也可能是模型、工具配額或其他有界資源真的被耗盡。若 runner 對第一個 arm 的不完成直接 break,就會產生一個明確的 schedule:first arm 沒完成時,companion 被觀察到的機率是 0。這不是一般意義下偶爾漏記一列;這個區域根本沒有 companion outcome 可供估計或加權恢復(Section 3.3、Equation 2、Appendix A.3)。
本次 27 個 paired/capture boundaries 中,15 組完成兩邊;另外 12 組停止。十組是第一個 arm 用盡 cap,runner 因而不執行 companion。剩下兩組由 full 先完成,再由 projected 碰到 cap。第一 arm 的次序在每一 source group 中以 hash seed 起始、再輪替,所以記錄到 15 個 F-first 與 12 個 P-first;此規則不是獨立隨機分派。F-first 的 cap 是 3/15,P-first 是 7/12,但這兩組 boundary 的 task 和來源不同,不能把差距讀成順序的因果效果(Section 3.3、Table 2、Appendix B Table 8)。
只取 15 組完整 pair,F 和 P 都答對 12/15,看起來完全相同。可是在這一小批 pair 中,兩邊同時正確 11 組、同時錯 2 組、只有 F 正確 1 組、只有 P 正確 1 組。再看停止的 12 組,每組至少有一個已觀察 cap failure;其中十個另一 arm 完全沒跑,仍然是未知。completed pair filter 把這些邊界條件都移出了 headline summary,留下的 12/15 對稱性本身並不告訴我們被排除分支會成功還是失敗。
既有方法為什麼不夠:complete-pair filter 無法補回零機率的 companion
既有 benchmark 報告常把完整配對當成可直接比較的分析集合;但只要 runner 的停止規則讓 companion 在某種 first-arm outcome 下永遠不執行,complete-case filter 就會把失敗與未知一起條件化掉。若 companion 在該區域的觀察機率是零,僅用已觀察的 first-arm 結果做 regression 或 inverse-observation weighting,沒有資料可供估計,後者甚至會遇到零分母。方法上的限制不是「所有 paired analysis 都錯」,而是常見的 completed-pair summary 沒有呈現這個 schedule 導致的 positivity gap;Appendix A.3 也說明調整觀察機制不能補回不存在的 companion outcome。
已知失敗與未知結果:cap 是 bounded failure,不是永久無法完成
論文的 outcome 定義很具體:在分配給 continuation 的 K_i = 12 個新 suffix requests 內,若沒有正確 final answer,該 arm 的 bounded outcome 為 0。用完十二次仍沒有答案,是「這個 continuation 在這個 allowance 內沒有完成」的已知 failure。它不代表若給更多 requests,任務仍然永遠答不出來;也不等於模型能力上的 impossibility。另一方面,若 companion 根本沒有 request,它的 outcome 是 unknown,既不能算作 0,也不能算成成功(Section 4.1、Equation 4)。
這個區分能在 27 個 boundaries 上逐項計算。Full 有 14 次已知正確、6 次已知 failure、7 次未執行;projected 有 12 次已知正確、12 次已知 failure、3 次未執行(Section 5.2、Table 3)。同一 pair 的差值定義為 Y_P - Y_F。已觀察到的成功數先給出 12 - 14 = -2 題差;要找最不利於 P 的端點,把 P 的三個未知都當 0、F 的七個未知都當 1,差值再降七題,得到 -9/27。要找最有利於 P 的端點,P 的未知都當 1、F 的未知都當 0,差值增加三題,得到 +1/27。所以本次固定 27-task frame 的差異只能界在 [-33.3, +3.7] 個百分點。
這個 interval 的語義是 partial identification:在不替未執行 arms 編造結果時,所有與觀測相容的 binary completion assignments,能讓全 frame 平均差落在哪個最小至最大範圍。端點都可由某種 unknown assignment 達到。它不是反覆抽樣的 confidence interval,沒有估計部署母體的抽樣誤差,也沒有用統計信賴度保證真值落在其中。它仍然容許 P 多成功一題,同時也容許 P 少九題。論文因此能否定「完成配對平手就代表全 frame 平手」這種推論,卻不能宣稱 projection 在這個框架以外普遍較差或不劣(Appendix A.1、Table 3、Table 6)。
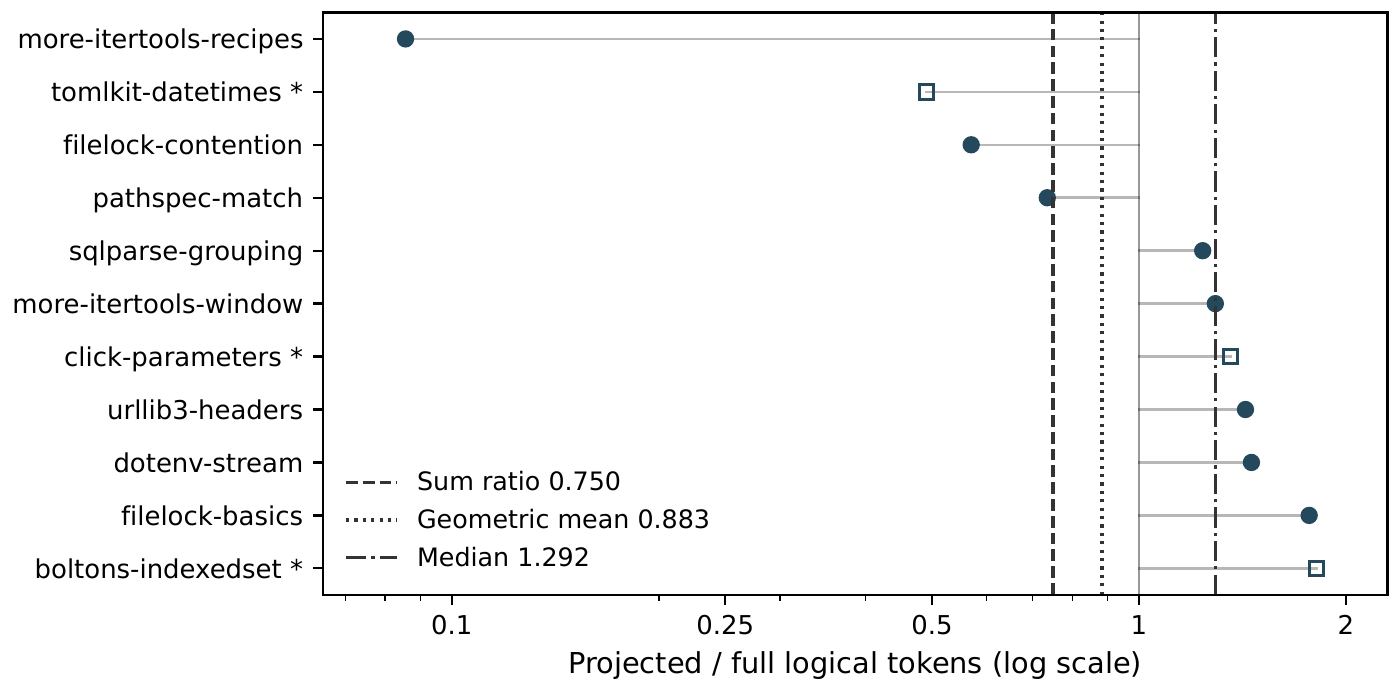
Figure 3(論文 pair-ratios 圖):每一點是 11 組 F 與 P 都答對的配對之 projected/full logical-token ratio,虛線、點線和長短虛線分別標出 ratio of sums 0.750、geometric mean 0.883 與 median 1.292(Section 5.4)。圖上的 1 代表兩邊相同;高於 1 表示 P 使用較多 tokens。空心標記與星號指出 fitting cases。這張圖不能替整個 27-run frame 說明成功率。原始 Figure 3 取自 Zhang, “Completed Pairs Hide Capped Failures,” arXiv v1,圖檔位於 arXiv source archive 的 figures/pair_ratios.pdf;依 CC BY 4.0 重用。
fitting 與 outside-fitting:一個 aggregate tie 仍可能含有選擇偏差
作者還研究一個依歷史 bytes 選擇要跑哪個 arm 的 frozen selector。其候選搜尋使用 36 個規則,最後 threshold 設在 93,641 bytes:歷史長度達門檻便選 projected,否則選 full。門檻由四組已完成 fitting pairs 找出;這四組既參與方法選擇,也是後續已觀察比較的一部分。17 個兩邊 bounded outcomes 都已知的 runs 中,包含這四組 fitting cases,因此 17-run aggregate 不能被包裝成純粹的 held-out test(Sections 3.4、5.3)。
同一個 17-run frame 上,always-full 有 3 次 failure、1,823,900 logical tokens;selector 也有 3 次 failure,但用 1,840,140 tokens,較 full 多 16,240、約 0.9%。這個「錯誤數 tie」受到 fitting rows 影響:在四組 fitting pairs 上,selector 零次 failure、full 一次 failure,差別來自 packaging-compatibility 的 projected 正確而 full 錯;同時 fitting 子集的 selector logical tokens 少 26.3%。
排除四組 fitting cases,看 13 組 outside-fitting observations,always-full 有兩次 failure與 1,419,197 tokens;selector 有三次 failure與 1,541,879 tokens,多 122,682、約 8.6%。新增的一次 failure 是 pathspec-util 被 selector 指派 projected 後用完 cap。這個 split 告訴我們:整體 3/17 tie 不是 outside-fitting 成績平手的證據。但「outside-fitting」也不等於全新、事先保留、未參與 adaptive development 的測試集;這些仍是同一個 campaign 裡累積的 observations(Table 4、Appendix C Table 11)。
外部讀者也不應把 threshold 或 hindsight row 理解為可部署策略。作者在既有 17 runs 上還算出一個 hindsight threshold,以已見 failure 和 token expenditure 尋優;該值剛好等於另一筆 fitting history。這只是同一個 threshold family 對觀測資料的 in-sample reference,既不是公平的未來基準,也不是所有 agent optimization 的上限。更重要的是,任何把 threshold 往上移以避開已知 pathspec-util history 的規則,都是對已知案例再 fit 一次,不能用作獨立確認。
成本結果:aggregate 節省、median 變貴、request 變多可以同時成立
論文另外限定一個完全觀察到的成功層 J:F 與 P 在十二-request cap 內都答對的 pairs。為什麼它不受 companion unknown 影響?十二組停止 boundaries 裡每一組至少有一個 arm 已知為 0,因此不可能在任何補值方式下同時屬於 J。於是 27-run frame 的 J 固定是 11 組,這十一組上的成本對比可被完整觀察。這是目前記錄 coupling 裡的成功 strata;它不是針對未來隨機重跑的 population survivor-average causal effect(Section 4.2、Appendix A.1)。
在這 11 組,full 的 logical token total 是 1,267,036;projected 是 949,774,ratio of sums 為 0.750,也就是 aggregate 少 25%。但每一組 pair 的 token ratio 是另一個分布問題:幾何平均 0.883,median 1.292,有 7/11 組的 P tokens 更高。換句話說,這個分層中總額下降與「典型中位配對比較貴」沒有矛盾。Ratio of sums 會依每個 full pair 的 token 基數加權;一個原本很貴且省幅很大的 pair,對總額影響比一個低成本 pair 大。Geometric mean 用乘法尺度彙整相對變化;median 告訴讀者排序後居中的 pair。三個 summary 不是互相驗證同一結論,而是回答不同問題(Equation 11、Section 5.4、Figure 3)。
值得把影響集中度也一起說明。more-itertools-recipes 的 full continuation 用 9 個 suffix requests,而 projected 只用 1 個,因此它帶來最大的絕對 token saving。把此一 pair 從 aggregate leave-one-out 移除,ratio of sums 由 0.750 改成 1.077。這個敏感度不抹除預先定義 primary analysis 裡的觀測;它提醒我們 aggregate 的 25% 不能脫離樣本構成來閱讀。論文也計算 7/11 個 pair 變多的 two-sided sign reference p=0.55,但由於 tasks 共用來源、frame adaptive,作者不把它當成普遍 harm 的檢定(Appendix C)。
Token summary 以外,互動次數更直接顯示 agent 做了多少工作:P 在八組 pair requests 較多、兩組較少、一組相同,合計 55 對 35,增加 57%。因此,即使 average input per request 縮短,也不能直接推得完成任務的 call 數、wall time 或金錢一定變少。作者記錄的 token 報表把 uncached input、cached input 和 output 拆開;cached input 是 input 的一部分,不能再當成額外 token 費用。P 在 J 上的 uncached input 多 89,684,cached input 少 407,680,output 多 734。可能的解釋包含 request prefix 改寫影響 cache reuse,以及後續 continuation 不同;這些資料沒有把 cache 變化隔離成單一因果機制。
貨幣成本也不能由 token totals 直接讀出。作者沒有公開私有價格表和帳單,所以最多能用 uncached/cached/output 各類 token 代入任意價格,做符號敏感度分析,不能聲稱本次 campaign 節省了多少美元。全 campaign 的 641 requests、8,202,832 tokens 的總量也不應混入 J 的成本比較中;不同 denominator 回答不同問題。這裡數字都只屬於這一個 campaign,不可當成 ReVerPi 或 context projection 的 benchmark 常數(Sections 4.3、5.1、5.4)。
用一個具體例子走完整個方法:archive 找得到資料,agent 仍然沒有答案
論文最具體的例子是 pathspec-util。歷史 bytes 是 94,493,高於 frozen selector 93,641 的 threshold,所以規則選 projected。full continuation 從共同 prefix 後再發三個 suffix model requests,正確回答,suffix 用 84,202 tokens。projected continuation 成功取回 archive 文字:第一次 exact read 有回傳內容,第二次 request 做 search 也找到文字;然而接下來兩次 exact-read 嘗試碰到共用 archive-call quota refusal。之後模型仍繼續查看 source fragments,最後使用完 12 個 suffix requests,沒有 final answer。
在相同 task 的 recorded trajectory 中,projected 用 237,629 suffix tokens;加上 39,539-token common prefix,full 是 123,741 logical tokens、projected 是 277,168。Project 的平均每個 suffix request 約 19.8k,比 full 的 28.1k 少約 29%;但是 P 用四倍 requests,suffix expenditure 是 full 的 2.82 倍。這就是「token-per-request 下降」與「task 有答案前總成本下降」之間的斷點。
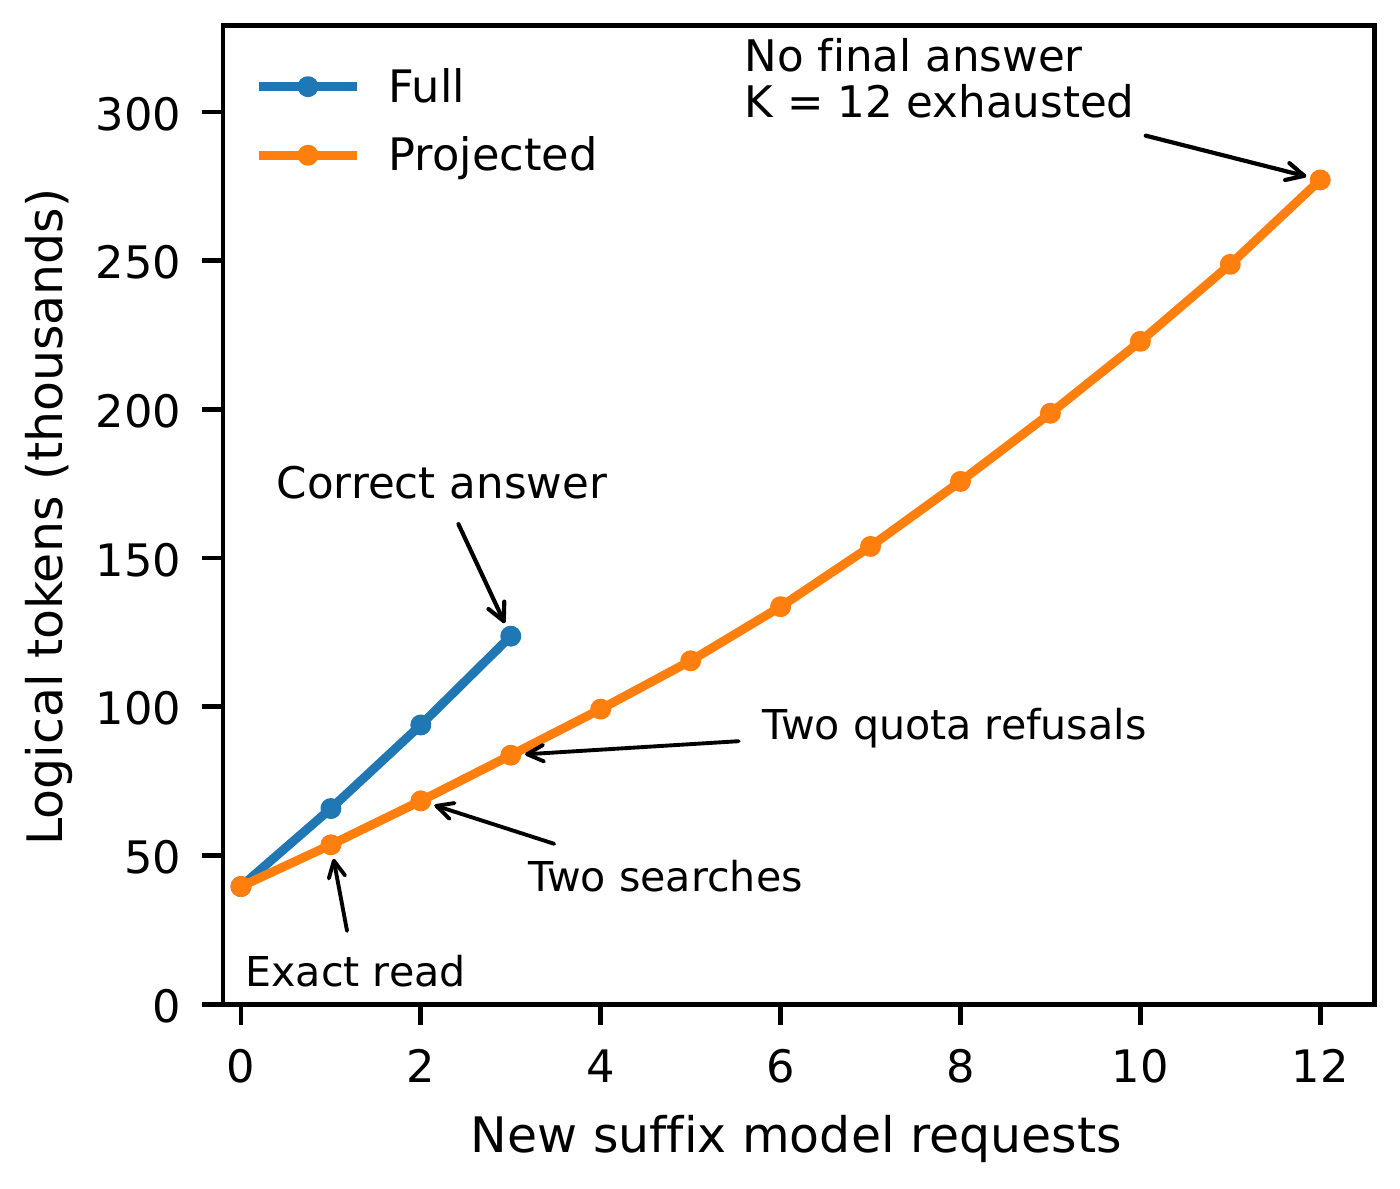
Figure 4(論文 pathspec-util cost trace):兩條線共用同一 capture prefix。Full 在第三個 suffix request 完成正確答案;projected 在前幾次請求成功 exact-read/search,接著遇到兩次 quota refusal,仍持續消耗至 K = 12,且沒有 final answer。此圖支持「本次 projected trace 能讀到 archive 文字,但仍在 cap 內失敗」;它不證明更多 quota 下必然答錯,也不證明取回的片段本身不足(Section 5.5)。原始 Figure 4 取自 Zhang, “Completed Pairs Hide Capped Failures,” arXiv v1,圖檔位於 arXiv source archive 的 figures/pathspec_cost.pdf;依 CC BY 4.0 重用。
這次 quota failure 也暴露 runtime contract 的細節。Recovery tool 把 isError: true 放在 result object 內,但 pinned Pi loop 只有在 execute 丟出 exception 時才把工具呼叫標成 failure。於是 quota refusal 的 payload 在 model-visible output 裡以 isError=false 呈現;短工具結果又受到 projection protection。模型看見停止訊息文字,卻沒有 runtime 結構化錯誤狀態可以強制它停止或改變策略。作者說這個 error-signaling mismatch 在 campaign 結束後由 PR 15 修復;該修正不能倒改這次已記錄的 request trajectory。這個 trace 建立的是 archive lookup 曾成功、quota 後續拒絕、run 到 cap 沒答對;它沒有建立 quota 增加後的假想結果,也沒證明 search 回傳內容不足(Section 5.5、Appendix D、Figure 4)。
另一個必須保留的差別是 storage availability、tool access、task completion 三者不是同一件事。Archive 裡有全文,不代表 agent 已讀到足夠證據;工具一次有回傳,不代表剩下的操作 quota 仍可用;若 search excerpt 已包含答案所需文字,強制多一次 exact read 可能又浪費 quota。讀取失敗應該留下可計量的 request 與 boundary,而不是簡化成「檢索成功所以方法成功」或「有 cap 所以方法永遠不可行」。
證據地圖:這組記錄支持什麼、作者主張什麼、還有哪些未知
| 層次 | 閱讀時應保留的區分 |
|---|---|
| 論文直接支持 | 本次 runner 的 stop rule、27 個 paired/capture boundaries 的觀察狀態、finite-frame bounds、selector 的 fitting split,以及 11 組共同正確 pairs 的成本分布。 |
| 作者主張 | 完成配對摘要會隱藏部分 bounded failures;應保留每一個介入邊界,並將已配置的 continuation 分別執行與報告。 |
| 證據不支持 | 其他 benchmark 的偏差盛行率、母體 superiority/noninferiority、將 token totals 換算為美元節省,或 projection 對所有 agent 任務的普遍影響。 |
| Bloss0m 工程判斷 | 把 allocation、stop reason、outcome status 與 estimand 對應到可稽核欄位;這是本文的工程化整理,不是作者驗證過的通用標準。 |
| 觀測範圍 | 可以說 | 不能偷換成 |
|---|---|---|
| 15 組 completed pairs | 每個 arm 在被保留下來的 15 組中各有 12 組正確。 | 所有已分配介入的整體成功率相同。 |
| 27 個 paired/capture boundaries | 在已記錄 frame 中,P-F 成功差 bounded 為 -9 至 +1 題;cap 的已知失敗與未執行 unknown 分開處理。 | 母體 superiority/noninferiority、普遍偏差比例,或 missing outcomes 的機率模型。 |
| 17 組兩邊 outcome 均已知 | frozen selector 與 always-full 都有 3 failures;前者多 0.9% logical tokens。 | 未見資料上的泛化平手;這 17 組含 fitting cases。 |
| 13 組 outside-fitting | selector 比 always-full 多一個 failure、多 8.6% logical tokens。 | 完全獨立 holdout 結果;它們仍來自 adaptive campaign。 |
| 11 組 jointly correct | P 的 aggregate logical tokens 少 25%,median 多 29%,requests 多 57%。 | 全體成功率、成本到成功、美元成本或部署預期值。 |
綜合來看,作者最強的實證貢獻是把程式控制流程與 estimand 連起來:若 runner 在 first arm cap 後直接停止,那個 schedule 使 companion outcome 在相應 strata 完全不可見;事後只對 first outcome 做 regression 或 observation adjustment,不能憑空補出被 schedule 永遠隱藏的 counterfactual。最保守且資訊保真的做法,是明確標記 known success、known bounded failure、unknown,然後對 fixed finite frame 報告所有 compatible outcomes 的 bounds(Sections 3.3–4.2、Appendix A)。
它沒有證明所有 paired benchmarks 都無效。十個 first-arm caps 是本次 runner 的排程事實,不是其他系統的普遍 prevalence;27 個 boundaries 也不是對 agent task population 的隨機樣本。順序由 hash parity 在 source group 中輪替,雖讓 order 看起來平衡,卻不是獨立隨機 assignment。任務問題由研究者依套件來源逐步發展,每個 arm 只得到一條 stochastic continuation。模型名稱和 usage 是 provider 回報的 proxy label,無法驗證後端 weights。Read-only source adapter 有 allowlist,但不是完整 Pi 產品的 adversarial sandbox。主要得分依舊是 historical first-decodable-JSON contract;更嚴格 whole-object sensitivity 每臂多一個失敗,frozen selector 的相對比較不變(Section 6、Appendix C)。
作者也分析 single-arm integrations、重複 task 的 history bytes 變化、threshold sensitivity、zero-event calibration 參考值、source inventory 和資料 integrity。這些附錄材料幫忙界定個案,不把新的 deployment claim 引進 headline。尤其 calibration appendix 的 fixed-sample formula 依賴獨立 Bernoulli 假設;adaptive、complete-case campaign 不會因為重算公式就取得 population risk guarantee。Source digest 能支援檔案一致性檢查,卻不能證明歷史事件的時間順序、provider backend 或實際帳單(Appendix A、B、C、E、F)。
Bloss0m 工程判斷:把 runner 的 stop rule 當成實驗變數
以下是 Bloss0m 根據本文分析整理的工程判斷,不是作者宣稱已實證的普遍 benchmark 標準。若你在設計 paired evaluation,先把 runner 的可觀測狀態建模成一級資料:每個分配 arm 都有 allocation id、啟動狀態、每種 cap、停止原因、完成狀態與是否執行;完整 pair 是結果類別之一,不能成為唯一寫入結果表的條件。
- 分開 schedule 與 outcome:在權限、資料完整性與環境安全條件允許時,將兩個 arms 的預算分開預留與執行。若合理 cap、invalid environment 或 revoked permission 必須停止,保留未執行標記和具體原因,不要把 companion 從分母消失。
- 同時回報 opportunity 與 answer:eligible boundary、request opportunity、completion、correctness、failed attempt 與 unknown outcome 都應有對應計數。先前階段未達介入資格的 runs,也要與 intervention boundaries 分列,避免讀者以為所有 submitted runs 都實際接受了 treatment。
- 先決定 estimand 再選摘要:固定 cap 內完成、最終答案正確、成功條件下的 token cost、每 pair median、aggregate spend 是不同 estimands。先說哪一個在決策中重要,再選 denominator 和聚合方法。
- 對 adaptively chosen selector 保留 fitting lineage:列出 selector 選擇前用過哪些 task、threshold 如何挑選,以及所謂 outside-fitting samples 是否真的是事前保留。避免讓開發資料上的 tie 看起來像獨立評估。
- 讓 resource failure 可見:controller cap、archive-call quota、provider request cap與 task deadline 要拆開記錄。quota error 應同時以 structured status 和 model-visible signal 傳達;後續 controller 不可只看文字訊息猜工具是否失敗。
作者在 Discussion 主張,對已封存 boundary 應盡量分別執行兩個預先配置 continuation,而不是因第一邊的普通 cap failure 就不跑 companion;permission revoked、integrity fault 或不安全環境仍可構成合法 stop condition,但 unresolved outcomes 必須保留。這是論文從記錄到 protocol 的直接建議;上面將 allocation id、estimand 分表、lineage 等整理成工程資料模型的部分,則是 Bloss0m 的 synthesis(Section 6)。
什麼情況下不應直接採用這篇的判斷
如果你想用它宣稱某種 context compression 一般更省 token 或更省錢,證據不夠:成本數字限定在 11 組共同正確 cases,aggregate 又高度受一個 pair 影響,而且 token price schedule 與 invoice 缺失。如果你想把 -9/+1 當成新產品的預期差距,這也不對:finite-frame bound 只屬於 27 個已記錄 boundaries。若你的 runner 停止原因是安全、權限或資料損壞,而不是普通資源耗盡,盲目強制執行 companion 可能違反實際約束;正確做法是保留未觀察狀態並在論文可比性或安全政策中說明。最後,如果你沒有相同 capture prefix、同一 request cap、同一 task protocol 和原歷史的 private provider records,就不能宣稱重現了作者的 provider-backed campaign。
Artifact 與可重現性
截至 2026-09-29,作者的 ReVer_Pi GitHub repository 公開 MIT 授權程式碼、tests、pinned dependency files、mock configurations 與 scripts/offline-smoke.sh。README 說明這條 smoke path 用 protocol-only mock,從 loopback gateway 經 session、Pi extension 到 ledger,無需 API credentials 或外部 provider calls;它適合確認 repository wiring,不能重現論文的模型表現或 86-run campaign。真實 provider path 是另一個需明確配置且涉及付費 API 的步驟。
另外,arXiv v1 source archive 附有 anc/ analysis inputs、scripts、example task/observation 與 data digests,可支援重算已發表表格與圖;figures/ 也包含五張原始圖。它沒有提供完整 raw provider request/response、private configuration、session/ledger database 或 invoices。論文自述 repository/supplement 可重現 paper calculations,這不等於能獨立重播 private provider service。本文的數字均為作者報告結果,沒有進行獨立 provider-backed rerun。程式碼可下載與研究結果可完整重現,是兩項不同聲明(Section 1、Appendix E;repository README、Getting Started)。
延伸閱讀
- SWE-Bench ProMax:Agent benchmark 的 trajectory 與成本讀法:接著看 evaluation frame 與 agent outcome 的設定如何影響數字。
- Agent 工具呼叫成功卻工作流程失敗:把 unknown outcome 從 benchmark runner 延伸到外部副作用與 runtime contract。
- SilentProbe:Agent 工具 API 的靜默失敗:檢查 tool response 本身是否可靠;本篇則聚焦 response 以外的排程與未觀察分支。
讀完後的三個記憶點
- 技術想法:completed-pair filter 不是單純整潔化表格;當 runner 在 first-arm noncompletion 後省略 companion,它會選擇可觀察到的結果。
- 證據:本次 campaign 的 15 個 completed pairs 顯示兩臂各 12/15 正確;保留 27 個 boundaries 後,projected-minus-full success 只能 bounded 為 -9 至 +1 題。
- 適用邊界:aggregate token reduction 可能與更高的 median pair cost、更高的 request count、known cap failures 和 unknown companions 並存。這些是本次設定下彼此不同的事實,不是全體 agent 的普遍定律。
Primary sources
- Guangzhe Zhang, “Completed Pairs Hide Capped Failures: A ReVerPi Case Study of Selective Context Projection,” arXiv:2609.31381v1, 2026-09-25. 本文的主要 anchors:Sections 3.1–3.4、4.1–4.3、5.1–5.6、6;Figures 2–4;Tables 1–6、8–12;Equations 2、4–5、8–11;Appendices A–F。
- arXiv v1 PDF and source archive, licensed on the source page under CC BY 4.0.
- ReVer_Pi repository and its MIT license.