90 秒掌握論文
- 問題:Agent 呼叫第三方 API 時,空結果可能代表「真的沒有符合條件的資料」,也可能代表 server 沒看懂 filter、把它丟掉,卻照樣回傳 HTTP 200 與可解析的 JSON。兩者都沒有 exception、錯誤 status 或可供 branch 的欄位。
- 核心洞見:要拆成兩個獨立問題。Disclosure 問模型能否從說明中選出 vendor 接受的 vocabulary;machine-readability 問 validator 能否在 request 離開前拒絕錯值。只有後者能被通用基礎設施強制執行。
- 最強證據:公共 OpenAPI corpus 的 721,320 個 parameter leaves 中,只有 7.5% 宣告 enum、15.2% 宣告任一 machine-checkable constraint,40.1% 的文件至少有一個 prose constraint gap。219 個 live perturbations 則顯示 machine-checkable 組是 111/111 honest errors,prose-only 組有 44/61 silent failures(Section 4.1–4.2、Figure 5)。
- 主要邊界:在三個 parameter 的 agent experiment 中,description 只舉例 1/18 個 department 值時,12 個模型在 88/88 次都選到無效 vocabulary;把相同 vocabulary 提升成 enum 後是 0/89 silent failures。這是介面與測試 harness 下的證據,不是模型或所有 production API 的普遍定律。
我的 bounded verdict 是:SilentProbe 最有用的修正點不是換一個更強的模型,而是把「哪些值合法」寫進可檢查的 schema,並把 zero-row filtered result 當成需要驗證的觀測。 這一行 enum 同時改變模型 generation 與 gateway validation;但它不能修復 vendor 自己的錯誤、無法觀察的 semantic downgrade,也不能把 read-only 結果推廣成 write API 的安全保證。
版本、來源與讀者問題
本文讀的是 SilentProbe: Measuring Silent Failure in Production APIs Used as Agent Tools v1,arXiv 顯示於 2026-08-29 提交,作者為 Zongrong Li、Shengkun Ye、Feiyou Guo 與 Zuoyou Dang。這是 arXiv preprint,未經同儕審查;本文保留 paper 的條件句、排除項目與 lower-bound 說法。我核對了完整 arXiv HTML、v1 PDF、Introduction、Related Work、Methodology、Results、Discussion、Conclusion,以及 Appendices A–G 的 reproducibility、perturbation families、recovered vocabularies、per-vendor outcomes、prompt templates、verbatim answers 與 retry traces。
我也獨立檢查了作者的 SilentProbe MIT repository:公開 probe/ measurement code、data/ schemas/records/transcripts、out/ reports 與 paper/ LaTeX/figure source 均存在;default branch 只有一個公開 commit。Repository 的 MIT LICENSE 明確涵蓋 code,但 README 只寫 data released for research use,沒有找到獨立的 data license,因此本文不把資料集當成沒有條件的 unrestricted reuse。
這篇文章的讀者問題是:當 API 把「沒找到」和「沒理解」都包成 HTTP 200 時,哪一層應該負責把錯誤變得可見:模型、schema、gateway,還是整個 agent loop? 這個問題可以接在 Parsing the Stream 的 live trace 觀測、Tool Call 與 Workflow Boundary 的外部效應分析 與 partial-answer stopping controller 後面讀:前兩篇處理執行證據與 boundary,後一篇處理 agent 何時停止;SilentProbe 先問 tool 回應本身是否誠實。
證據地圖:Paper、Evidence 與 Bloss0m judgment
| 層次 | 本文採用的說法 |
|---|---|
| Paper 直接支持 | 兩個 corpus 的 constraint-form audit;三呼叫 differential probe;silent empty、silent drop、silent coercion 與 semantic downgrade 的失敗型態;12 個模型的 As-Is/Lifted experiment;192 個 full loops 的 downstream labels;limitations 與 reproducibility appendix。 |
| 作者主張 | constraint form 比 vendor identity 更能預測 malformed call 是否誠實失敗;prose 中完整揭露的 vocabulary 通常能被模型使用;把 vocabulary 提升成 enum 能在測試設定中消除主要 trap。 |
| Evidence 沒有建立 | 所有 production API 的 silent-failure prevalence、所有模型的普遍失敗率、schema promotion 能修好 vendor semantic defect、write/authenticated/streaming tool 的安全性,以及模型升級必然不如 schema 修正。 |
| Bloss0m 工程判斷 | 把 schema gap audit 放進 CI;對 filtered zero-row result 追蹤 intent、request vocabulary、validator outcome 與 retry;若沒有 response-level evidence,就把回答降級成「資料庫回傳零筆」而非「世界上沒有」。 |
Paper Essence Contract
- 它要解決什麼問題? 它要量測 production-style API 在 request 結構合法時,如何因為 vocabulary 或 format 沒被理解而回傳看似成功、實則回答另一個問題的 response,並追蹤這件事如何影響 agent 與使用者。
- 為什麼既有做法不夠? 傳統 API/tool benchmark 多半假設 environment honest;simulator 依文件生成 response,無法自然產生「文件沒有寫出的 omission」;模型自己的 synonym retry 也沒有新的 vocabulary 證據可供收斂。
- 核心技術想法是什麼? 先把 published schema 與 prose 說明做靜態 gap audit,再對同一 parameter 做 base、valid、perturbed 三次 differential comparison,最後把真實 response 餵回多模型 agent loop,並做 enum-lift intervention。
- 它依賴哪些概念與假設?
machine-checkable指 enum、pattern、format 或 numeric bounds;prose-only指 constraint 只存在 description;probe 假設 baseline 可以重複、valid value 真的改變結果、結果能用 count 與前五筆 row identity fingerprint 比較;執行階段依賴 Monid 的統一 schema、validator、run ID 與一個 key。 - 一個 input 怎麼走? 自然語言 task 先被模型映射成 tool arguments;gateway 依 schema 決定是否拒絕;通過的 request 到 vendor 後可能回傳 honest error、正常化結果、silent empty、silent drop 或 silent coercion;full loop 再將 response 送回模型,直到回答或最多四輪。
- 什麼證據支援 headline claim? Table 2 的兩個 corpus、Figure 5 的 constraint-form outcomes、Figure 6 與 Figure 7 的 disclosure/enum intervention、Figure 8 的 user-facing outcomes,以及 Figure 9 對 public standard、closed list 與 example-only 三種 regime 的比較。
- claim 在哪裡停止? 靜態 prevalence 的範圍是 public OpenAPI corpus;live execution 受 Monid reachable、read-only、低價、可合成 input 限制。42 個 inert parameters 可能含有永遠被丟棄的 filter,vocabulary 是 brute-force lower bound,semantic downgrade 則不在 removal differential 的可見範圍內。
這篇到底在解哪個問題:同一個 200 可以代表兩個世界
先看論文 Introduction 的核心區分。假設使用者問:「找出美國公司中 headcount 在 51–200、seniority 是副總裁的人。」如果 API 接受 seniority=vp 與 employees_range="51,200",它回傳 28,417 筆;這可以是符合 request 的資料。可是下列三個 request 仍然都拿到 HTTP 200,沒有 error field:
| 呼叫 | seniority | employees_range | 結果 |
|---|---|---|---|
| 1 | vp | "51,200" | 28,417 |
| 2 | vice_president | "51,200" | 0 |
| 3 | vp | "51-200" | 160,884 |
| 4 | vp | omitted | 160,884 |
Row 2 是 silent empty:vice_president 是合理的英文 synonym,卻不在 vendor vocabulary;API 把它當成可接受的 string,結果讀起來像「真的沒有副總裁」。Row 3 則是 silent drop:錯誤的 hyphen format 被丟掉,結果與省略 filter 的 Row 4 完全相同。這個 equality 是 differential evidence:request 看起來含有 headcount constraint,但 server 實際回答的是沒有該 constraint 的問題。
還有兩種不能混成同一類的型態。Silent coercion 是 server 把不符合預期的值重新解讀成另一個值;semantic downgrade 則可能發生在模型端,例如使用者說 certified pre-owned,description 只寫「used or new」,模型選 used,API 回傳非空且看似合理的資料。後者不會被單純的 removal differential 捕捉,因為結果既不是空的,也不像 base call;必須拿 caller intent 和回傳內容做語義比較。
既有方法為什麼不夠:環境的 omission 不會自己變成 exception
很多 tool-use benchmark、API simulator 與 robustness 評估都把「response 是否符合已知 contract」當成環境前提。論文 Related Work 的批評很精確:如果 simulator 依 documentation 生成 response,那份 documentation 不會描述自己的 omission;因此它不會自然產生 server 接受未知 vocabulary、忽略 filter、仍回傳成功的情境。這不表示 simulator 沒有價值,而是它無法測量這個特定 failure class。
API owner 的一般建議「遇到 4xx 就 retry」也不夠。這篇 paper 測的是另一個更麻煩的 case:request 通過所有可用 validation,vendor 回傳 200。模型不能從 status code 得知 filter 是否生效,自己再試 synonym 也未必有機會碰到 vendor 的內部 vocabulary。Repository 的 retry traces 顯示,information_security → security → cybersecurity 可以連續得到零筆;另一條 trace 甚至在放棄 filter 後拿到 42,619,384 筆未過濾資料,讓 repair strategy 自己製造了 silent drop。
所以 prior limitation 不是「模型太笨」,而是 contract 把應由 validator 強制的資訊留在自然語言裡,或根本沒有區分「zero matches」和「filter unsupported」的 response state。模型可以猜,gateway 可以檢查 schema 寫出的規則,但任何一層都無法憑空執行 description 裡沒有結構化的 vocabulary。
核心直覺:Disclosure 與 machine-readability 是兩個控制點
把模型和 validator 想成兩個不同的消費者:模型負責把使用者意圖翻成參數值;validator 負責在 request 送出前拒絕不合法值。這兩個控制點的輸入不同。
- Disclosure 影響模型能否選到合法值。若 description 寫出完整 closed list,例如
valid, accept_all, unknown,模型能在普通英文 task 中對應到 vendor vocabulary;若 description 只寫e.g. executive,模型被告知一個例子,卻不知道其餘 17 個合法值。 - Machine-readability 影響錯值能否被通用基礎設施攔下。
enum不只提示模型,也讓 schema validator 可以回傳「expected one of …」;prose-only constraint 沒有可供 generic validator 執行的邊界。
這不是把 enum 當作萬靈丹。enum 也不保證模型一定服從:Lifted condition 下 395 次 call 仍有 3 次送出 enum 外的值。因此要分辨兩個效果:enum 可能在 generation 時降低錯值,也可能在 validator 階段把漏網值變成 actionable error。只靠 prompt 不能提供第二個效果。
用一個例子走完整個方法:從 task 到可判定 verdict
下面沿用 paper 的 people-search seed endpoint 與 Figure 2 的 differential design;不是額外的產品案例。
- Input:自然語言 task 要找 US companies 中的 engineers,最多回傳 3 rows。模型從 prose-only description 推導
department=engineering,但該 vendor 的 recovered vocabulary 實際接受it、hr、sales等值,未必接受engineering。 - Intermediate representation:研究者為被測 parameter 準備三個 call。 是 base call,且立即重複一次; 是 base 加一個已驗證會改變結果的 valid value; 是 base 加一個 schema-derived perturbation,例如 synonym、case、format variant 或 out-of-vocabulary token。
- Decision:計算每個 response 的 signature。若 被 gateway 或 vendor 拒絕,就是 honest error;若 是空而 非空,就是 silent empty;若 與 的 signature 相同,就是 silent drop;其餘重新解讀的結果歸為 silent coercion。
- Output:研究者得到一個能定位 failure 的 verdict,而不是只看單一 HTTP 200。接著把真實 response 餵回 agent,記錄它是否 retry、是否修復、最後告訴使用者什麼。
- Likely failure point:模型可能輸出合理但未被 vendor 使用的英文詞;gateway 只看到 schema 是 generic string,於是放行;vendor 回傳空 JSON array;agent 可能把它改寫成「沒有 engineers」。
這個流程的重要性在於,單一 response 不足以判斷 filter 是否生效。sig(B)=sig(C) 的 removal equality 需要 base、valid 與 perturbation 的對照;如果 endpoint 會漂移,研究者也必須先用 repeat calibrate noise,否則會把資料變動誤判成 silent coercion。
方法機制:三個 instrument 接成一條 evidence chain
論文不是只跑一次 fuzzing,而是按順序使用三個 instrument:免費 static audit、live differential probe、以及將真實 response 回送給模型的 full agent loop。研究資料有兩個來源:Monid 可統一呼叫的 endpoint pool,以及 APIs.guru 的公共 OpenAPI corpus。模型則透過 OpenRouter 統一存取十二個 model、八個 model families。
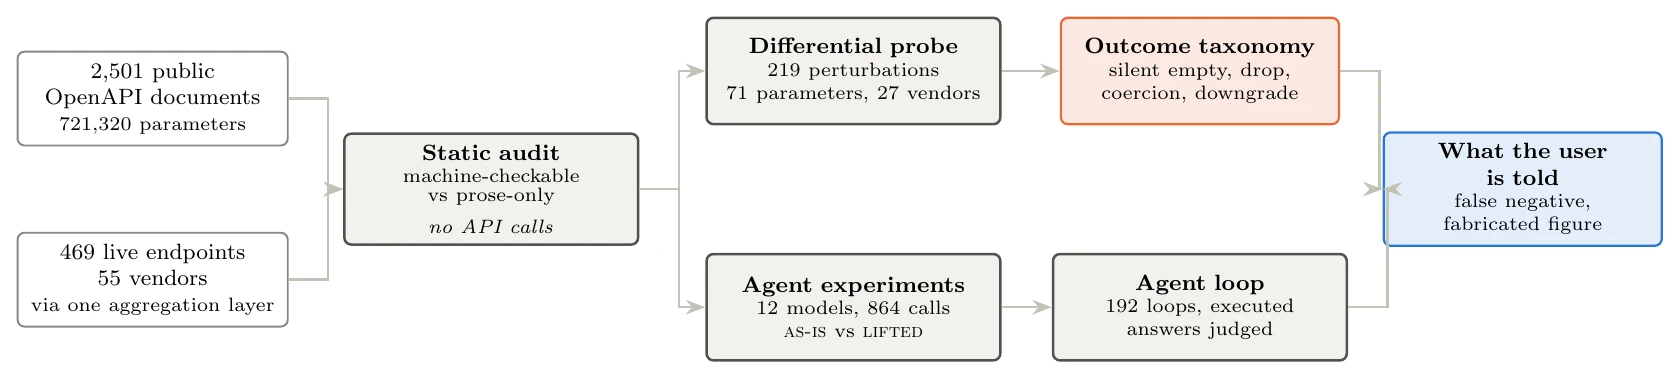
圖 1(原論文 Section 3,Study overview):讀者要注意 static audit 不發 API call;只有後面的 differential probe 與 agent experiments 會執行 live endpoint,而每次 call 都有可重新取得的 run identifier。原始 Figure 1 anchor · 原始 figure source。授權/版權:arXiv HTML 頁面標示 CC BY 4.0;本文將 repository 的原始 PDF 轉成 WebP,未改動圖中的研究流程或數值。
Static audit:先問 constraint 寫在哪裡
研究者走訪 JSON Schema 的每個 scalar leaf。若 leaf 宣告 enum、pattern、format 或 numeric bounds,就算 machine-checkable;若 conservative pattern matcher 在 description 找到 controlled vocabulary、format 或 numeric bound,卻沒有對應 schema keyword,就算 documentation-constraint gap。這個分類只依 published artefacts,完全不發 API call。
公共 corpus 有 2,501 份 OpenAPI documents、79,539 個 provider/operation 與 721,320 個 parameter leaves。只有 7.5% 宣告 enum,6.6% 宣告 pattern/format,1.1% 宣告 numeric bounds,合計 15.2% 有任何 machine-checkable constraint;29.4% 甚至沒有 description。更高層的文件比例是:40.1% 至少有一個 prose gap。
Monid aggregation-layer audit 則有 469 endpoints、55 providers/operations 與 1,966 leaves;20.9% 的文件至少有 gap,enum 比例 13.1%。Per-leaf prose-vocabulary rate 在兩個 corpus 也不一致:2.4% 對 0.3%。作者沒有把它硬寫成可互換的 prevalence;他們指出 public corpus 可能較多由 source code 生成,而 hand-written agent-facing interface 更容易用 prose 敘述 vocabulary。這是 scope limit,而不是可以忽略的噪音。
Differential probe:用三次 call 把 200 拆開
令 response signature 為:
是共用的 base call,立即發送兩次; 是加入 parameter 的 valid value; 是加入第 個 perturbation 的 variant。其他欄位固定,才能把結果差異歸因到一個 parameter。
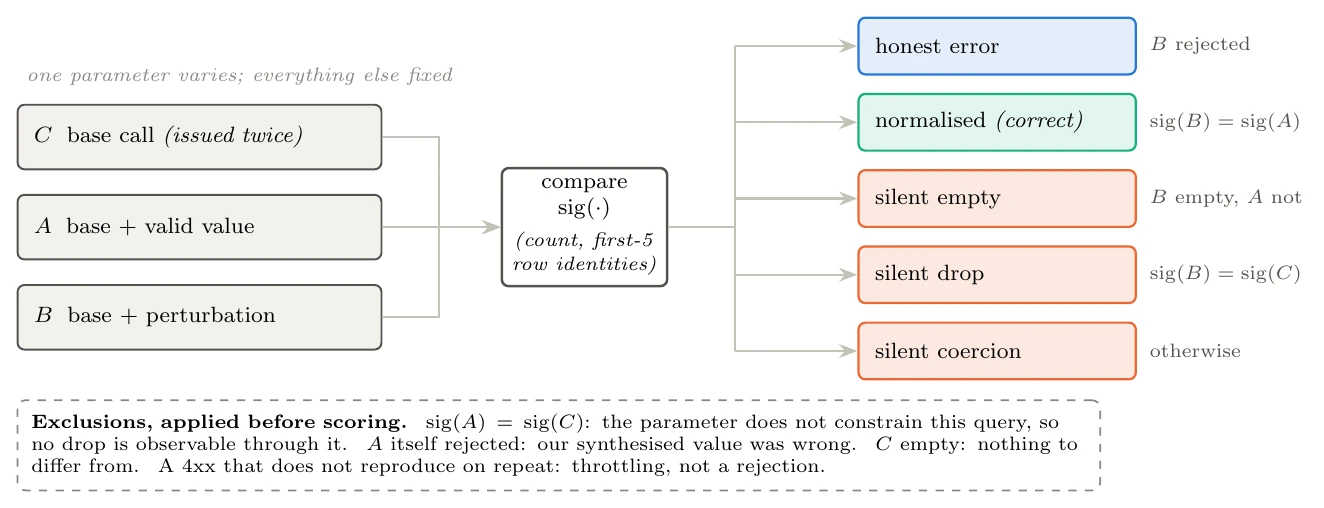
圖 2(原論文 Section 3.3,Differential probe):讀者要注意 sig(B)=sig(C) 才能指出 filter 被接受卻被丟掉;單一 200 response 本身沒有這個證據。圖中五種 verdict 是 honest error、normalised、silent empty、silent drop、silent coercion。原始 Figure 2 anchor · 原始 figure source。授權/版權:arXiv HTML 頁面標示 CC BY 4.0;本文保留原圖內容並只做 PDF-to-WebP 格式轉換。
分類規則要和限制一起讀:
- 被 gateway 或 vendor reject → honest error。
- → normalised,表示 perturbation 被正確正規化,不算 failure。
- 為空、 非空 → silent empty。
- → silent drop,代表 parameter 沒有貢獻。
- 其他不同於 與 的 response → silent coercion,表示 server 以另一種方式解讀值。
研究者用四個 control 防止過度計數。若 ,parameter 被列為 inert 而不是當作 pass;若 valid value 自己就被 reject,該 parameter 被丟棄;base call 為空也不適合做差分;base repeat 會用 endpoint-specific tolerance 量測自然漂移。另有 vendor 會用 bare HTTP 400 做 throttling,因此每個 4xx 都要 pacing 後重試確認,不能把自己的 request rate 當成 endpoint rejection。
實驗如何讀:先分母,再看圖
Evidence 1:constraint gap 的公共 corpus 範圍
Figure 4 與 Table 2 的重點不是「所有 API 都不可靠」,而是 validator 可見的規則在公共文件中很少。721,320 個 leaves 裡 15.2% 有 machine constraint,84.8% 沒有任何 validator 可執行的 constraint;40.1% 的文件至少含一個 prose-only gap。這支持「schema expressivity 是可先於 live call 檢查的風險訊號」,不支持把 40.1% 直接當作 silent failure rate。Per-leaf prose vocabulary 2.4% 對 0.3% 沒有 replicate,作者將其視為 corpus composition 的警告。
Evidence 2:constraint form 是否預測 honest failure
研究者對 135 個 parameters 做 probe,其中 42 個因 inert、22 個因 valid value rejected 而排除,剩下 71 個 parameters;共執行 219 個 perturbations,跨 27 vendors。Figure 5 前還排除 11 個 rate-limited、47 個沒有 signature 也沒有 error、以及 5 個 baseline drift endpoints 的 37 個 perturbations。最後,machine-checkable 組有 111 個 scored perturbations,全數 honest error、沒有 silent failure;prose-only 組有 108 個,其中 47 個 normalised、17 個 honest error、61 個真的改變結果,後者有 44 個 silent failure。
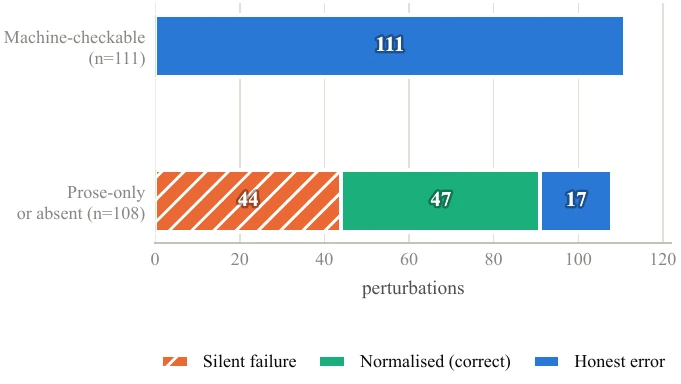
圖 5(原論文 Section 4.2,Outcome by constraint form):讀者要注意 headline denominator 是排除 normalised 後的 111 與 61;不是把 prose-only 的 47 個正常化 response 也算成 failure。Machine-checkable 是 111 個 honest errors,prose-only 則是 44 個 silent failures、47 個 normalised、17 個 honest errors,Fisher exact 。原始 Figure 5 anchor · 原始 figure source。授權/版權:arXiv HTML 頁面標示 CC BY 4.0;本文使用原始 figure 的 plotted result,未自行重繪或新增數值。
「honest」還有第二層。113 個 gateway rejections 都能指出 offending parameter 並列出合法值;14 個 vendor rejections 只有 Invalid input: HTTP 400。因此 machine-checkable constraint 不只降低 silent failure,也提高 error message 的 actionable 程度。這裡的結論仍是條件式:110/111 個 machine-checkable honest errors 由 Monid validator 提前提出,這解釋了為什麼 aggregation layer 是測量機制的一部分;它沒有證明每個 gateway 都會如此嚴格。
Evidence 3:模型是怎麼走進 trap 的
Agent experiment 讓十二個模型讀 ordinary-English tasks,並透過 OpenRouter 呼叫 live endpoint;沒有 simulator。研究者讓三個被測 parameters 都維持 prose-only,差別只在 description 寫出多少 vocabulary:department 只出示 1/18 個值,verification_status 與 seniority 各寫出 3/3 個值。
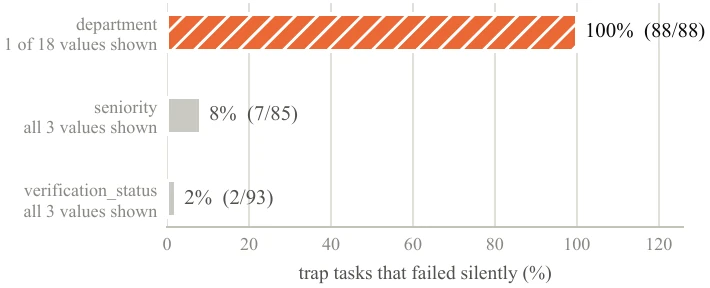
圖 6(原論文 Section 4.3,Disclosure decides whether the model can comply):讀者要注意三個 parameter 都沒有 schema constraint,所以圖中主要改變的是 prose coverage;example-only 的 department 在 88/88 次 trap tasks silent fail,完整列出三個值的兩個 parameter 則是 9/178。原始 Figure 6 anchor · 原始 figure source。授權/版權:arXiv HTML 頁面標示 CC BY 4.0;本文保留原始 bar chart,未把其比例解讀成所有 model 的 production rate。
整個 study 有 864 次 attempts,815 次真的產生 tool call,799 次可計分;Llama-3.3 有 44/72 次 abstain,作者把它保留為 abstention 而非硬塞進 failure denominator。部分揭露對完整揭露是 88/88 對 9/178,Fisher 。這使作者得出一個比「模型不會用 enum」更精確的判讀:模型通常能遵守它看見的 closed vocabulary,但不一定能從單一 example 推回 vendor 的隱藏 set。
Evidence 4:enum intervention 的作用與殘餘
同一個 partially documented department parameter,只修改 schema,把 recovered vocabulary 提升成 enum;task、model、endpoint 與其他 tool fields 維持一致。As-Is 的 88/88 silent failures 變成 Lifted 的 0/89,Fisher 。另外兩個本來已完整寫出 vocabulary 的 parameters,As-Is 已是 2/93 與 7/85;Lifted 後是 0/90 與 1/86,作者把它們視為相對應的 null/小效果,而不是把 enum 的效果誇大成每個 endpoint 都會改善。
Figure 7 再按 model 拆分:11/12 個有足夠可計分資料的模型,在 As-Is 約 8–10/24 trap failures,Lifted 都降到 0;Llama-3.3 因大量 abstain 被排除。Lifted 的 395 次 call 仍有 3 次送出 enum 外的值,所以 enum 是 hint 加 validator boundary,不是 model obedience guarantee。
Full agent loop:空結果如何變成使用者收到的錯誤
Exposure 不等於 harm。研究者把 model call 的真實 response 送回模型,最多允許四輪,再用不同於被測模型的 judge 讀 final answer。192 個 full loops 中,94 個以 zero-row response 結束;只有 11/94 會在回答前換一個 value retry,而這 11 次沒有任何一次找回 non-zero result。
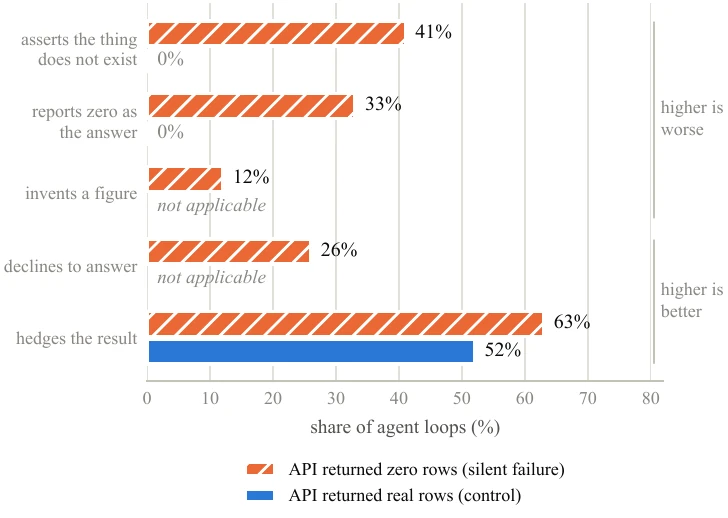
圖 8(原論文 Section 4.4,What does the user get told?):讀者要注意 control loops 的 query 落在已知 vocabulary 且有真實 rows,trap loops 才能用來辨識 silent zero 的 downstream harm;trap 組有 41% assert absence,control 組是 0%。原始 Figure 8 anchor · 原始 figure source。授權/版權:arXiv HTML 頁面標示 CC BY 4.0;本文保留原始比較圖與 control 定義,未把 hedging 當成 recovery。
結果需要同時報告好看與不好看的部分:silent failure 後模型偵測到問題是 12%,修復是 0%;41% 把 false negative 告訴使用者,28% 是完全沒有 hedge 的 false negative,12% 從 parametric memory invent a figure。另一方面,多數回答有 hedge,因此「Agent 一定會把零筆說成世界上沒有」不是 paper evidence。作者的更窄結論是:hedging 不是 fix,它只是把缺少 endpoint evidence 的判斷責任轉交給資訊更少的使用者。
一條 retry trace 也說明為什麼自動修復不一定有效:模型嘗試 information_security、security、cybersecurity,每次都得到 0;它只能在自己已知的 synonym neighbourhood 裡搜尋,無法從 response 反推出 vendor 的 accepted token it。因此「再問一次」若沒有新的 vocabulary evidence,可能只是反覆重播同一個未知。
主要邊界:沒有 silent empty,不代表 interface 沒問題
作者把 agent experiment 複製到另外兩個 vendor,共 384 attempts、355 tool calls,沒有得到任何 silent-empty。這不是把 replication 當成失敗,而是用來定位 boundary。Figure 9 的三個 regime 很重要:
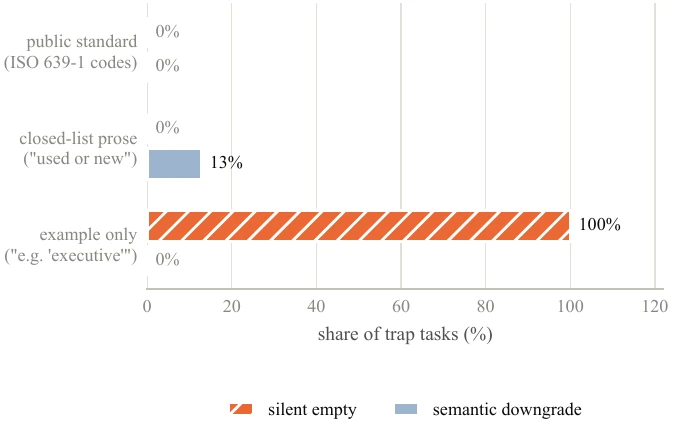
圖 9(原論文 Section 4.5,Where the effect stops):讀者要注意 example-only 產生 silent empty;closed-list 避免 invention 卻可能造成 semantic downgrade;public-standard vocabulary 因模型已知而兩者皆無。原始 Figure 9 anchor · 原始 figure source。授權/版權:arXiv HTML 頁面標示 CC BY 4.0;本文使用原始 figure,並保留它對方法盲點的說明。
- Public standard:某 endpoint 沒有列 language values,但模型都送 ISO 639-1 的
en、es、fr;它們是 common knowledge,所以沒有測得 failure。 - Closed list:
Vehicle condition: used or new看起來像完整清單,模型在 certified pre-owned task 中 23/23 次送used;回傳 21 筆 plausible rows,卻不是使用者要求的 certified pre-owned。這是 semantic downgrade,不是 silent empty。 - Example only:
Person department(s), e.g. executive只給 1/18 個值,88/88 次都送出無效 department vocabulary,得到 silent empty。
這個結果把 claim 收窄得更可靠:enum 能修復主要的 example-only trap,但如果 server 即使收到合法值也回傳錯資料,schema lift 不能解決 vendor defect;如果模型把更弱的合法值當成使用者要求,單純 removal differential 也看不出來。這個方法測量的是 response-level semantic honesty 的一部分,不是完整的 intent correctness oracle。
Ablation、失敗模式與什麼真正驅動結果
1. Disclosure 和 machine-readability 不是同一個 ablation
Figure 6 比較的是三個都 prose-only 的 parameters,改變 description coverage;enum intervention 則固定 task 與 endpoint,只增加 schema keyword。前者回答「模型是否知道可用 vocabulary」,後者回答「validator 是否能攔下模型漏出的錯值」。如果把兩個實驗合併成一句「enum 讓模型變強」,就會遺失論文的主要概念區分。
2. Tool surface 太大會製造 confound
完整 endpoint schema 有 20 個 parameters 時,有些模型會填 pagination cursor 或自己猜的欄位,讓被測 parameter 的 failure 變得不可觀察。超過 751 次 calls 中,兩個 model 對一個不可能知道的 parameter 填值率是 58/58 與 67/67,另五個 model 則是 0/72;平均每次填 5.4 個 parameters,但 task 只需要 3 個。研究者因此將 exposed tool 縮成三個相關 parameters,並把 stuffing 行為當作 control/結果,而不是把它偷偷算成 SilentProbe 的 API failure。
3. Inert exclusion 與 brute force 讓報告值偏保守
若 valid value 與 base 的 signature 相同,single differential 無法分辨「這個 query 上 filter 沒有鑑別力」和「filter 永遠被丟掉」。42 個 inert parameters 可能含有 genuine silent drops,所以 silent rate 的方向是往低估偏。另有 19 個 free-text parameters 被拿來測 always-discarded,9 個看似被丟掉,但只有 2 個在超過 246 million rows 的大 result set 上可定案。Vocabulary recovery 也是 brute force;作者只知道嘗試過的 token,因此 recovered vocabulary 與 silent count 都是 lower bound。
4. 結果能被誰解釋,以及不能被誰解釋
110/111 個 machine-checkable honest errors 是 Monid validator 在 request 到 vendor 前提出的;這正是作者所說的「aggregation layer 是 mechanism,不是 confound」。但兩位作者與 Monid 有 affiliation,這是 competing interest,且 live sample 只來自同一個 aggregation layer。作者用 APIs.guru 的 public corpus 支撐 static prevalence,不讓它完全依賴 Monid;execution claim 仍沒有 random production sample 的 cover。
Bloss0m 工程化整理:把零筆結果變成可驗證狀態
下面這個 checklist 是 Bloss0m engineering synthesis,不是論文提出的完整 runtime protocol。它把 paper 的 schema audit、validator boundary、retry trace 與 user-harm evidence 接成可以落地的決策順序:
- 先修契約:把 closed vocabulary、format 與 bounds 寫成
enum、pattern或 numeric constraint;如果 vocabulary 不完整,也用 closed list 說明已支援值,不要用e.g.假裝它是可推導的全表。 - 再設 gateway:在 request 進 vendor 前做 machine validation,error 要指出 offending field 與 legal values;不要只回傳 generic
HTTP 400。 - 再記錄證據:response 至少要能區分
matched_zero、filter_rejected、filter_unsupported、normalised、silent_suspect;若 API 沒有這些欄位,讓 agent state 保留 unknown。 - 最後才 retry:對 filtered zero-row 做一次受控的 baseline comparison 可以幫助診斷,但不能直接把 unfiltered result 當成 filtered answer,也不能假設 synonym search 會找到 hidden vocabulary。
- 把 audit 放進變更流程:對新 schema 跑免費 gap audit,再用 read-only、低成本、明確允許的 perturbation 做 staging verification;每次 live call 保存 run ID、schema version、request、response signature、成本與時間。
什麼時候不要採用這篇 paper 的數字
不要把 44/61 silent failures 當成所有 API 的 production rate,也不要把 enum intervention 寫成「schema promotion 保證資料正確」。以下情境尤其需要另做驗證:
- API 會產生 write side effect、付款、刪除或其他不可逆結果;SilentProbe 只執行 read-only、低價 endpoint,沒有提供 transaction 或 rollback 證據。
- endpoint 需要 authentication、特定 tenant state、streaming response,或不經 Monid;paper 的 execution sample 不覆蓋這些條件。
- task 的正確性取決於使用者 intent 與 domain semantics,而不只是 count/前五筆 row identity;semantic downgrade 在此方法中是盲點。
- provider 有明確的 schema-independent bug;合法
financevalue 在 repository 的 sibling endpoint 可找到資料,但在被測 endpoint 仍可能回傳零筆,enum 無法修復 provider defect。 - 團隊沒有能力保留 schema version、request/response provenance 與可重播 run record;沒有 evidence 的 retry 只會讓錯誤更難審計。
這些條件不是否定 paper,而是把 adoption boundary 寫在數字旁邊:SilentProbe 支持「先修可檢查契約,再談模型與 retry」;它沒有支持「所有錯誤都由 schema 造成」或「schema 能替整個 tool integration 提供安全保證」。
Artifact 與可重現性(截至 2026-09-17)
作者的 GitHub repository 目前可公開存取,不需登入;我檢查到的 default branch 是 one-commit snapshot,包含:
probe/:pool.py、fetch_schemas.py、gap_audit.py、corpus_audit.py、perturb.py、experiment.py、rq4_multi.py、rq6_downstream.py與 report scripts。data/:schemas、public-corpus audit、gap findings、perturbation records、model calls、agent transcripts、judge labels、run identifiers 與 recovered vocabularies。out/:FINAL-REPORT.txt、FINAL-RQ4-MULTI.txt、FINAL-RQ6.txt等 generated reports。paper/:LaTeX source、build script、PDF figures、figure source 與 bibliography。
Code 的 direct endpoint 有 MIT LICENSE;data 在 README 被描述為 research use release,但 repository 沒有另外的 data license 或 release package。這代表 code 可檢查、資料檔案可下載,卻不等於每個 data field 都能在沒有條件下再散佈。Paper Appendix A 說每個 live call 都有 Monid run ID,且完整 campaign cost under US4.67、OpenRouter inference US$1.89;README 的 reproduction commands 也把 static audit 標成 free,把 live probe 標成需要 Monid key,把 model experiment 標成需要 OPENROUTER_API_KEY。
最小的安全重現路徑是:先跑不發 API call 的 schema gap audit;若有明確授權與 read-only budget,再依 paper 的四秒 pacing 與 4xx confirmation 重現少量 perturbations;最後才在固定 endpoint/model/prompt 下跑 agent loop。本文沒有自行觸發作者的 live endpoints,也沒有把現有 run IDs 改寫成新的測量;截至上述日期,Monid coverage、vendor behavior、write operations、authenticated APIs、streaming tools 與完整 transfer 都仍是 open questions。
證據邊界與未支持的解讀
- 不是隨機 production sample:live endpoints 必須可由 Monid 觸達、read-only、每次不超過 US$0.02,且能合成一個有效 baseline。Public corpus 只支撐 static prevalence,不支撐 execution prevalence。
- 不完全是因果識別:constraint form 與 model exposure 有關,baseline synthesis 對有 enum 或 example 的 parameter 也比較容易成功;paper 有 reporting hand-written baselines,但沒有把它升格成任意 API 的 causal proof。
- inert exclusions 可能讓 silent rate 偏低:single query 上
sig(A)=sig(C)的 parameter 被排除,可能含真正的 always-discarded filter。 - coverage 不對稱:perturbation campaign 是 27 vendors,agent experiments 只覆蓋 3 vendors;模型也透過 OpenRouter gateway,不是各 provider 原生 API。
- vocabulary 是 lower bound:brute-force 只會找到研究者想到的 token;未知的 accepted values 與 silent failures 不會出現在報告裡。
- semantic downgrade 未被 mechanical oracle 捕捉:closed-list 的
used可能回傳非空且合理的資料,卻沒有滿足 certified pre-owned intent。 - 競合關係需要透明化:Monid 是測量 instrument,且作者與其有 affiliation;paper 說明這點,也用公共 corpus 避免 static claim 完全依賴同一家公司。
因此這篇 paper 的 strongest defensible claim 是:在這個統一、read-only、低成本的 apparatus 下,machine-checkable constraint 讓錯值有機會在 gateway 被明確拒絕,而 prose-only constraint 讓相當一部分 perturbations 通過並在 vendor 端靜默失敗;agent loop 的自行偵測與修復很弱。 它不是「schema 永遠正確」的 theorem,也不是「model 永遠不可靠」的 verdict。
讀完後的三個記憶點
- Technical idea:模型能讀 prose 不等於 infrastructure 能執行 prose;把 vocabulary 從
e.g.移到 enum,才讓 selection hint 與 rejection boundary 同時存在。 - Evidence:111/111 machine-checkable perturbations honest error 對 44/61 prose-only silent failure;example-only 的 agent trap 88/88,enum lift 後 0/89,但分母與 exclusions 必須一起讀。
- Boundary:filtered zero-row 不是 absence proof;read-only Monid sample、inert exclusion、brute-force lower bound、semantic downgrade 與 write/authenticated transfer 限制,決定了這個結論能走多遠。
原始出處
- Li, Zongrong; Ye, Shengkun; Guo, Feiyou; Dang, Zuoyou. SilentProbe: Measuring Silent Failure in Production APIs Used as Agent Tools, arXiv:2609.00035v1 (2026-08-29). Full HTML · PDF。
- SilentProbe source repository, MIT code license; README and repository data inspected on 2026-09-17.
- OpenAPI Directory (APIs.guru), the public corpus named in the paper’s Section 3.2 and Table 2.