文件漂移(documentation drift)通常不是「沒有人想寫文件」,而是程式碼的變更速度、文件的審查節奏與領域知識的維護責任分屬不同團隊。AWS Public Sector Blog 在 2026 年 9 月 20 日介紹一個由 AWS Advanced Partner Corley 為 Eutelsat 建立的方案:讓 Agent 讀取 GitLab repository 的 source code,從領域知識庫取得航太與衛星通訊語彙,再把專案文件建立或更新到 Atlassian Confluence。
這個案例最值得看的不是「Agent 會寫文件」,而是它把四種 authority 拆開:程式碼是實作事實的 source of truth;RAG 知識庫是領域 context;Confluence 是待發布的文件產物;人類是發布與例外處理的責任者。 這個分工如果沒有寫進 tool contract、review flow 與 audit trace,自動同步很容易只是把過時內容更快地複製到另一個系統。
先把四種 authority 分開
AWS 原文特別提醒,領域知識庫與 Agent 維護的 project documentation 不是同一批文件。這個差異是整個架構能否被治理的起點:
| 層次 | 它可以決定的事情 | 它不應越權決定的事情 |
|---|---|---|
| Source code repository | API、模組、依賴、流程與實際實作行為 | 領域術語的完整解釋、未寫在 code 裡的營運政策 |
| Domain knowledge base | 航太/衛星等領域術語、系統關係與背景語境 | 覆寫 code 已表達的介面、行為或版本事實 |
| Existing project documentation | 目前頁面結構、讀者脈絡與待修正內容 | 在 code 矛盾時成為較高優先級的事實來源 |
| Human reviewer | 是否接受差異、處理不確定性、批准發布與回復 | 把未驗證的 Agent 輸出當成已完成的工程證據 |
這不是抽象的提示工程偏好,而是資料與副作用的責任分配。若 Agent 看到 Confluence 中一段漂亮但過時的描述,應該把它當成待比較的版本;若 RAG 找到一份領域手冊,它可以幫助 Agent 使用正確術語,卻不能憑語意相似度改寫 repository 沒有的功能。
AWS 案例的兩個 loop
AWS 的第一張圖先用高階視角說明 domain expert、user、agent、knowledge base、source code repository 與 project documentation 的關係。圖中最重要的箭頭不是「Agent → 文件」,而是 source code 與 domain context 同時進入生成流程,再由 Agent 產生待審查的文件變更。
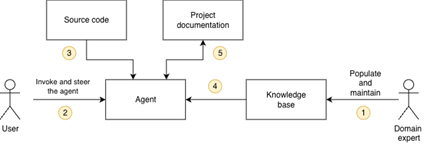
圖:AWS Public Sector Blog Figure 1,官方高階架構圖。本文用於說明來源關係;AWS 圖示的 reference architecture 不等於每個組織的 production guarantee。
第二張圖把流程拆成九個 interaction。前四步是相對低頻的知識庫維護,後五步是使用者每次啟動同步時的 operational flow。
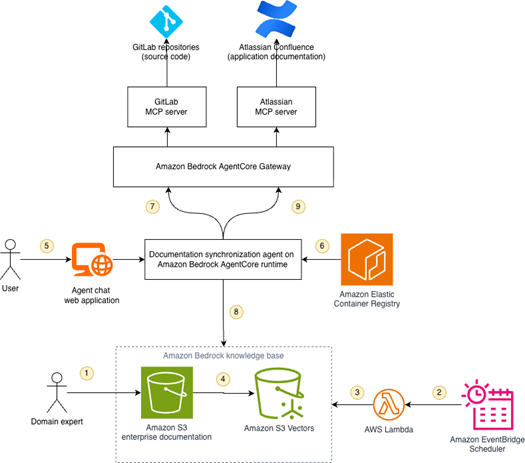
圖:AWS Public Sector Blog Figure 2,官方實作架構圖。圖中編號與下文的九步保持一致;責任邊界與風險分析是本文整理。
知識庫維護:步驟 1–4
- Domain expert 上傳 Markdown 到 S3。 這些文件描述基礎設施與產業脈絡,目的是教 Agent 使用領域語言,而不是直接成為某個 repository 的 project documentation。
- EventBridge Scheduler 定期觸發 Lambda。 AWS 原文說明這個案例通常每天同步一次,因為 domain documentation 不會頻繁改變;這是案例的排程選擇,不是所有企業都適用的 freshness SLA。
- Lambda 透過 Bedrock agent API 觸發 ingestion。 這一步把排程與索引更新接起來,也讓 ingestion 失敗能被當成 pipeline event 觀察,而不是等到 Agent 回答時才發現知識庫是舊的。
- Bedrock 將 S3 文件攝入 Amazon S3 Vectors。 完成後,knowledge base 才能被文件同步 Agent 使用。S3 Vectors 官方文件將它定位成可儲存與查詢向量的 AI-ready storage;它是檢索基礎設施,不是 authority policy。
因此,第一個 loop 的完成條件不應只是「index job 回傳成功」。正式環境至少要能回答:這次 index 包含哪個 S3 version、哪些文件被刪除或取代、embedding/chunking 設定是否改變,以及 Agent 使用的 knowledge-base snapshot 是哪一版。
文件同步:步驟 5–9
- 使用者透過 chat web application 提交一個或多個 repository URL。 這是任務入口,也是應該建立 tenant、project、branch/tag 與 dry-run 選項的地方;不要只把 URL 當作一段 prompt 字串。
- 第一次呼叫時,AgentCore Runtime 從 ECR 取出 Docker image 並啟動 Agent。 AWS 案例使用 Strands Agents framework。Runtime 的責任是承載 Agent 執行與相關可觀測能力,不等於它自動替你定義 repository 或 Confluence 的商業權限。
- Agent 透過 GitLab MCP 讀取指定 repository 的 source code。 AgentCore Gateway 對外暴露 MCP server;AWS 原文描述該 MCP server 以 ECR provision。GitLab 的官方文件也把 MCP server 描述為讓外部 AI tools 存取 GitLab project、issue、merge request 等資料的介面,因此 scope、project allow-list 與 read-only policy 仍需要平台自行配置。
- Agent 根據 source code 從 Bedrock knowledge base 取回相關 domain documentation。 AWS 使用 Retrieve API;該 API 回傳 retrieval results、score、metadata 與 location,也可能遇到 access denied、throttling、dependency failure 等錯誤。RAG 在這一步提供的是語言與關聯 context,不是用相似度投票決定哪份 code 才是真的。
- Agent 透過 AgentCore Gateway 上的 managed Atlassian MCP 讀取現有 Confluence project documentation,然後以 source code 為 single source of truth 建立或更新文件。 這一步同時包含讀取與寫入,是整個 flow 最需要 write boundary 的地方;「能呼叫 Confluence」不代表「可以無條件發布任何內容」。
這種分段也說明為什麼 Runtime 與 Gateway 不應被當成同一個元件。AgentCore Runtime 承載 agent execution;Gateway 提供工具與 resource 的統一入口、MCP translation、authentication 與 credential exchange。AWS 官方 Gateway 文件同時說明,它可以把 API、Lambda、agent 與 model provider 組合在單一 endpoint,但這種便利性不會替企業完成 least privilege、錯誤回復或文件發布政策。
RAG 是 domain context,不是第二個 source of truth
這個案例的 RAG 設計很容易被簡化成「把專案文件丟進向量庫,再請模型寫一篇」。比較精確的心智模型是:
- Code facts:從 repository 讀到的模組、endpoint、設定、呼叫關係與實際資料流。
- Domain context:從 S3 Vectors 取回的術語、標準、系統背景與跨系統關係。
- Publication context:Confluence 目前的頁面結構、歷史描述、連結與待修正區段。
三者在 prompt 中可以一起出現,但優先級不能相同。建議在 Agent contract 中明寫:
- 先建立 code fact inventory,再引用 domain context 解釋其意義。
- 若 domain context 與 code 互相矛盾,保留 code 描述的實作事實,並把矛盾列為 review item。
- 若 code 沒有足夠證據,不得用 RAG 推測成已部署、已支援或已符合政策的功能。
- 每段重要描述保留 repository path、commit/branch、knowledge-base document version 與 Confluence page version。
這樣做也能把「檢索錯誤」與「生成錯誤」分開評估。Retrieve API 的 score 只能說明候選結果的相關性訊號,不能證明內容正確;低分、互相矛盾或只有單一來源的結果,都應進入 human review,而不是被模型用更肯定的語氣掩蓋。
MCP 的真正邊界在 write,而不是在連線
MCP 解決的是工具與資料的標準化連線,不會自動把「讀 repository」和「發布 Confluence」變成同一種風險。這個案例至少有兩條不同的 authority path:
| 工具路徑 | 最小權限起點 | 必須額外驗證的事情 |
|---|---|---|
| GitLab MCP → source code | 指定 project、指定 branch/tag、read-only | Agent 是否能讀到 fork、private project 或不在任務範圍的 repository |
| Retrieve API → domain KB | 指定 knowledge base、metadata filter、受控 query | 是否混入別的 tenant、過期文件或不應進入 prompt 的敏感內容 |
| Atlassian MCP → Confluence | 指定 space/page tree、draft 或 restricted write | 是否會覆寫人工編輯、錯寫到 production space,或繞過 approval |
實作上可以把寫入拆成四個明確階段:read → plan → diff → publish。Agent 在 read 階段只能收集證據;plan 階段列出要新增、修改、保留與無法確認的段落;diff 階段產生可審查的 Markdown/HTML 差異與來源;publish 才能呼叫 Confluence write tool,而且要帶上 reviewer、source commit、knowledge snapshot、target page version 與 idempotency key。
如果 AgentCore Gateway 以統一 endpoint 暴露多個 MCP server,平台仍要在 Gateway、provider 與應用層各自確認:token 對應的 principal、tool scope、target resource、環境(staging/production)以及是否允許 write。Managed gateway 降低整合成本,但沒有把 tool description 當成安全政策的替代品。
人工審查是控制面,不是品質裝飾
AWS 原文列出的 Eutelsat/Corley 結果是:在 30 個原本沒有文件的 repository 上,Agent 每個 repository 約執行 15–20 分鐘;從零產生文件的人類 review 約 1–2 小時;30 個 repository 約一個日曆週完成;AWS cost 是每個 repository 幾美元;相較完全人工方式,估計節省超過 90% 時間。原文另以中等複雜度 repository 的人工製作估算 1–3 個 senior engineer person-days,推算全體需要 30–90 person-days。
這些數字要精確地讀:
- 它們是 AWS Public Sector Blog 對 AWS partner 與 customer case 的 first-party reporting,不是獨立重現的 benchmark。
- 「超過 90% 節省」把 Agent execution 與 human review 放在一個案例估算裡,不能解讀成文件可以不經審查直接發布。
- 「幾美元」沒有公開完整的模型、token、Gateway、MCP、儲存、網路與人工成本拆分,也不等於另一個 repository 的總成本。
- 30 個 repository 的樣本是沒有文件、且屬於 Eutelsat 團隊的案例;repository 複雜度、程式語言、權限與 Confluence 結構會影響結果。
所以更合理的採用目標不是「把 1–2 小時的人類審查拿掉」,而是讓人類把時間花在不確定性與責任判斷:哪些 code facts 確定、哪些 domain inference 合理、哪些跨 repository 關係需要 owner 確認、哪些頁面必須延後發布。
失敗模式:文件自動化最容易漏掉的地方
Repository 來源不穩定
如果使用者只提供 repository URL,Agent 可能讀到 default branch、未合併的分支或錯誤的 commit。正式流程應把 branch/tag/commit pin、submodule、generated code 與未提交變更寫進任務 manifest,並在頁面 metadata 中留下 source revision。
RAG 找到的是語境,不是證據
相似度很高的領域文件可能描述另一個系統版本。過期文件、錯誤 metadata 或 chunk 邊界,都可能讓 Agent 把「可能關聯」寫成「已實作」。需要對 retrieval 做 freshness、coverage、contradiction 與 permission test,而不是只看生成文字順不順。
Existing documentation 反過來污染 source of truth
若 prompt 把 Confluence 內容排在 code 之前,Agent 很可能延續錯誤的 API、舊架構或曾經存在的服務。應把 existing docs 明確標成「待比較的輸入」,並讓 diff 顯示哪些句子因 code contradiction 被改動。
MCP write 造成錯誤副作用
工具可能連線成功,但 scope、space、page ID 或 token 對錯環境。先用 draft/restricted space,再以 page version 做 optimistic concurrency,並讓每次 publish 可用 idempotency key 重播或安全重試。更新失敗時要保留 diff,不要自動用另一個頁面猜測目標。
跨 repository 關係被誇大
AWS 表示案例能根據文件與 code analysis 建立跨 repository 的 cross-linked view;這是很有價值的探索結果,但不等於所有關係都是已驗證的 runtime dependency。把 inferred relationship 和 code-confirmed dependency 分開標記,並交給 service owner 確認。
成功發布但無法追溯
每次發布應留下:source revision、knowledge snapshot、retrieved document IDs、model/prompt version、tool calls、Confluence page version、reviewer 與 publish result。AgentCore Runtime 的 tracing 能協助觀察 reasoning steps、tool invocations 與 model interactions,但 trace 可見性仍需要企業自行定義 retention、redaction、tenant boundary 與 incident access。
導入前的最小 checklist
- 先定義 authority contract:哪些欄位只允許由 code 決定,哪些領域術語來自 knowledge base,哪些段落一定要由服務 owner 確認。
- 把來源釘在版本上:repository、branch/tag、commit、S3 object version、index snapshot 與 Confluence page version 都要可回溯。
- 從 read-only dry run 開始:先輸出 inventory、citations 與 diff,不要一開始就開 Confluence write。
- 替 RAG 建立負面測試:包含過期文件、相似但不同系統、互相矛盾文件、無答案與權限不足案例。
- 替每個 MCP tool 寫 scope:project、space、page tree、environment、operation type 與可接受的副作用都要明確。
- 讓 publish 需要人類決策:低風險格式修正可自動化;介面、權限、資料流與跨服務關係的變更要進 review queue。
- 設定可量測的採用門檻:檢索 coverage、事實錯誤率、review time、publish rollback rate、每 repository 成本與文件 freshness 要分開追蹤。
如果團隊已經有 Agent 平台治理,可以先讀AI Agent 完整指南理解 runtime、tool、狀態與評測的分層;RAG 的資料、權限與評估可對照Enterprise RAG 完整指南;MCP 的企業控制與工具權限則可接著看GitHub MCP enterprise controls。若正在設計 AgentCore 的 OAuth 與 token 邊界,Consent Portal 的拆解能補上另一條 identity path。
來源與證據邊界
- AWS Public Sector Blog:Reducing documentation drift with Amazon Bedrock AgentCore — 九步流程、架構圖、Eutelsat/Corley case results 與 customer perspective。
- Amazon Bedrock AgentCore Runtime 官方文件 — Runtime 的 agent hosting、tracing 與工具整合定位。
- Amazon Bedrock AgentCore Gateway 官方文件 — MCP translation、tool composition、authentication 與 credential exchange。
- Amazon S3 Vectors 官方文件 — vector storage、query 與 Bedrock Knowledge Bases 整合定位。
- Amazon Bedrock Retrieve API — retrieval results、metadata、score 與錯誤語意。
- Strands Agents 官方網站 — AWS 案例使用的 agent framework 與 MCP/human approval 能力說明。
- GitLab Model Context Protocol 文件 — GitLab MCP server 的資料與工具連線定位。
AWS 的 product documentation 能證明這些服務與介面如何被設計;它不能單獨證明 Eutelsat 以外組織的成本、準確率、權限隔離、文件品質或 production SLA。這正是採用這個 pattern 時,必須自己補上的評測與治理工作。
延伸閱讀
- Cloud & Platform Benchling 如何用 AgentCore、STS 與 DNS Firewall 隔離多租戶程式執行 拆解 Benchling 在獨立 AWS 帳戶執行 AI 產生程式碼的分層設計:每工作臨時憑證、S3 endpoint policy、DNS allow-list 與持續外洩測試。
- Cloud & Platform AWS AgentCore Gateway 跨帳號 MCP:資料留在 LOB,授權留在 Gateway 拆解 AWS 的 AgentCore Gateway 多帳號參考架構,追蹤使用者 JWT、Cedar 授權與下游 M2M OAuth 如何分工,並指出 sample 尚未跨過的 production 門檻。
- Cloud & Platform AWS Bedrock AgentCore Consent Portal:Agent 的 OAuth 不只是按下 Connect 拆解 Amazon Bedrock AgentCore Consent Portal 的 end-user OAuth flow:如何分開 corporate IdP、Gateway、GitHub/Slack outbound provider、callback、session binding、token vault 與 CloudTrail,並標出 AWS reference walkthrough 沒有證明的安全邊界。