Agent 訓練與獎勵
系列 · 1 篇
-
DRACO:用 dynamic rubrics 把長程 Agent 的總分分回每一步
進階 Agent Runtime、安全與評測精讀 DRACO(arXiv:2609.04094):在沒有 ground-truth verifier 的長程工具任務中,動態產生每條 rollout 的 rubric,再把 trajectory-level advantage 依 judge 指出的步驟重新分配給 GRPO。
90 秒掌握這篇論文
- 問題
- 沒有 verifier 時,如何取得可用的 reward;取得後,又如何避免把整條長 trajectory 當成不可分割的單一動作?
- 核心洞見
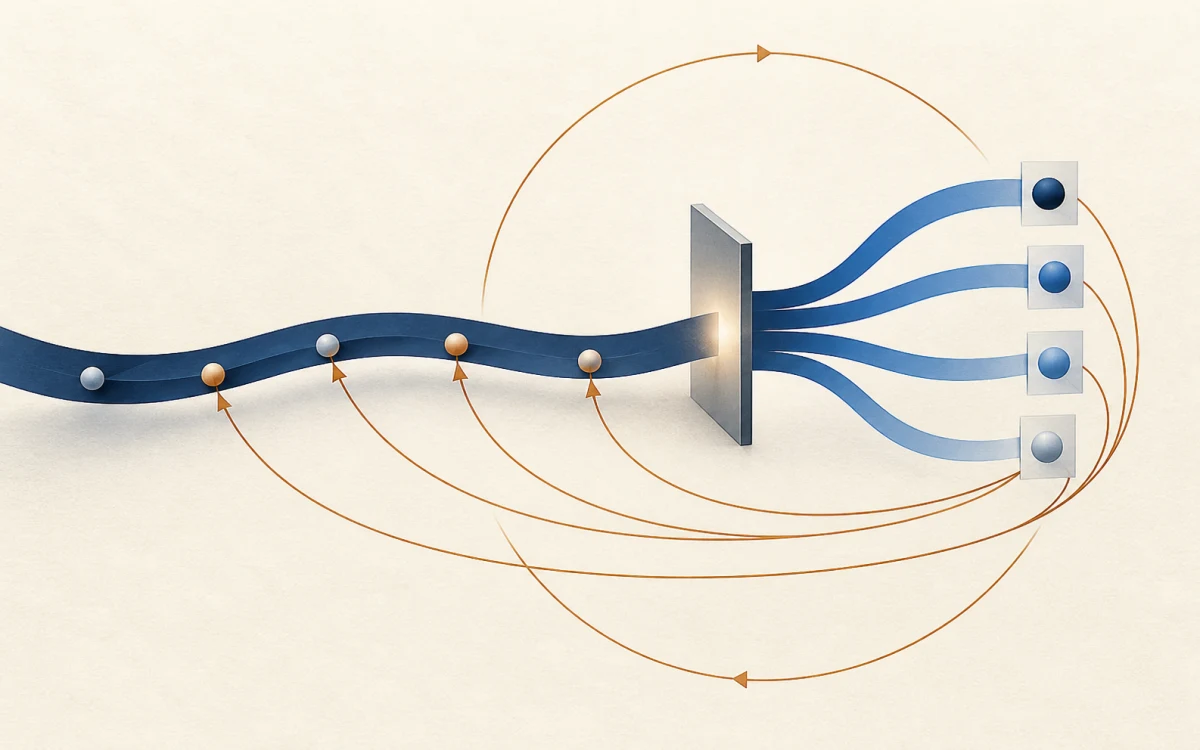
- 為每個 task 與 sampled group 動態生成、合併、去重並篩選 rubric;judge 不只回傳 pass/fail,也要指出哪些 steps 支持這個 verdict,讓一個 trajectory-level advantage 可以 closed-form 地分回 steps。
- 最強證據
- Qwen3.6-27B 的 AppWorld test-normal TGC/SGC 從 base 的 69.4/41.1 到 DRACO 的 85.3/70.6;在相同 base 與 budget 的 outcome-reward reference 上,DRACO 高 5.3/11.3 個百分點(Table 2、Section 4.2)。零樣本 tau-bench Banking SR 也由 15.8 到 20.4。
- 主要邊界
- 這些是 benchmark 與 end-task evidence,不是 judge 正確性或 attribution 正確性的直接證明。作者明確承認沒有 human-rater calibration;同一個 judge 可能一致地錯,錯誤的 citation 也可能仍偶然帶來更好的 policy。
歡迎演講、企業內部技術分享與架構交流;可以先查看我適合分享的主題與公開工程成果。
演講與聯絡