90 秒掌握論文
這篇論文的問題不是「如何讓 Agent 在有 unit test 的任務上得到一個 reward」,而是更難的 outcome-blind 情境:長程工具任務沒有可靠的 ground-truth verifier,訓練時不能讀取 AppWorld 的成功測試或 gold answer。作者用 natural-language rubric 讓 frozen judge 對一條完整 trajectory 做 process 評估,但一個總分仍然太粗:一條數十步的 rollout 可能只有一兩個關鍵錯誤,若把同一個 advantage 塗到所有 token,正確與錯誤的行為會收到相同方向的更新。
- 問題:沒有 verifier 時,如何取得可用的 reward;取得後,又如何避免把整條長 trajectory 當成不可分割的單一動作?
- 核心洞見:為每個 task 與 sampled group 動態生成、合併、去重並篩選 rubric;judge 不只回傳 pass/fail,也要指出哪些 steps 支持這個 verdict,讓一個 trajectory-level advantage 可以 closed-form 地分回 steps。
- 最強證據:Qwen3.6-27B 的 AppWorld test-normal TGC/SGC 從 base 的 69.4/41.1 到 DRACO 的 85.3/70.6;在相同 base 與 budget 的 outcome-reward reference 上,DRACO 高 5.3/11.3 個百分點(Table 2、Section 4.2)。零樣本 tau-bench Banking SR 也由 15.8 到 20.4。
- 主要邊界:這些是 benchmark 與 end-task evidence,不是 judge 正確性或 attribution 正確性的直接證明。作者明確承認沒有 human-rater calibration;同一個 judge 可能一致地錯,錯誤的 citation 也可能仍偶然帶來更好的 policy。
我的 bounded verdict 是:DRACO 最值得帶走的是一個 reward plumbing 設計:先用可演化的 rubric 產生可比較的 trajectory signal,再把既有 signal 依 step evidence 重新布線。它適合拿來測試「訓練瓶頸是不是 credit 太粗」,但不應被當成 verifier 的替代品,尤其不應在沒有 judge audit、資料外推與副作用檢查時直接用於高風險工具。
論文身份、問題與前一個瓶頸
DRACO 是 Gandhi、Goyal、Kate 與 Rizk 的 arXiv v1 預印本,發布於 2026-09-03;截至本文撰寫日沒有可稱為 peer-reviewed venue 的資訊,因此本文把它標為 未同儕審查的 arXiv preprint。官方 artifact 是 IBM 的 DRACO repository,不是一個只放 paper figure 的頁面,而是包含 training、AppWorld 與 tau-bench evaluation、analysis 目錄的研究程式庫。
先把兩個 reward 問題分開。第一個問題是「任務到底做對了嗎?」在數學或程式測試裡,verifier 可以給 terminal reward;但 customer support、研究、複合工具操作等任務通常沒有便宜且完整的 oracle。第二個問題是「如果只有一個 trajectory-level scalar,它應該影響哪一步?」GRPO 的標準做法會把同一個 乘到 rollout 的每個 response token。對十幾或幾十個互相依賴的 turns,這等於對正確的 API 選擇、無關的讀取、真正造成失敗的 action 都施加一樣的更新。
DRACO 的前一個方法並不是單純的「沒有 rubric」。已有 rubric-based reward 可以對完整 trajectory 打分,也有 step-level credit 方法可以細分 reward;作者的定位是兩者的交會:既不偷用 ground-truth outcome,又不需要每一個 position 都重新呼叫 judge 或訓練一個 attribution module。Table 1 把這個差異寫成幾個軸:outcome-blind、dynamic rubric、trajectory-level scoring、step attribution,以及 no learned attribution。DRACO 在這些軸上同時為 yes,但這張表是方法分類,不是性能排名。
相鄰的閱讀可以參考 A²E:Agent auditing engine:A²E 問的是如何保存可重評的 trajectory 與 runtime evidence;OSReward 則提醒 benchmark score、judge bias 與 platform failure 不能混成一個結論。DRACO 把關注點往前移到 training:你要先決定哪些 process criteria 能成為 reward,再決定它們如何改變 policy。
核心直覺:把一個總分改成「有證據的重新布線」
標準 GRPO 的 mental model 是:
group of rollouts → 每條一個 reward → normalize 成 A_i → 所有 response tokens 都用 A_i
DRACO 的 mental model 是:
task + rollouts → dynamic rubric set → trajectory reward R_i → GRPO advantage A_i → criterion-to-step citations → step advantages a_j
這裡有兩個互補的變動。
第一,rubric 不是一次為整個 task distribution 寫死。judge 先從 task instruction 產生 prompt-specific criteria,再觀察每條 sampled rollout,提出只有在實際 execution 中才看得出的 sub-goals、錯誤或安全條件。所有候選 rubric 合併、deduplicate,並做 discriminative dropout:如果 group 裡沒有任何 rollout fail 這個 criterion,就丟掉它,因為它不會在 group-relative learning 中提供區分力。作者要求 criteria MECE,避免同一個錯誤被兩條重疊規則重複懲罰。
第二,judge 對每一條保留的 criterion 回傳 PASS、FAIL 或 NOT APPLICABLE,以及 relevant_steps。trajectory reward 仍然是一個 scalar,但它不再是無法解釋的終點;每一個 verdict 都留下它引用的 steps。DRACO 用這些引用計算每一步的 pass fraction,再依 rollout 是 group winner 還是 loser 決定要放大「好步驟」還是「壞步驟」的更新。
End-to-end worked example:從 rollout 到 step credit
下面先用 Appendix E 的兩步數學例子,再用作者記錄的七步 rollout 讀一次真正的 attribution。這一節的數字直接來自論文;不要把它誤讀成 task success label。
兩步例子:同樣品質,不讓長 step 取得較多總影響
假設 trajectory advantage ,兩個 steps 的 quality weight 都是 ;第一步有 個 token,第二步有 個 token,所以 。DRACO 的公式給出:
因此 、,但 step total 分別是 與 。長度兩倍的第二步沒有因為 token 多而拿走兩倍的 total push;它只是把相同的總份額分攤到更多 token。
若第二步較好,改成 ,則 ,step total 變成 2 與 4。品質比例因此變成總影響比例。這也說明為什麼不能只看 per-token 排名:短 step 可能因為 而有較大的 token-level value,真正要比較的是 。
七步 logged rollout:winner 不等於成功
Appendix E.6 的真實 logged rollout 有七個 steps、五個 applicable rubric checks:R1、R2、R3 fail,R4、R5 pass。它的 rollout reward 是 ,但相對於同 group 的其他 rollout 仍是 winner,所以 ,走「強化高 quality step」的 branch。
逐步計數後,Step 1/2 的 ;Step 3/5 是 ;Step 4/6 是 ;Step 7 沒被任何 criterion 引用,繼承 cited steps 的平均值 。因為是 winner,,所以早期的 Step 1/2 的 weight 是 Step 4/6 的三倍。作者再用一組明確標示為 illustrative 的 token counts 計算,七個 step 的 total push 加總為 ;Step 1/2 各拿 72.47,Step 4/6 各拿 24.16。
這個例子有兩個不能省略的教訓。第一,winner 不是 task pass:它只是 reward 比 group mean 好,可能仍然絕對失敗。第二,credit 取決於 judge 的 citation,而非作者事後知道的真實 causal step;如果 judge 把錯誤引用到錯誤位置,formal conservation 仍成立,但學到的方向未必正確。
技術機制:dynamic rubric、reward 與 closed-form credit
1. GRPO 的 baseline
對 task ,policy 取 條 trajectories ,每條得到 scalar reward 。群組標準化為:
標準 GRPO 的 policy-gradient 項目是:
會讓該 rollout 的 token 在相同 context 下更可能, 則反向;問題是同一個 乘了所有 token。DRACO 不改 group normalization,也不重新發明 GRPO objective,只換掉 uniform multiplier。
2. 動態 rubric 如何生成可用 reward
對 task instruction,judge 先生成 instruction-derived criteria;對每條 sampled trajectory,再生成 execution-derived criteria。這些候選 rubric 必須能被 trajectory-only evaluator 判斷,包含 title、description、evaluator instruction 與 criteria 的適用條件。接著將 group 中的候選合併成共享 set ,去掉重複與沒有 discriminative failure 的項目。
對 rollout ,令 與 為 applicable、surviving criteria 的 pass/fail 數:
若沒有任何 applicable criterion,。NOT APPLICABLE 不進分子或分母;這讓不同 rollout 因為沒有走到某條 branch 而不會被免費算 pass。重要的是, 不含 task unit test、gold answer 或 outcome verifier,因此作者稱它為 outcome-blind reward。
3. 從 citation 得到 step quality
一個 step 是約一個 agent turn/emitted code block;tool-result echo 或 turn glue 等 gap tokens 不屬於 step,也不進 credit accounting。對 step , 是所有引用該 step 的 pass/fail criteria 數,定義:
如果沒有 criterion 引用該 step,使用 cited steps 的平均 。這個 fallback 不是額外判斷;它只避免未被引用的 step 消失。
令 是 step 的 token 數, 是所有 credited step tokens 的總數。若 ,代表這條 rollout 在 group-relative 意義上要被 reinforce,使用 ;若 ,代表要 suppress,使用 。最後每個 step 的 token 都用:
把 verdict 轉成方向正確的權重; 讓 step total 不受 verbosity 影響; 則負責 conservation。若 normalizer 為 0、沒有 step citation,或遇到作者在 Appendix E.7 列出的 unanimous degenerate case,implementation fallback 到 uniform baseline GRPO。
最核心的形式性質是:
因此 scalar total push 與 baseline 相同;credit 只改變它在 steps 間的分布,不膨脹或縮小 rollout 的總影響。由於 , 不會和 反號,具有 sign preservation。附錄還形式化了 no-signal equalization、monotone correctness、length independence、reward-scale invariance 與 winner/loser symmetry;這些是 credit rule 的 algebraic properties,不是 performance dominance theorem,也不保證 judge 的 criteria 本身正確。
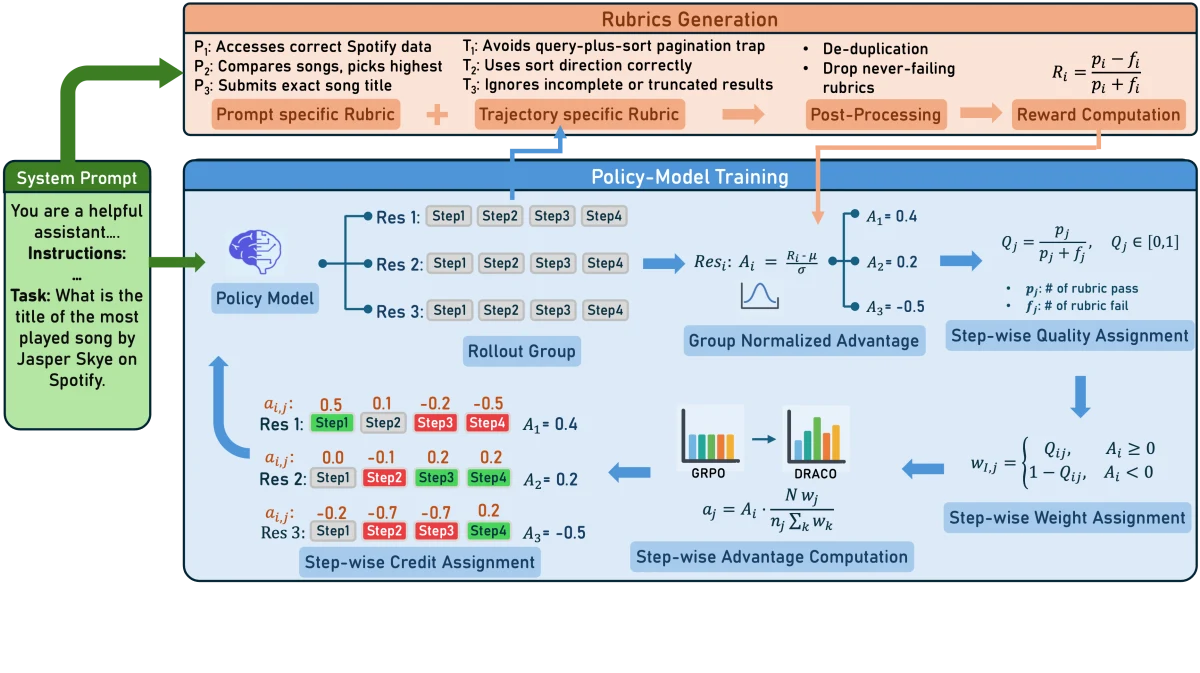
Figure 1,論文 Section 1 的 overview:上半部從 task instruction 與 sampled trajectories 產生、合併並評分 rubric,得到 outcome-blind ;下半部先用 GRPO 得到 ,再依 criterion verdict 的 step citations 產生 。原始 Figure 1 · 原始圖片端點。原始 arXiv HTML 標示 CC BY 4.0;本文保留作者、論文、圖號與來源連結,並將 PNG 轉為 WebP。

實驗如何讀:結果、成本與 failure modes
設定與 evaluation protocol
作者在 AppWorld training split 的 90 tasks 上訓練,使用四種同一 base policy 的 outcome-blind variants:static rubric/no credit、static rubric/step credit、dynamic rubric/no credit,以及完整 DRACO。另有使用 AppWorld unit tests 的 outcome-aware reward reference。主要 ablation 用 Qwen3.6-27B;另報告 Qwen2.5-32B-Instruct。所有 run 都用 LoRA、GRPO、batch size 16、group size 6、8 張 H100,training-time rubric generation、union、scoring 與 credit reallocation 使用 GPT-5.4、temperature 0.1。
evaluation 包含 AppWorld test-normal(168 tasks)、test-challenge(417 tasks,含 unseen apps/compositions)與只在 AppWorld 訓練的 zero-shot tau-bench Banking(97 tasks)。AppWorld 的 TGC 是 unit-test task goal completion,SGC 是 full-scenario completion;tau-bench 用 state-matching success rate。 是三次 evaluation run 中「所有 次都成功」的 consistency 指標,不能和 pass@k 的「至少一次成功」混用。作者訓練 Qwen3.6-27B 100 steps、Qwen2.5 75 steps,每個 checkpoint 做三次 evaluation,再取最後三個 checkpoint 的 mean。
Figure 2 與 Table 2:headline gain 不是只看一個 row
Qwen3.6-27B 的 Table 2 是最完整的 headline evidence:DRACO 在 AppWorld TN 的 TGC/SGC 為 85.3/70.6,而 base 為 69.4/41.1;AppWorld TC TGC 為 61.5,tau-bench SR 為 20.4,base 分別是 49.7 與 15.8。AppWorld TN 的 TGC gain 是 +15.9,SGC gain 是 +29.5;相對同 budget 的 outcome reward reference 80.0/59.3,DRACO 高 +5.3/+11.3。但這不是「rubric 一定比 verifier 更真實」的證明:reference 與 DRACO 使用不同 reward source,且 benchmark 的 success 只在 evaluation 時使用。
在 Qwen2.5-32B-Instruct,DRACO 也由 TN TGC/SGC 35.7/17.3 升到 62.9/42.3,顯示不是只依賴 Qwen3.6 的 starting point;但不同 base model 的數字不可直接當成 scaling law。 的增益尤其重要:TN TGC 從 47.6 到 72.8,代表 consistency 比 single-run discovery 更明顯改善;仍應記住這是 held-out benchmark protocol 的 consistency,不是 production reliability。
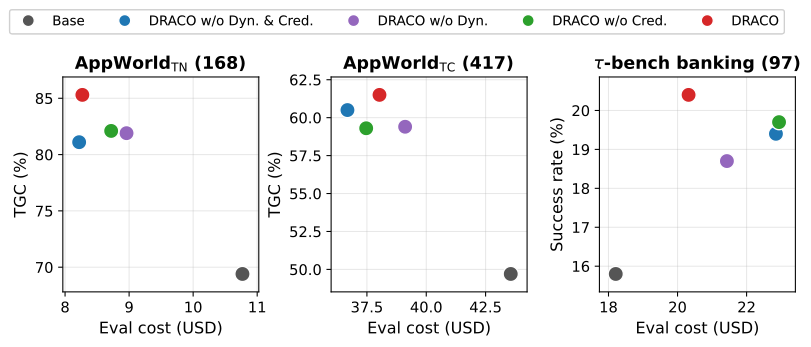
Figure 2,論文 Section 4.2/4.4 的 cost analysis:每個 benchmark 的橫軸是一次 full-split evaluation 的美元成本,縱軸是 Qwen3.6-27B ;左上較好代表較高分與較低成本。原始 Figure 2 · 原始圖片端點。原始 arXiv HTML 標示 CC BY 4.0;本文保留 attribution,直接使用轉存的 SVG。

成本圖值得和 Table 3 一起看。AppWorld TN 上 DRACO 達 85.3 TGC、成本 8.27 美元,base 是 69.4、10.77 美元;TC 上 DRACO 是 61.5、38.03 美元,base 是 49.7、43.56 美元。每個 rubric setting 的 episode turns 也下降;DRACO TN 由 18.7 到 14.7,TC 由 22.9 到 20.7。可是 tau-bench 的 turns 反而略升,且 gain 更貴:這比較像 held-out domain 中少一點 give-up、多完成一些事情,而不是單純「更短所以更便宜」。
Ablation:兩個零件要同時成立
Table 2 與 Section 4.3 的四-way ablation 是機制 evidence。Qwen3.6 的 AppWorld TN:在 per-trajectory rubric 上加入 step credit,TGC +3.2、SGC +5.7;相對固定 rubric,兩個元件合在一起是 +4.2 TGC、+10.7 SGC,到了 則是 +8.1/+14.3。單獨加 dynamic 或單獨加 credit 的收益都小得多;在 test-challenge,固定 rubric 上的 step credit 甚至在 造成 -3.7 TGC,而 dynamic rubric 上則 +1.4。
這正是論文的 causal-looking mechanism,但不能寫成完整 causal proof:作者控制了 base、hyperparameters 與 training setup,仍然是有限 benchmark 的 intervention。最合理的讀法是「step credit 需要足夠 episode-specific 的 rubric 才有可歸因的 signal」,而不是「dynamic rubrics 在所有 task 上都必要」。
Figure 4:dynamic reward 不飽和,卻也代表 target 一直在變
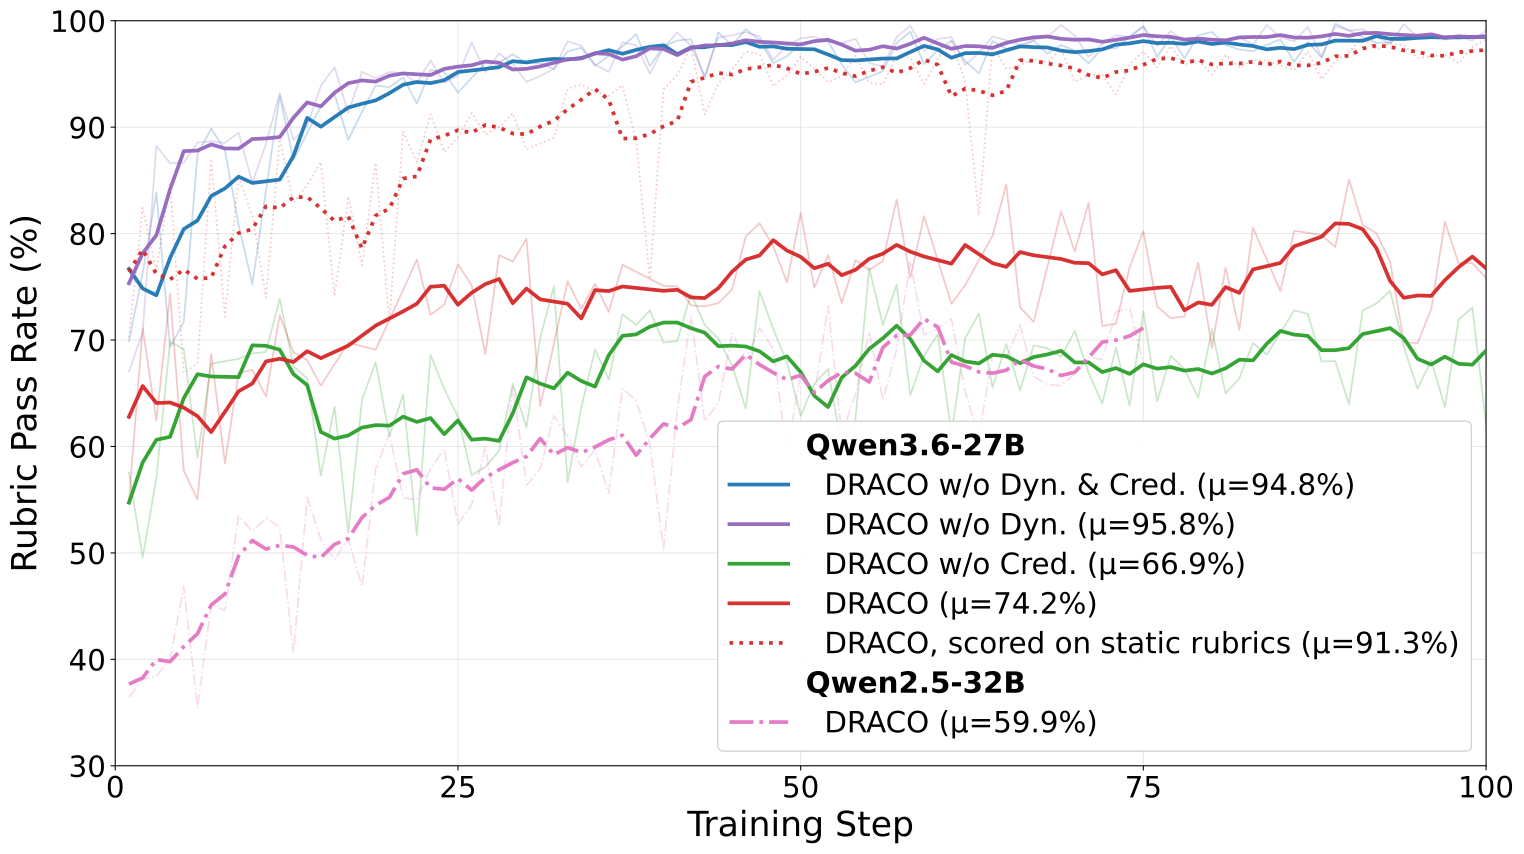
Figure 4,論文 Section 4.4 的 training-signal analysis:static rubric 的 aggregate pass rate 約在 25 steps 到 mid-90% 後飽和;dynamic settings 留在較低但持續變動的區域。虛線是把 DRACO rollout 用未參與訓練的 static rubric 重評。原始 Figure 4 · 原始圖片端點。原始 arXiv HTML 標示 CC BY 4.0;本文保留 attribution,直接使用轉存的 SVG。

static rubric 很快接近 ceiling,表示它不再提供有區分力的 learning signal;dynamic criteria 會依 policy 的 evolving failures 重新出題。DRACO 用 static held-out rubric 重評自己的 rollout 可回到 91.3%,接近 static runs 的曲線,支持「dynamic criteria 包含了 static criteria 的可用部分」這個作者解讀。可是這不代表 dynamic rubric 的 pass rate 越低越好:它只代表 generator 與 discriminative dropout 還在找到 policy 尚未穩定的檢查點。
Figure 3 的 termination analysis 補充了 failure mode:訓練初期 length、turn、server error 或沒有 action 等 non-normal termination 會很多;dynamic settings 最後大多能 submit answer,且 credit 讓這些模式更早消退。這支持「credit 改變了 rollout completion 行為」的解釋,但 figure caption 也提醒 termination mode 與 task correctness 是分開的,不能把正常結束直接當成功。
Figure 10 與 self-judge:成本下降,validity 問題仍在
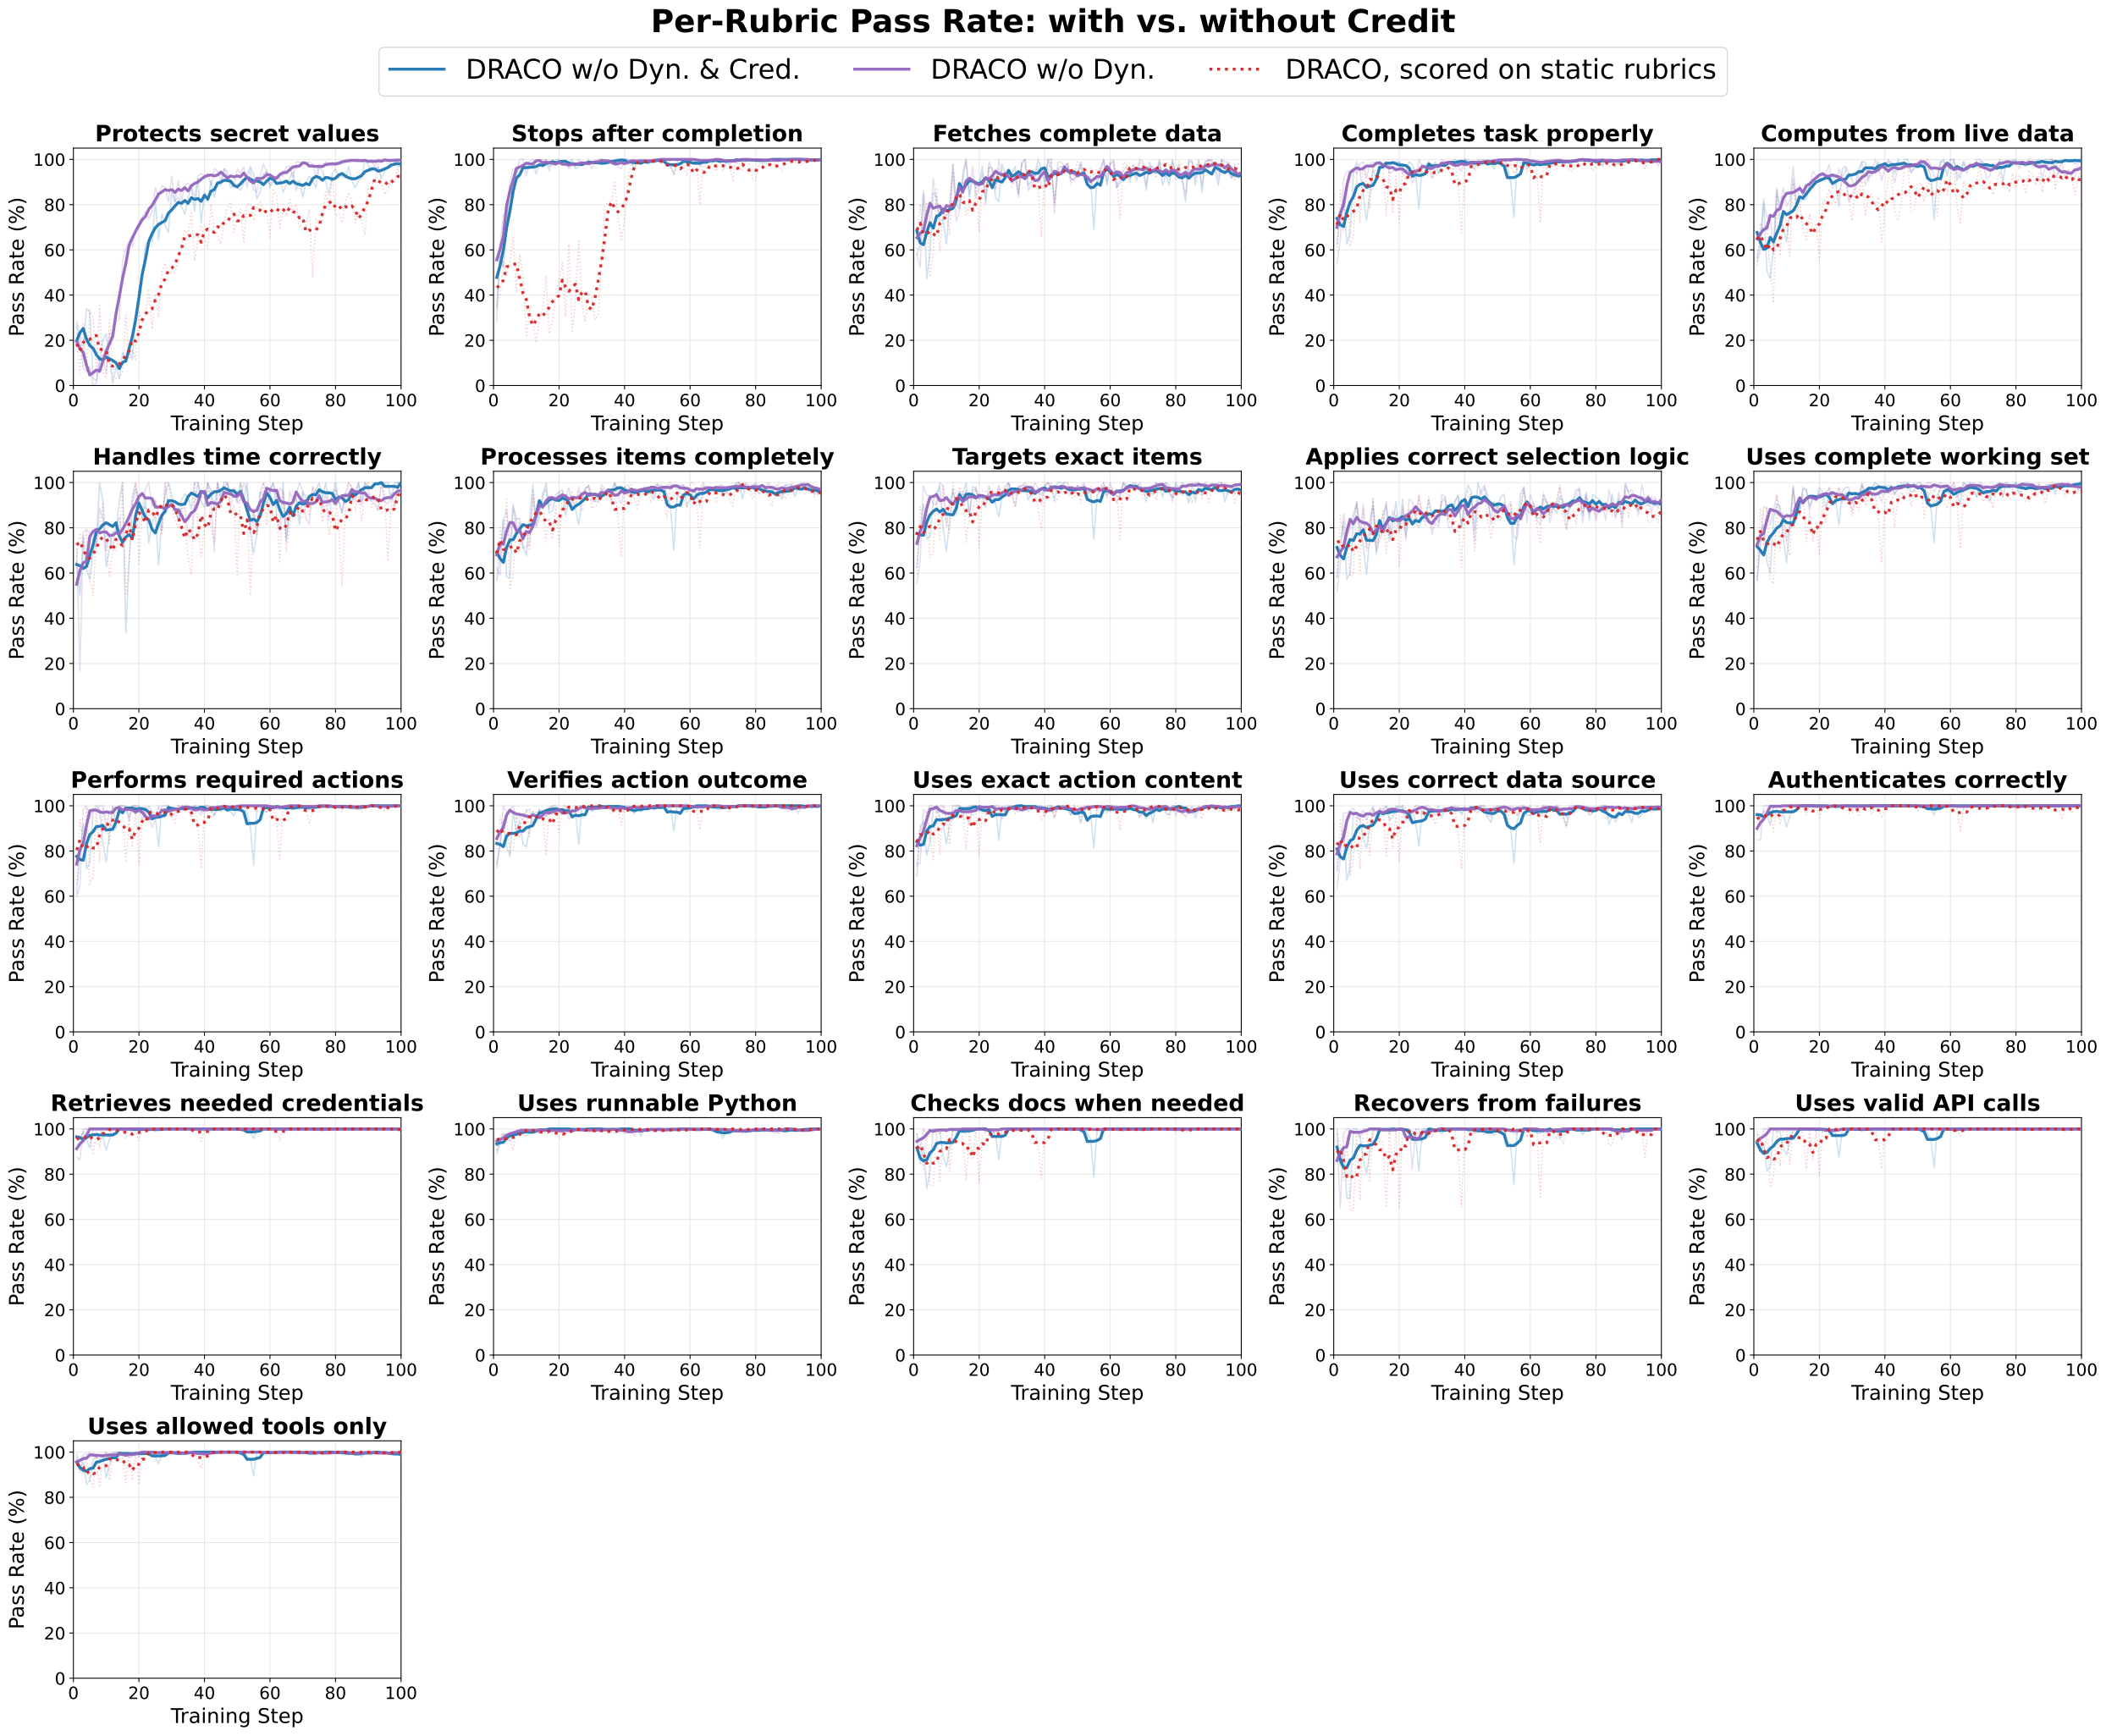
Figure 10,論文 Appendix A 的 per-rubric analysis:把 Figure 4 的 aggregate static pass rate 拆成單條 criteria,顯示多數 criteria 很早接近 ceiling,Protects secret values 等 initially-hard criteria 仍能看出 step credit 的差異。原始 Figure 10 · 原始圖片端點。原始 arXiv HTML 標示 CC BY 4.0;本文保留 attribution,直接使用轉存的 SVG。

Judge 是 DRACO 最大的訓練成本,所以作者以 policy model 自己當 judge,並在每條 trajectory 重複 scoring 三次、三次都 pass 才算 pass。100 steps 的 judge cost 由 $1607 降到 $316,約 5.1×;AppWorld TN 的 self-judge TGC/SGC 是 81.1/62.7,甚至高於 outcome-aware reference 80.0/59.3,tau-bench SR 21.1。
但 Appendix B 的 judge replay 讓結果更複雜:self-judge 與 GPT-5.4 在 60,689 criterion verdicts 上的 agreement 是 89.4%,比「永遠 pass」的 72.0% 高;不一致幾乎單向偏 lenient,self-judge 會 pass 30.4% 個 GPT-5.4 fail 的 criteria,反過來只 fail 1.3% 個 GPT-5.4 pass 的 criteria。generation 與 union 也不同:self-model 產生的 criteria 較少,union 卻保留過多 criteria,讓 discriminative fraction 由 46.5% 下降到 31.3%。所以 self-judge 是成本/品質 trade-off,不是已驗證的 drop-in replacement。
證據地圖與 Paper Essence Contract
- Paper 直接支持:DRACO 的 outcome-blind problem formulation;dynamic per-trajectory rubric 的生成、union、dropout 與 scoring;Eq. 3–7 的 reward/credit rule;AppWorld 與 tau-bench 設定;Table 2 的 base、outcome reward、ablation、self-judge 數字;Appendix E 的 conservation、sign preservation、length independence 等形式性質。
- 作者 interpretation:dynamic rubrics 追蹤 policy 的 evolving capability;step credit 能把一個 coarse reward 對準真正被 criteria 引用的 steps;兩個 component 的互動是 AppWorld gain 的來源;self-judge 在足夠一致時可降低成本。
- 尚未建立:criteria 是否 faithfully 描述 task;judge 是否與人類一致;relevant_steps 是否是真正的 causal steps;discriminative dropout 對 training-time variance 的影響;在非模擬、高風險、跨 domain 或不同 provider 上的 validity。
- Bloss0m 工程判斷:若你已有可 replay 的 trajectory、可版本化的 judge 與明確的 process rubric,DRACO 值得作為「uniform trajectory credit 是否限制 RL」的 controlled experiment;若沒有 verifier 與人類 audit,應把它視為可審計的 heuristic reward pipeline,而不是 correctness oracle。
這份文章完成 Paper Essence Contract 的六個回答:
- 解決什麼問題? Section「論文身份、問題與前一個瓶頸」:在沒有 outcome verifier 的 long-horizon tool-use training 中取得 reward,並把它從 trajectory 分到 steps。
- 前一個方法為什麼不夠? Section「核心直覺」與 GRPO baseline:uniform 讓正確、無關、錯誤的 token 同收一樣的 push;固定 rubric 也會飽和。
- 核心技術想法? Dynamic per-trajectory rubrics 加上 citation-conditioned, closed-form step credit。
- 一個 input 怎麼走? Section「一個 faithful example」:五條 verdict、step citation、、winner branch、、 到 conservation。
- 什麼 evidence 支持 headline? Section「實驗如何讀」:Table 2 的 TN/TC/tau-bench、outcome reward 比較、四-way ablation、cost/termination analysis。
- claim 在哪裡停止?工程後果是什麼? Section「Figure 10 與 self-judge」及「工程判斷」:judge validity、attribution validity、variance 與 domain transfer 未建立,因此必須留存 evidence、做 human calibration,並在高風險工具上保留獨立 verifier。
Artifact 與可重現性(截至 2026-09-09)
官方 IBM/draco repository 的 main HEAD 可直接連線,本文審核到的 commit 是 cfafd0f81f2c49aa36a4b25a2a7b6ac6e119f47b,repository 非 archived,並包含 Apache License 2.0 的 LICENSE、training/、evals/appworld/、evals/tau-bench/ 與 training/analysis/。README 有 training/setup.sh、training/launchers/run.sh、不同 run tags、reward pipeline、credit assignment、self-judge、logging 與 evaluation runbook;這是 可讀、可檢查的 source artifact。
但完整 reproduction 不是 clone 後一鍵完成:README 明確說 model weights 與 AppWorld data 不在 repository,必須放到外部 WORKSPACE_ROOT;frontier-judge settings 需要以 /v1/completions 相容的 endpoint、model route 與 secret;GPU、container、Weights & Biases 與 benchmark environment 也在 repository 外。tau-bench 需要它自己的 data/environment。本文因此把 artifact 分類為:code 可用;paper 的資料、權重、judge endpoint 外部依賴/未隨 repo 提供;checkpoint 與完整 run logs 未在此次端點中發現。
最小可重現路徑應是:固定上述 commit;準備 README/INSTALL 要求的 model weights、AppWorld data、container 與至少 8 張 H100(論文設定);在 $WORKSPACE_ROOT/secrets/rubric_llm.env 放入相容的 judge endpoint;先跑 dynamic_credit 的 smoke configuration,再依 evals/appworld/RUNBOOK.md 與 evals/tau-bench/README.md 執行 official harness;最後保存 rubric JSON、criterion verdict、relevant steps、reward、checkpoint、seed、model/prompt/version 與 evaluation output。若任一外部模型或 data 不可得,應把結果稱為 pipeline smoke test,不是 paper reproduction。
工程判斷與不適用條件
值得測試的情境:
- 任務是十幾步以上的工具互動,只有稀疏或不可程式化的 outcome signal,且團隊能寫出可觀察、可版本化的 process criteria。
- 你想區分「policy 不會做」與「reward 太粗」:先以 static/dynamic、with/without credit 做四格 ablation,而不是直接相信單一 DRACO run。
- 你能保留 raw trajectory、judge prompt、rubric set、citation 與 policy checkpoint,並用獨立 evaluation verifier 只在測試時驗證結果。
不要直接套用的情境:
- 任務有可靠 unit test 時,不要因為 DRACO 的 outcome-blind 設定而丟掉 verifier;應把 verifier 當主訊號,rubric 當 process diagnostic 或輔助 reward。
- 高風險的付款、權限、個資或不可逆操作,若沒有 human review、policy constraint 與 rollback,不能讓一個可能 systematic wrong 的 judge 成為唯一訓練目標。
- criteria 會重疊、step boundary 不穩、tool result 不能對齊 rollout,或你的 action 不是 judge 能引用的可定位事件時, 的表面精度會掩蓋 attribution noise。
- 你沒有足夠 judge budget、版本治理或外部模型 access;self-judge 可以便宜,但論文自己的結果顯示它偏 lenient,不能只用 agreement percentage 宣稱等價。
最小部署決策可以寫成一個 gate:先問「是否有獨立 outcome check?」再問「能否把 rubric verdict 定位到 step?」最後問「能否測 judge validity、citation validity、cost 與 distribution shift?」三題任一答否,DRACO 仍可作為研究 ablation,但不應直接成為 production policy optimizer。
讀完後的三個記憶點
- Technical idea:DRACO 不是把一個新 reward 乘到更多 token,而是先用 dynamic rubric 把 rollout 變成可分解的 verdict,再用 sign-preserving、length-normalized 的 closed-form rule 把既有 分回 steps。
- Evidence:AppWorld 的 TN/TC、zero-shot tau-bench、四-way ablation、cost 與 termination analysis 一起支持「dynamic rubric + step credit」比單一 component 更有用;Figure 4/10 也顯示 signal 的變化與 per-criterion saturation。
- Boundary:conservation、sign、length independence 是數學保證,不是 judge validity 保證;在真實採用時,最重要的工程工作是版本化 rubric/evidence、獨立驗證 outcome、校準 judge,並保留高風險操作的控制面。