論文精讀
AgentPProf 精讀:讓長期 Agent 軌跡能跨執行剖析
原文:AgentPProf: Semantic Profiler for Long Horizon AI Agents
90 秒掌握論文
- 問題:Agent 團隊能從單次 trace 找某個請求何時失敗,卻不容易把幾週、幾百次執行依共同任務或工作階段聚合,回答「哪一種工作耗最多 token」「失敗是否都卡在相同步驟」。傳統 profiler 有可折疊的函式呼叫堆疊;Agent 的任務意圖則藏在不同措辭裡,且沒有執行時堆疊可直接歸因。
- 核心洞見:把每個活動統一成 operation,再由軌跡推導巢狀的語意區間,把資源投影到 operation stack,讓相同語意路徑跨 session 合併;同一套標註可以改用 token、時間或 operation 數量呈現。
- 最強證據:在 405 條 CodeTraceBench 軌跡、2,948 個人工階段標註上,作者報告 B³ F1 為 0.764(統計 recurrence 基線 0.663、raw action 0.541)。三項 fault-localization workload 將 profiler 與 benchmark 自帶診斷結合,MAP 比只用診斷分別增加 0.031、0.107、0.117。
- 主要邊界:這是作者在特定公開資料與實際軌跡上的評估,不是本站獨立重跑,也不是對生產因果根因的保證。任務區間必須被假設為連續、可遞迴切分;火焰圖寬度表示被選定的可加資源,不代表某個活動造成失敗。
本文依據 2026 年 9 月 14 日提交的 arXiv v1 預印本。論文的故事從三次相同 Git 部署任務失敗開始:489 個 operation、約 460 萬 token 分散在不同 prompt 和 shell 指令,逐份重讀耗時,既看不出共同問題,也無法區分工作量與模型成本。作者把「診斷單次 trace」改成「跨 run 剖析任務意圖」,用語意區間替代函式名稱,再將它輸出成既有 pprof 格式。三次失敗中,診斷身分驗證的工作只佔 21% operation,卻佔 46% token;這是值得檢驗的觀察,不是通用的 Agent 故障定律。
既有方法的限制:為什麼逐次 trace 不夠
單次 trace、span tree 或時間線能告訴工程師某個 session 的模型呼叫、工具結果與時間順序。當問題是「這次部署為什麼失敗」,這些細節很重要;但若要知道跨一百次 code review 中,多少輸入 token 花在重試或讀檔,就必須先把相同工作合併。傳統 CPU profiler 之所以能折疊,是因為每個 sample 都附著在穩定的函式呼叫堆疊;Agent 的使用者意圖是自然語言,同一任務可能分別寫成「修登入 bug」「token auth keeps failing」或 shell 驗證,難以用原始文字當共同鍵。
作者區分兩個層級。高層是 Agent 的意圖活動:prompt、LLM 呼叫與工具調用;低層是工具觸發的 process、檔案讀寫與網路請求。一個工具呼叫可能產生多個低層副作用,若僅按 API request 分類,責任標籤便無法自然傳到後續作業;若逐條讀完整紀錄,又會回到不可擴展的人工檢查。AgentPProf 的主要設計問題是如何將這兩層接在一起,並保留可追溯到來源 operation 的證據(論文 Sections 1–2)。
核心直覺:從呼叫堆疊改成語意責任堆疊
一般函式 profiler 將呼叫路徑視為責任階層,例如 main → parse → tokenize。AgentPProf 沒有真正的 runtime stack 可以讀,因此用一組在查詢時選定的欄位構成 operation stack。作者將 operation 定義為帶字串欄位、可加度量的記錄;prompt、模型呼叫、工具、GUI 動作、檔案讀取與 process event 都可用同一種結構表示。欄位可包含 project、agent、session、task tag、kind、model、path、domain 或 status;度量則是 token 數、duration、event count 等可加數值(Section 3.1)。
假設有 operation ,選定的欄位序列是 ,投影後的路徑是 。兩個 operation 若路徑相同,就依所選度量加總。工程師可用同一批 operation,改按 task、phase、session 或 action 分組,不必重跑原始事件擷取。這和按同一個 label 聚合很像,但語意標籤必須先能跨不同 session 保持穩定;這就是遞迴 operation segmentation 要補上的部分。
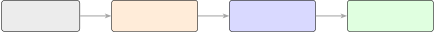
原論文 Figure 2,依 arXiv v1 所列 CC BY 4.0 授權重用。切分每條軌跡一次,投影和折疊可在查詢時重做;圖示的是資料流,不是已證明的 profiling 正確率。來源:arXiv v1, Figure 2, Section 3。
用 Git 部署失敗走一遍方法
論文的動機案例是三個 coding-agent session 各自嘗試部署 Git 服務,目標是提供密碼驗證的 endpoint,結果都沒交付成功。三段紀錄合計 489 個 operation、約 4.6M token。逐條檢視能看到指令做了什麼,但不同 run 對相同意圖的描述各異,難以直接疊在一起。
- 輸入:Codex/Claude Code 本機 JSONL 對話,以及 AgentSight 捕捉的 process、file 等低層事件。所有來源解析成 operation;有明確工具或 event ID 時沿用,缺少時依程序生命週期重疊等規則建立關聯,模糊關係不強行指定父項(Section 3.1)。
- 找責任轉折:遞迴切分器閱讀 prompt、指令與輸出摘要,在工作責任改變處畫稀疏標記。根工作可能是「build deployment system」,其子區間再分為「diagnose authentication」。每個標記後方的 operation 沿用該層級路徑,直到下一個轉折。
- 構造路徑:operation 因而得到
build deployment system > diagnose authentication這類巢狀路徑。相同短名稱跨三個 session 對齊,未被語意標籤吞掉的 LLM/工具證據仍留在路徑末端。 - 換度量、折疊:以 operation count 看,認證相關工作佔 21%;切換成 tokens,同一層級佔 46%;加入 elapsed time 則佔 37%。換的是寬度計算,階層標註不變(Sections 2、5.1;Figure 1)。
- 形成可測試的假說:展開該路徑後,三個 Agent 都在嘗試 SSH 替代傳輸方式,卻沒有確立目標服務的認證端點。profile 暗示可提早驗證憑證或限制重試深度;這是作者從紀錄得出的修復方向,不是火焰圖本身證明了因果關係。
Figure 1:同一堆疊可回答不同問題
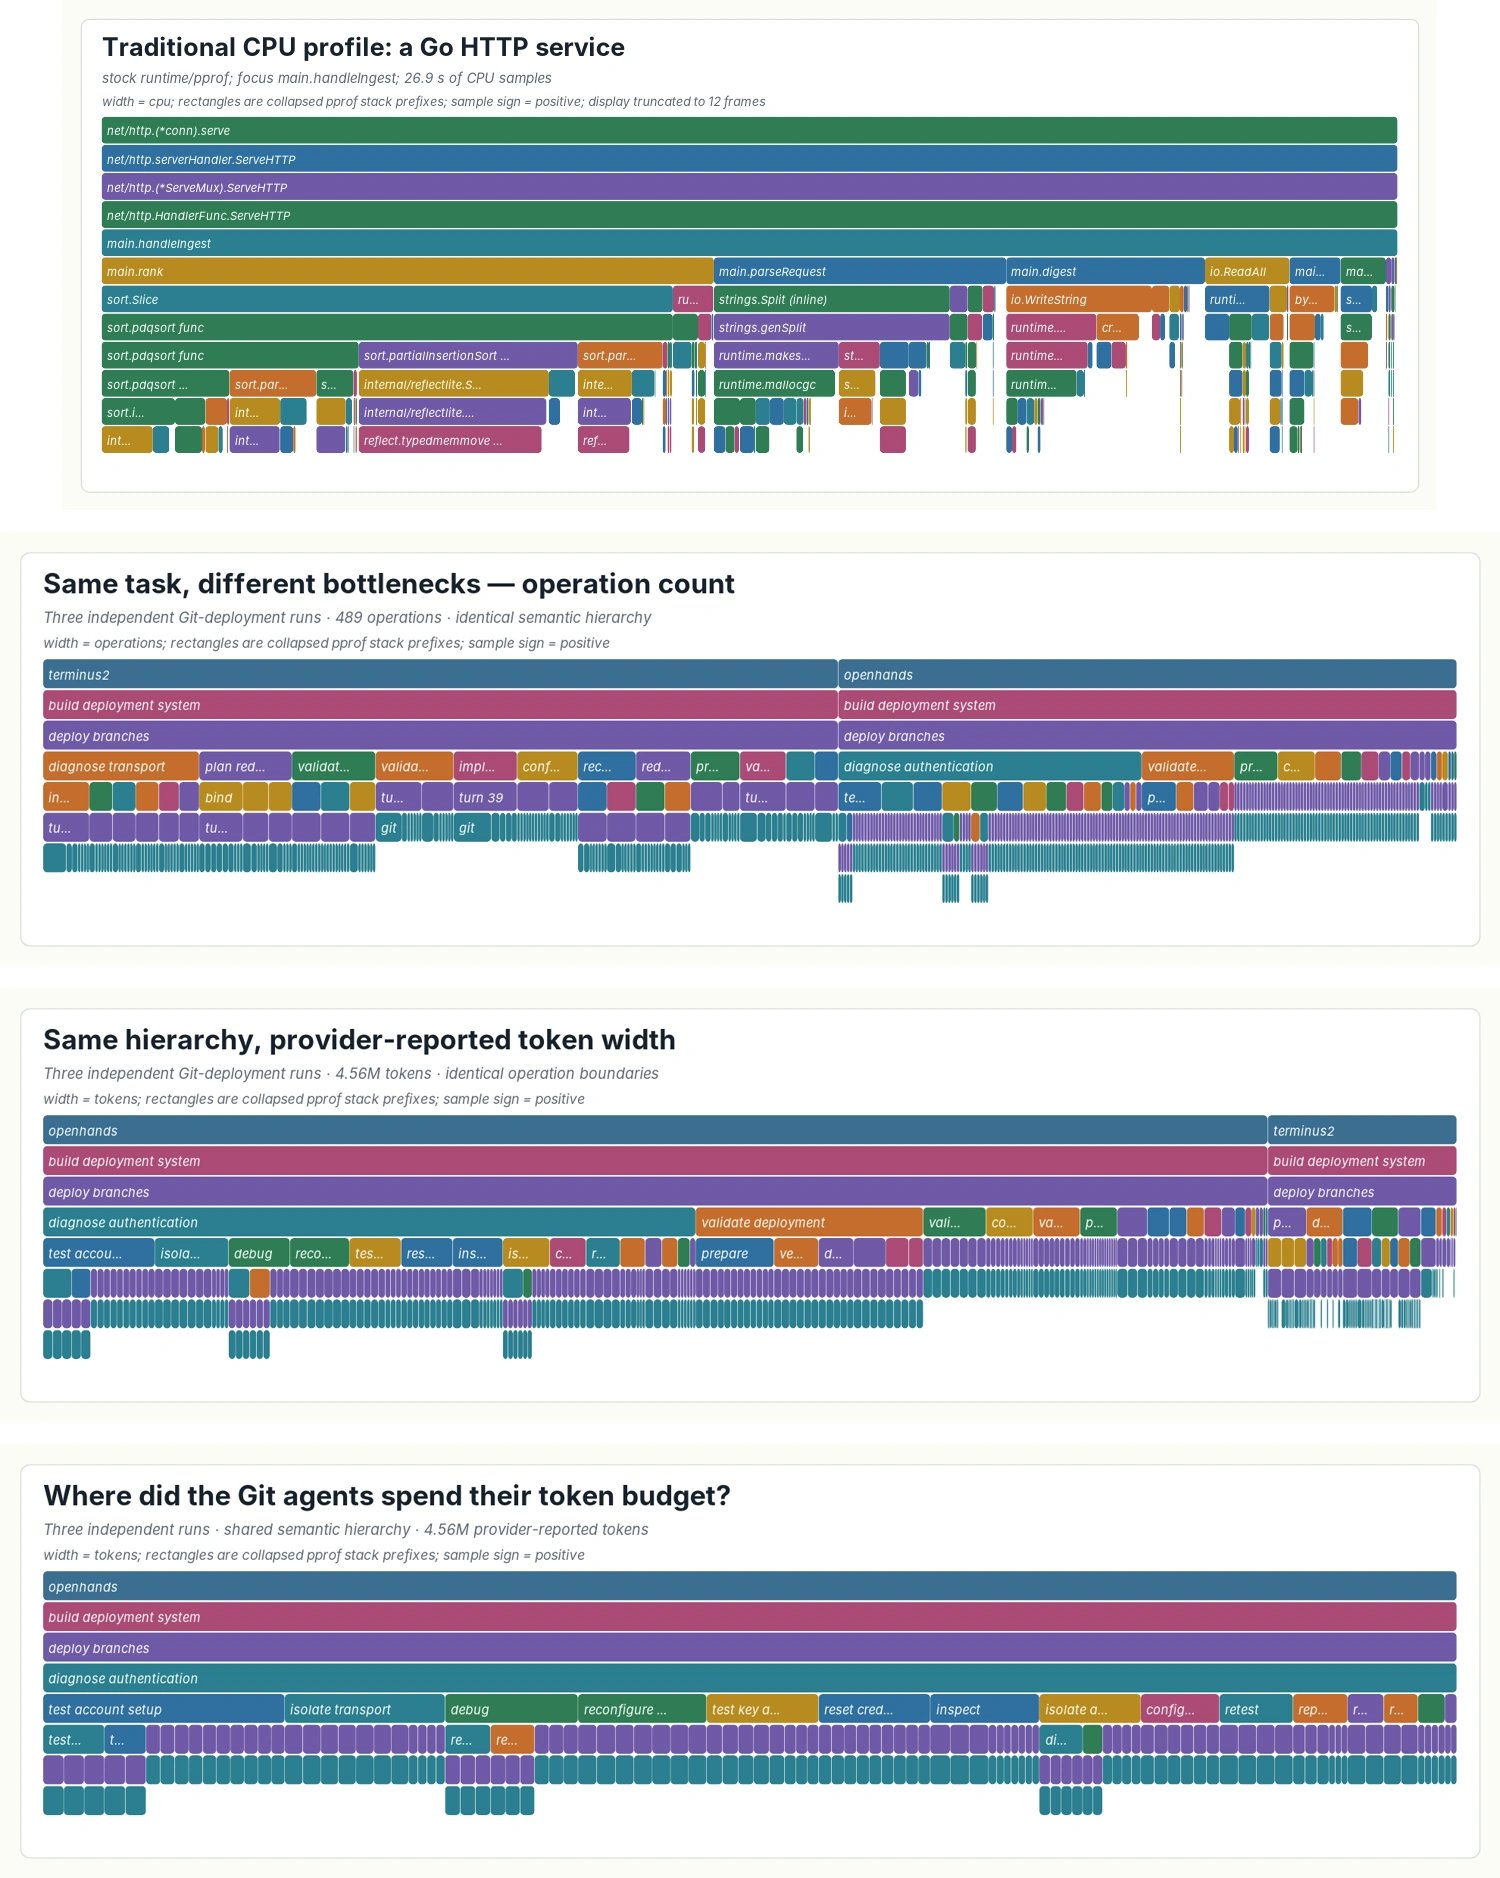
原論文 Figure 1,依 CC BY 4.0 重用。b、c 對相同 Agent 階層更換 operation count 與 token 權重;可以看到「呼叫很多」和「token 花很多」不是同一種熱點。d 將認證任務展開到帳號、傳輸、憑證與重測步驟。來源:arXiv v1, Figure 1, Section 2。
這個例子顯示標籤設計和度量選擇會影響決策。按 operation 數看,廉價但大量的 command 可能壓過少數昂貴的 LLM 回合;按 tokens 看則反過來。兩者都不是唯一正確答案:網路或檔案副作用的風險可能需要另一種 view。pprof 的標準格式提供互動式展開與不同度量切換,但底層 profile 仍只是聚合後的記錄,不能代替原始 trace 或安全審查。
遞迴切分如何產生穩定名稱
作者的結構假設是:一個任務在軌跡中佔一段連續範圍,且可遞迴拆成連續子任務。用序列 表示 steps,切分結果 是一組巢狀區間:任意兩個區間要麼互不重疊,要麼其中一個完整包含另一個;根區間涵蓋整個 session,所有 step 都被覆蓋。每次 在責任變化處切出連續 child intervals,為區間命名,再遞迴處理;若沒有新轉折便停止(Section 3.2)。
語意命名的單位是「責任區間」,不是每一個 prompt。作者讓 Codex 讀取每條軌跡可見的 prompt、command、output summary(不提供 labels 或 scores),以稀疏 marks 描述路徑變更,並可反覆修訂標記直到完成。論文主要評估使用 Codex GPT-5.6-sol-high;這一步會消耗模型 token,也意味所送入的摘要內容必須納入資料治理。工具最後檢查區間巢狀且覆蓋全序列,輸出標準 pprof protobuf;後續投影和折疊是確定性的(Sections 3.2、4)。
這種表示並不宣稱「語言模型知道真實意圖」。它用軌跡內容產生可讀的 operation 名稱,再以人類標註相似度和下游定位任務檢查是否實用。未被切出的語意轉折會把不同責任併在一起;過度切分則會把相同工作拆散。作者的主要 B³ 結果偏向較純但較細的群組:precision 0.793,高於 recall 0.736,且區間邊界 F1 只有 0.480;這比單看 0.764 B³ F1 更能提醒我們邊界並不精確(Table 1;Section 5.3)。
評測如何讀:標註準確度不是唯一問題
論文以三種資料檢查不同主張:真實 coding/web agent 軌跡用來觀察資源歸因;有人工或公開標籤的資料集用來評估語意切分;三個 fault-localization benchmark 用來看 profile 是否補上原診斷的排序訊號。作者稱八個公開 benchmark 與三組真實軌跡;評測標籤和故障答案在模型輸出固定前不公開給方法。資料來源包括 CodeTraceBench、OSWorld-Human、AgentBoard、AgentProcessBench、HINTBench、TraceElephant 等(Section 5)。這些資料範圍廣,但各子實驗的問法與長度不同,不能把一個總分當成單一能力。
觀察失敗時,必須對照成功組
440 條 web-agent 軌跡涵蓋 125 個任務:202 次成功、238 次失敗。作者將同一任務的成功和失敗紀錄配對,共 338 個配對 occurrence,分別建立 profile 後做「失敗減成功」的差分視圖。失敗組有 44.6% steps 落在 recover interaction(重試、重搜、重導航),成功組則為 12.0%。這些失敗行為再被拆成驗證問題、重複搜尋、錯誤導覽和資料重試(Section 5.2;Figure 3)。
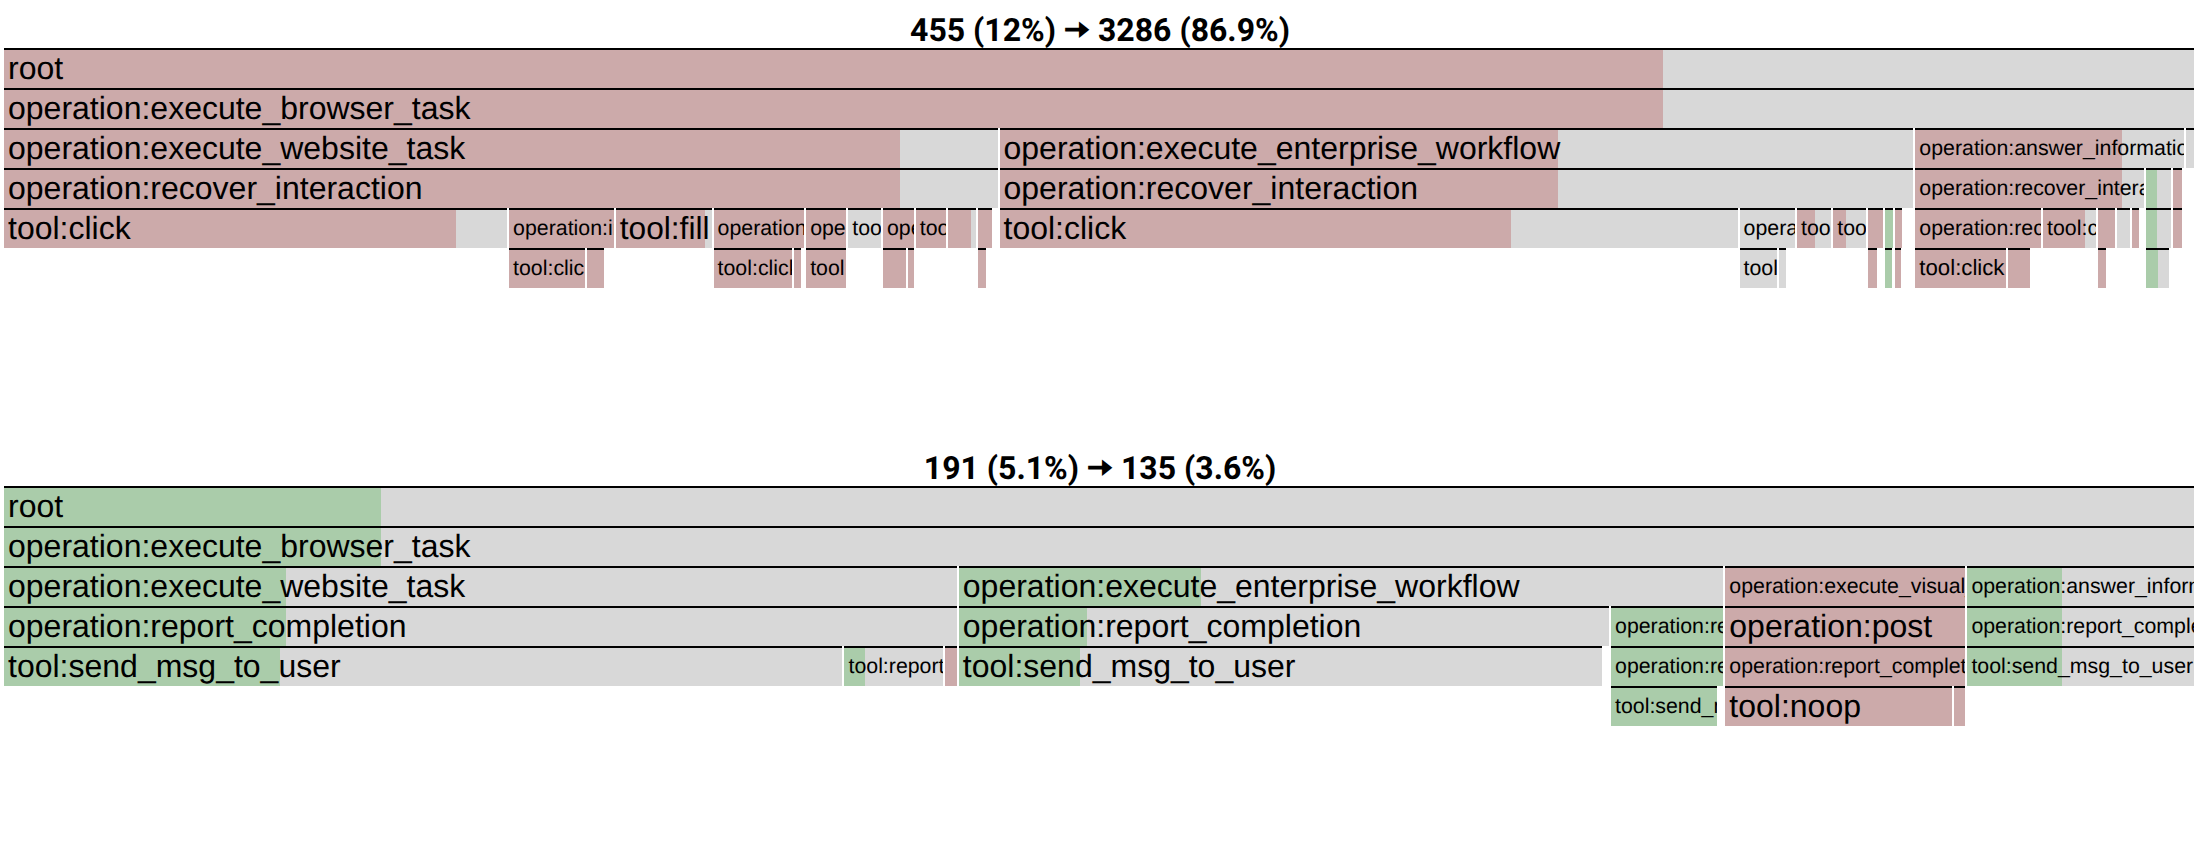
原論文 Figure 3,依 CC BY 4.0 重用。圖以失敗減成功對照,粉色表示失敗側增加、綠色表示成功側增加;寬度合計兩邊貢獻,內框另示淨差。作者並在 435 條軌跡上將差分 profile 與專家 looping 標籤比對,AP 為 .634,隨機基線 .398、差值區間 [.181, .293];固定鏈式重複/錯誤控制則達 .656,顯示偵測 looping 本身未必需要遞迴分群,但後者提供可展開的責任路徑。來源:arXiv v1, Figure 3, Section 5.2。
作者將這看作「失敗 Agent 卡在重試迴圈」的證據。它仍不是對所有 web agent 的失敗原因比例估計:資料來自特定 benchmark、配對程序與專家標籤,而且 fixed-chain baseline 的 AP 略高。遞迴語意階層的增益在可解釋性與來源導覽,而非單一分類分數必然勝出。
Profile 是診斷的補充,不是替代品
在 AgentProcessBench、TraceElephant 與 HINTBench 的完整釋出 test snapshot 中,本文實際使用 536 條論文報告 629 條軌跡;614、400、220 個具可評 fault 的 queries 分別納入 MAP,另外 522 條沒有標記故障 operation 的軌跡只計入資料覆蓋、不進入 MAP。作者比較 benchmark 每條 operation 自帶的 diagnostic(Direct-only)、只用 profiler,以及用 profiler group score 對 Direct-only 並列項目排序(Direct+AgentPProf)。後者比原診斷 MAP 高 0.031、0.107、0.117,論文稱差異具統計顯著性(Figure 4;Section 5.2)。
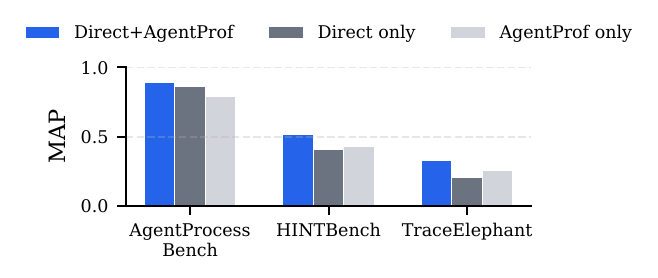
原論文 Figure 4,依 CC BY 4.0 重用。Direct+AgentPProf 在三組資料都高於 Direct-only;這不是只靠 profile 對完整 fault diagnosis 取代 benchmark judge。單位為 MAP,納入 614、400、220 個 queries;越高越好。來源:arXiv v1, Figure 4, Section 5.2。
更直接的取捨出現在 TraceElephant 的 profile-guided reading:完整讀取以 12.6K token/query 達 MAP .502;profile 引導的讀者最多挑五組、只開啟 53% source,MAP .455;改用 raw-action 名稱則開啟 65% source、MAP .465。減少檢視量有代價,少了語意展開也略降排名品質。適合把它當候選篩查或導航,不宜在高風險調查時以 profile 取代完整原始紀錄(Section 5.2)。
從 profile 找到可測的修復位置
在 ToolSandbox 的八個情境中,profile-only 分析者找到一種重複的 call-ID 語法錯誤(21 次工具操作中 5 次),把相容層列為修復目標。研究者用一行修正後,在 23 個保留確認情境上(69 組修復前/後 pair)觀察到 token 減少 19.0%,且固定的官方相似度品質門檻仍通過(Section 5.2)。這是由 profile 啟發並受 held-out 情境確認的案例,不是 profile 自動修好 Agent 的實驗,也不能當成所有工作流程可減少 19% 成本。
切分品質、資源守恆與 profiling 成本
CodeTraceBench 評估包含 405 條軌跡、20,866 個 operation、2,948 個人工標註階段。Codex 切分在 B³ precision / recall / F1 為 0.793 / 0.736 / 0.764;統計 recurrence baseline 為 0.782 / 0.575 / 0.663,raw-action grouping 為 0.891 / 0.388 / 0.541。邊界 F1 上 Codex 為 0.480、最強自動基線 0.266。較高 precision 和相對低 recall 意味切分多半保留較純子區間,但也會把一段工作細分或漏掉部分真實轉折;B³ 和 boundary F1 測的是不同問題,不該以一個分數代替兩者(Table 1;Section 5.3)。
作者也在 OSWorld-Human 上測試不同分割方法:監督式 Naive Bayes 為 0.816 B³ F1、無 LLM recurrence 為 0.786,而不調整的 Codex 指令對較粗任務層次只達 0.448。這說明 framework 可容納不同 segmenter,並非 LLM 一定勝過規則;同時提醒模型與資料粒度不匹配會明顯影響切分(Section 5.3)。
在固定 marks 的前提下,profile 建構可確定性重放。作者報告 27,765-operation 聯集建構時間 1.16 秒、峰值 RSS 465 MiB;440 條軌跡的 operations 與 tokens view 分別耗時 0.26 與 0.25 秒。較大的成本是一次性自動語意標註:Codex 在最多四個 worker 下,以 37 分鐘完成 405 條 CodeTraceBench 軌跡;每條平均輸入 29,754 token、輸出 573 token。選取精簡骨架加關鍵輸出,和提供每個 turn 完整內容相比,在 32 個 held-out task clusters 上降低 provider token 20.4%,且符合預設 B³、boundary F1 的品質界線(Section 5.4)。
對營運團隊,這代表「profile 查詢快」不等於「建立語意 profile 免費」。若軌跡天天新增,需決定哪些資料重標、如何快取、何時人工抽查、是否改用統計 segmenter,以及供應商資料政策是否允許送入命令與輸出摘要。成本要用實際的 model、token price、cache policy 和資料保留設定重新量測;作者 2026 年的 token 數與時間不等於今日採購成本。
證據地圖與結論邊界
| 問題 | 論文證據 | 證據支持什麼 | 不支持什麼 |
|---|---|---|---|
| 語意切分能否接近人工階段標籤? | CodeTraceBench 405 條,Table 1;B³ F1 .764、boundary F1 .480 | 此資料與切分協定下,Codex 路徑分組比所列自動基線有較高 stage 相似度 | 所有 Agent 家族和任務上都能產生同樣品質的 intent label |
| Profile 是否指出失敗常見行為? | 440 web runs,Figure 3;恢復動作佔失敗 .446、成功 .120;435 條 looping expert labels | 這個 benchmark 裡,profile 差分反映重試類型行為,並能導航回 source | 重試造成失敗,或 44.6% 是生產系統的普遍故障率 |
| 能否改善 fault ranking? | 三個 benchmark 的 Figure 4;Direct+profile 相對 Direct-only MAP +.031/+.107/+.117 | 在此排序設計中,profile 分群訊號能補充既有 diagnostic | profile 單獨比人工/judge 診斷好,或可取代逐次除錯 |
| profile 可以降低成本嗎? | ToolSandbox 修復前後 23 個確認情境;token -19%,品質門檻不變 | 一個 profile 引導的修復在保留組上減少 token,品質符合固定門檻 | 所有修復或任務都能省 19%,或改善幅度可外推 |
| 建構是否夠輕量? | 405 條切分 37 分鐘;固定 marks 後 profile 建構約秒級 | 語意切分是主要成本,後續多視圖可快速重播 | 任何資料規模、model API 與部署都具相同吞吐或成本 |
主要限制:寬度不是因果,名稱不是 ground truth
- 任務連續性是假設。 遞迴區間假設責任會在軌跡中形成相鄰範圍。如果 Agent 在多個子任務間交錯、平行執行或延遲補做,區間模型可能不自然,甚至把不相關動作放進同一個語意父節點。
- 標籤標準仍需治理。 不同提示如何命名「同一工作」、什麼層級算一個任務,都可能改變折疊後的 profile。作者用 CodeTraceBench 人工 stage 衡量一致性,但 B³ F1 不等於語意正確率,boundary F1 也只到 0.480。
- 歸因不等於因果。 即使 token 寬度完全守恆,某任務佔 46% token 只能表示依該路徑聚合的消耗,不代表它導致總成本超支或造成部署失敗。診斷應回到 operation 和原始內容交叉檢查。
- 樣本和長期範圍不均。 論文混合 benchmark 短中型 trajectories(平均 8–52 operations)及作者工作站長期 session;長期資料的一部分來自單一開發者。不同團隊、模型、工具及企業政策下的跨平台穩定性尚未驗證。
- 人工/模型成本不可略去。 主切分使用 GPT-5.6-sol-high;資料讀取和 prompt 摘要可能涉及機密。profile 省下的診斷時間須和標註費、隱私審查、錯誤標籤返工一起估算。
- 預印本附錄可見性有限。 arXiv v1 的工作論文提供主文與表圖,但技術附錄內容在所列工作稿中被註解停用;若要完全重現標註 prompt、統計檢查或所有成本細節,需確認作者釋出的補充材料與程式版本。
Artifact 與可重現性
截至 2026 年 10 月 5 日,arXiv v1 可公開取得,論文指向的 AgentSight repository 也公開且採 MIT License。該 repository 後續已有發布版,現行 ext/pprof 提供 agentpprof CLI,可讀取本機 Codex/Claude Code 歷史、產生 pprof 等輸出,並以規則標籤或 local LLM 進行分類。這證明同一專案仍有可使用的 profiling artifact,不代表現行版本逐行等同論文 v1。公開 repository 未固定論文實驗所用的精確 commit、資料快照與模型環境,重現者需要另外釐清版本映射;本文引用的 benchmark 結果仍是作者報告,沒有獨立重跑。
論文描述的切分流程將 prompt、command 與 output summary 交給 Codex 標註;現行 repository 則提供較新的 tagger 與操作路徑。部署前請比對所用 release/commit 與論文設定,特別是標籤演算法是否相同。即使 profile 建構在本機,標註若呼叫 hosted model 仍會將必要摘要送往該 provider;使用 local model、明確 session-file 清單或在本機 regex 規則可縮小資料外送面,但不自動保證原始 session 檔安全。
隱私界線需特別留意:AgentSight README 和 profiling guide 提醒歷史紀錄可能含 prompt、response、command、路徑、header 和 network target;預設 pprof/SVG 輸出雖通常保留標籤和權重而不帶 raw prompt,語意標籤仍可能洩漏專案或使用者資訊。若採 live eBPF 路徑,現行文件要求 Linux 權限;具體支援狀態依 agent 與平台而異。企業使用時應先確定資料最小化、access control、保留期限、provider 條款、遮罩與匯出政策,並將原始 trace 和 profile 都視為敏感資料。本篇結果是作者報告,不是獨立重跑。
Bloss0m 工程判斷:把 Profile 當作索引,不當作裁決
以下是 Bloss0m 工程化整理,不是作者宣稱的通用 rollout recipe:
- 先挑一種具體決策(例如成本歸因或重試故障),明確選 token、時間或副作用數量;一次查看多種 width 可以避免把「便宜但頻繁」和「昂貴但稀少」混成同一個熱點。
- 定義標籤層級、連續區間規則與人工抽樣檢查方式。保存抽樣 trace、segmenter/tagger 版本、修改紀錄與信心標記,特別留意任務切換、並行子 Agent 和長時間等待。
- 以 profile 找候選路徑,再沿每條路徑回到具體 operation 和 trace;對成本或安全修復做保留組測試。只有介入後在品質、成本、失敗率等預先選定指標上變好,才能說變更有用。
- 在導入前先決定原始資料和標籤的存取權限、期限與可匯出欄位。profile 的 label 可能比原文更匿名,卻仍可暴露 repo、客戶、任務類型或事故線索。
不適合把它當成線上風險自動阻擋器、因果分析器、跨模型通用任務 ontology,或只看彙總圖就替 Agent/工程師究責的依據。若任務交錯而不連續、資料無法在本機或授權模型下分析,或沒有可追溯回 source operation 的條件,應先使用一般 trace 和人工抽樣。
若想延伸閱讀,可參考Agent 追蹤紀錄可能被代理修改的威脅與評估;兩篇各自研究不同問題,但都提醒「拿來觀察的資料本身」需要明確信任邊界。評測面可接著讀 GameLogicBench:用逐 tick 行為斷言測試遊戲邏輯程式,比較輸出彙總和可執行行為評分所能支持的主張差異。
讀完後的三個記憶點
- 技術想法:AgentPProf 用 operation 和語意巢狀區間補出 Agent 軌跡欠缺的穩定責任路徑,再投影到 pprof 兼容的 stack。
- 證據:405 條 CodeTraceBench 軌跡達到作者報告的 0.764 B³ F1;三個 fault-localization benchmark 中,profile 結合原 diagnostic 提升 MAP,但不是取代原診斷。
- 邊界:區間標籤、來源軌跡與可加度量的解讀都需要人工治理;圖上的面積不是根因,程式可取得也不等於 paper 結果已獨立重現。
Primary sources
- Zheng, Yusheng; Chang, Chaokun; Mao, Yu; Wu, Tianyuan; Huang, Yuxi; Ma, Tao; Mao, Wenan; Cheng, Shuyi; Quinn, Andi; Wang, Wei. “AgentPProf: Semantic Profiler for Long Horizon AI Agents”, arXiv:2609.20301v1, submitted 14 September 2026. Full text and Figures 1–4, licensed CC BY 4.0.
- AgentSight source repository, MIT License; see the current agentpprof guide and privacy/redaction notes for the later implementation and data boundary.