論文精讀
Raven 精讀:Harness of Harnesses 如何規劃多 Agent 協作
原文:Raven: The Harness of Harnesses for Composable Agentic Intelligence
90 秒掌握論文
- 問題:把更多 agent 接進 workflow,不會自動得到更可靠的系統。主控者必須選對專才、拆對子任務、安排前後依賴,也得知道何時不要平行化;否則多一層協作只會多出呼叫、等待、狀態同步與失敗面。
- 核心想法:Raven 把「agent」定義成可執行的模型與 harness 配對。Harness 包括工具、上下文管理、記憶、技能、政策和復原方式。Host Agent 依照這些 specialist 的能力規格建立有向無環圖(DAG),再由執行層驗證圖是否可接受。
- 主要證據:作者建立 Multi-Agent Orchestration Benchmark(MAOB),包含 140 個職業情境任務與經審閱的參考 DAG。在 Qwen3.8-27B 與 DeepSeek-V4-Flash-0731 兩種 backbone 的配對測試中,Raven 的 exact graph match 分別比最強基線高 10.4 與 10.5 個百分點。
- 最重要的限制:MAOB 在派發 workers 以前就結束評分。它量的是 specialist 節點和任務依賴圖與參考圖有多接近,不是子 agent 執行後能否完成任務、最終內容是否正確或多 Agent 的總成本是否較低。Repo 仍標示 pre-alpha,目前沒有獨立重跑證據。
這篇論文最適合用來回答的,不是「Raven 是否已經證明多 Agent 比單 Agent 強」,而是「如果我們要組合一群不同 harness 的 agent,規劃器要先把什麼想清楚,現有評測又到底量到了哪一層?」它把模型、工具和執行方式一起視為 specialist,並讓主控者輸出包含節點、輸入與依賴關係的 DAG。然後作者用 MAOB 量測這張圖是否和人工審閱的參考圖吻合。這個切分有工程價值:規劃本身可以先被測,但圖的品質仍只是系統成功的前置條件,不等於執行結果。
以下精讀依據 2026 年 9 月 27 日提交的 arXiv v1。作者欄列為 EverMind AI;目前檢視到的來源沒有建立同儕審查或正式接收狀態。論文提供 Apache-2.0 公開 repo,但專案 README 標示 pre-alpha;可檢查程式不等於 MAOB 結果已由外部團隊重現。
既有做法為什麼不夠:模型選擇和自由委派都缺少可檢查的協作契約
只比較 foundation model,會把工具、記憶、技能與錯誤復原造成的差異藏起來;但若把多個 agent 直接接成自由對話,也很難知道誰負責哪一項工作、哪些結果是下游前置條件,以及失敗後如何定位。另一種簡單基線是把所有子任務平行丟出去,可是任務之間可能有資料依賴:讓「實作」早於「規格確認」,即使兩個 worker 都完成回覆,流程仍可能錯。固定 workflow 可以明確表達順序,卻不一定能因應每個請求需要不同領域的 specialist。
這些是 Raven 要處理的設計張力,不代表論文證明所有既有系統都無法協作。它提出的折衷是將 model–harness pair 放進能力目錄,再由 Host 對單一請求產生有依賴關係的計畫,最後由 runtime 在執行前檢查契約。這讓分工和順序較可見,但也增加 Host 規劃、圖驗證、狀態追蹤與協調成本;MAOB 只直接評估其中的規劃圖,不會回答整套折衷在真實執行後是否划算。
核心直覺:先決定「誰做什麼、依賴什麼」,再讓工作開始
可以把 Raven 想成一間有多個專業工作台的工作室。每個工作台不只是某位專家(模型),還包含它可使用的工具、操作規則、資料記憶方式與失敗復原方法(harness)。接案的 Host 先看任務,把工作拆成節點,再畫出哪些節點要等哪些產物;runtime 確認節點有可用工作台、相依關係沒有循環,才開始派工。
這個心智模型有兩個不同的品質問題。第一,圖是否把任務拆得合理,specialist 和依賴有沒有選對;第二,實際工作台能否把節點做好,最終結果是否通過驗收。MAOB 比較的是第一個問題,而且以作者整理的參考圖作為評分對象。若把它的 exact-match 分數當成第二個問題的答案,就把規劃品質誤認為完成品質。
從「換一個模型」到「組合一個 specialist」
Harness 為何也是能力的一部分
平常談 agent,常把模型名稱當成能力的代理變數;但同一個模型接上不同工具、記憶、系統提示、技能載入方式、政策檢查與錯誤復原,實際上可能成為完全不同的執行單位。論文把這個單位稱為 executable agent,核心是模型與 harness 的配對。換句話說,specialist 不只是「會寫程式的模型」或「會查資料的模型」,而是「某個模型在某組工具、上下文規則和復原機制下,可以被主控者呼叫的執行介面」。
這種定義把架構責任拆成兩層。底層 specialist harness 負責在某個領域內執行工作;上層 Host Agent 則面對整體請求,選擇 specialist、說明交接內容、標出依賴關係,並在工具結果或例外回來後繼續協調。Host 並非只是把問題丟給多個模型的「群聊 moderator」;它是在一個有能力目錄、執行限制與資源預算的系統中產生計畫。
論文 Figure 2 將這個構想放在完整的 Raven 生態中:多個 model–harness pair 提供不同的可執行能力,由 Host Agent 產生協作圖,之後才交給 runtime 執行。圖中所示的是作者提出的架構,不是 MAOB 的成功率結果,也不代表所有列出的 specialist 都在同一個 benchmark 內經過相同程度的驗證。
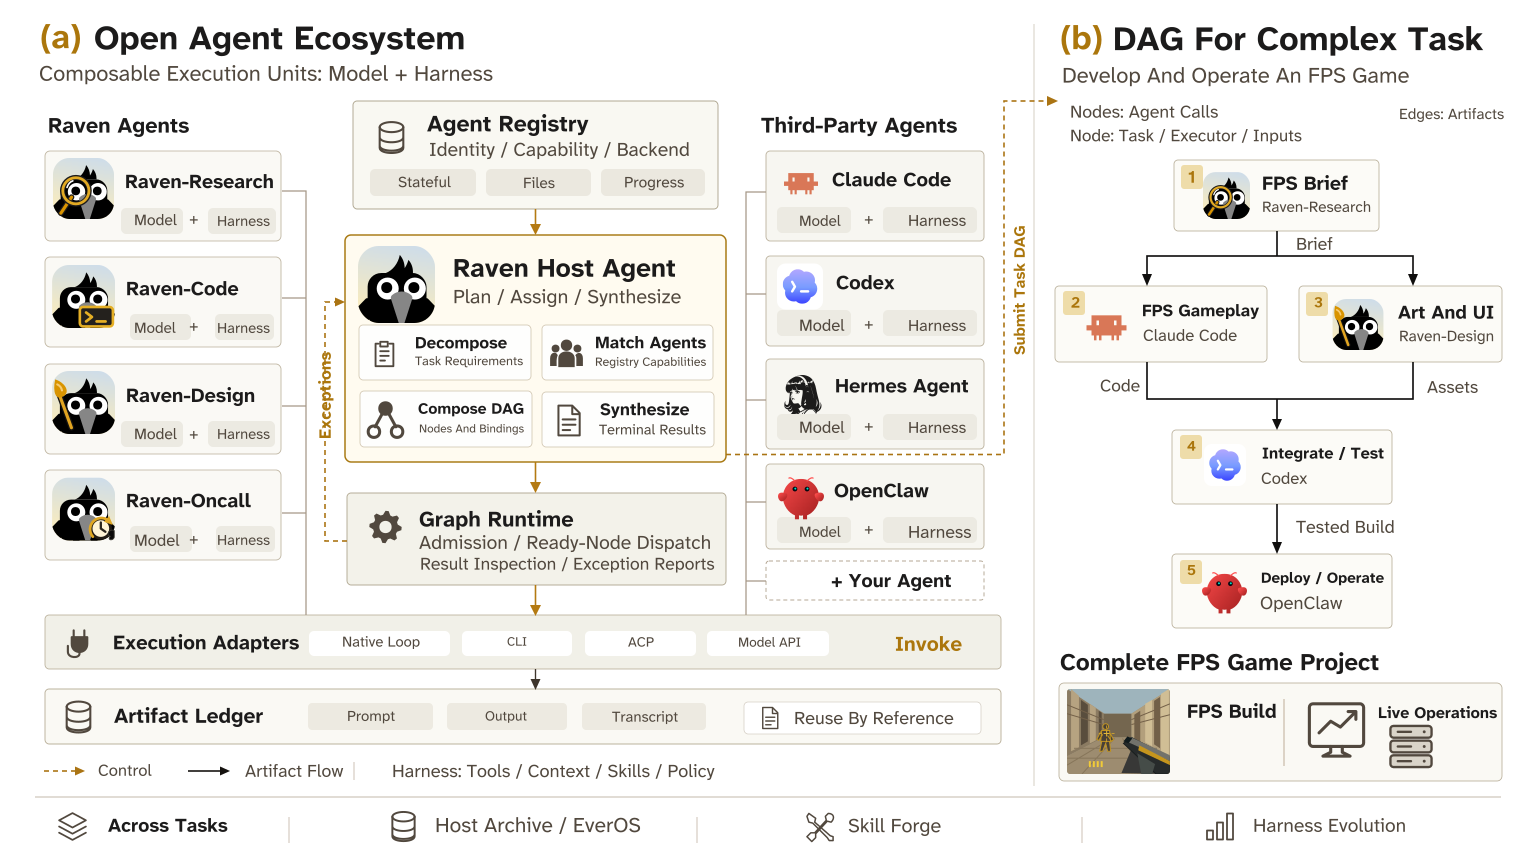
原論文 Figure 2,未修改重用。來源:Raven v1, Figure 2,© EverMind AI,CC BY 4.0。圖示系統概念;效能數字請看後文 MAOB 實驗,不能由架構圖推定。
把任務寫成 DAG,而不是一串平行 prompt
假設使用者要求「研究一個開源 agent 專案的安全邊界,修改一段設定範例,再寫一份維運交接」。在 Raven 的表達方式中,Host 可規劃研究、程式修改、內容撰寫或 on-call 類的工作節點;有些工作可以並行,有些必須等前一個產物出現後才開始。最後要交付的不是若干互不相干的模型回答,而是由節點、輸入、輸出與依賴關係組成的任務圖。
簡化的 DAG 可以記成 : 是 specialist 工作節點, 表示某節點需要另一節點先完成。若研究節點 先產出被核對的結論,程式節點 和文件節點 才能以該結論為輸入;最終整合節點 等待兩者完成。 與 是否能同時執行,取決於它們真正共享哪些前置輸入,而不是 Host 覺得「多開幾個 agent 比較有效率」。
這也解釋為什麼 Raven 的 benchmark 不只看「選了哪幾個 specialist」。若任務要求先診斷、再修改、最後驗證,只選對三類專才卻把順序排錯,仍可能無法得到可執行的計畫。反過來,參考圖的邊也不必然是唯一合法解:兩項工作有時能以不同的有效順序完成。論文因此報告節點、邊、partial-order 和 exact graph 等多個指標,並在圖匹配中以被接受的偏序關係評估,而非只比較原始邊字串是否完全一致。
方法流程:從使用者請求到可檢查的執行結果
論文描述的系統路徑可以按下列順序重建。這是 Raven 的架構流程,不是 MAOB 中 workers 已完成任務的證據:
- 讀取請求與能力目錄:Host 取得任務內容和已註冊 specialist 的描述。系統會先載入精簡的 orchestration guide;只有在判斷需要多 Agent 圖時,才載入較完整的協調指引。
- 選擇 specialist 並拆分任務:Host 將請求轉成節點,為節點指定 agent、摘要、prompt template、輸入與共享執行資訊。節點代表工作,不應只複製一個 prompt 給不同模型。
- 表達依賴與資源限制:Host 連接有先後關係的工作,形成 DAG;對可平行節點保留並行空間,同時受執行環境、預算與 approval 條件約束。
- Planning admission / preflight:runtime 檢查 schema、唯一 ID、循環、依賴與路徑引用、agent 註冊/啟用狀態和 capability。失敗時在執行前回覆可定位的拒絕原因,不啟動部分 worker。
- 派發 ready nodes:只有依賴完成、verdict 狀態允許且 concurrency semaphore 有空位的節點可執行。各 specialist 執行自己的 harness,並把輸出與產物回交 runtime。
- 判斷狀態、保留 artifact、處理例外:judge 根據 prompt、輸出與對話尾端提供流程 verdict;runtime 更新節點狀態。完成產物可由下游引用,exception 則交回 Host 決定續行、停止或重規劃。
- 整合與驗收:Host 可以整理各節點產物,但對品質的最終判斷仍需適合該任務的 verifier、測試或人工核准。論文的 MAOB 規劃比較停在第 3 步附近,沒有用這 140 個任務證明後續 worker 結果。
把這條流程和 benchmark 對齊,能看到它們回答不同問題:圖的節點與邊可測 Host 是否理解任務結構;admission 可測計畫是否符合可執行契約;節點完成與 verifier 才涉及工作結果。不能用較早階段的分數替後面階段背書。
Planning admission:runtime 不會盲目照單全收
Raven 的規劃與執行邊界,是文章中最容易被「它會自己找專家合作」這種敘述模糊掉的地方。Host 先列出任務節點、每個節點所屬的 specialist、任務摘要、prompt template、依賴、輸入與可選的共享 instance。執行層會先檢查計畫格式和 schema、節點 ID 是否唯一、圖是否有循環、相依節點是否存在、路徑引用是否合法,以及相應 agent 是否已註冊、啟用並具備所需能力。計畫若不符合條件,runtime 會回傳聚焦在首個錯誤的拒絕訊息;這個 admission 階段不會先啟動部分 workers 再發現整張圖不能執行。
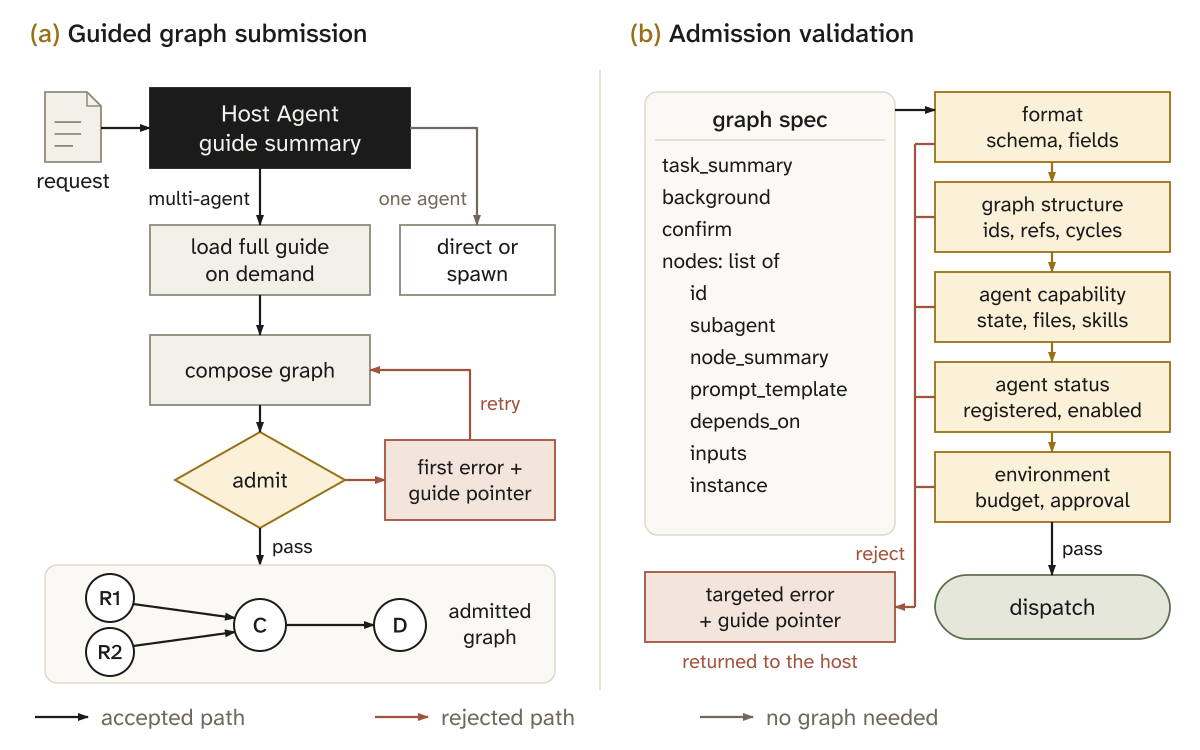
原論文 Figure 4,未修改重用。來源:Raven v1, Figure 4,© EverMind AI,CC BY 4.0。這是計畫准入與檢查流程示意,不是 benchmark 對錯率。
這種設計的價值不是「schema 驗證就能保證計畫正確」,而是把一部分錯誤轉成執行前能拒絕的結構性錯誤。循環依賴、未註冊的 specialist、無效 ID 或不支援的能力,理應在昂貴工作開始前被擋下。相對地,「這個任務是否真的該交給 coding specialist?」、「研究輸入是否足以支持後續修改?」則是語意與目標正確性問題,結構驗證本身回答不了。
節點狀態與例外如何留在圖裡
進入執行後,節點會經過 pending、running、completed、exception、failed、skipped 或 cancelled 等狀態。節點通常要在依賴都完成、且相關 verdict 已定案後,才會成為可執行工作。完成節點的 artifact 可以被後續節點引用,已經完成的部分可保留,而不是每次重規劃就全部重跑。遇到 exception 時,Host 可以繼續、放棄該工作或重新規劃;這使例外成為可見的協調狀態,而不是藏在一串長對話紀錄裡。
但「節點狀態是 completed」仍不等於客觀任務成功。論文的 completion judge 會檢視渲染後的 prompt、輸出和對話紀錄尾端,判斷節點是否完成;它是 runtime 的流程訊號,不是外部真值 oracle。論文還描述 judge 逾時或失敗時的 fallback,可能以一般回覆路徑標記完成。這種容錯避免整個流程因 judge 故障而停擺,代價則是完成狀態更不能被當成品質證明。對寫檔、部署、資安或其他高風險節點,仍須有獨立測試、產物檢查、權限邊界或人類核准。
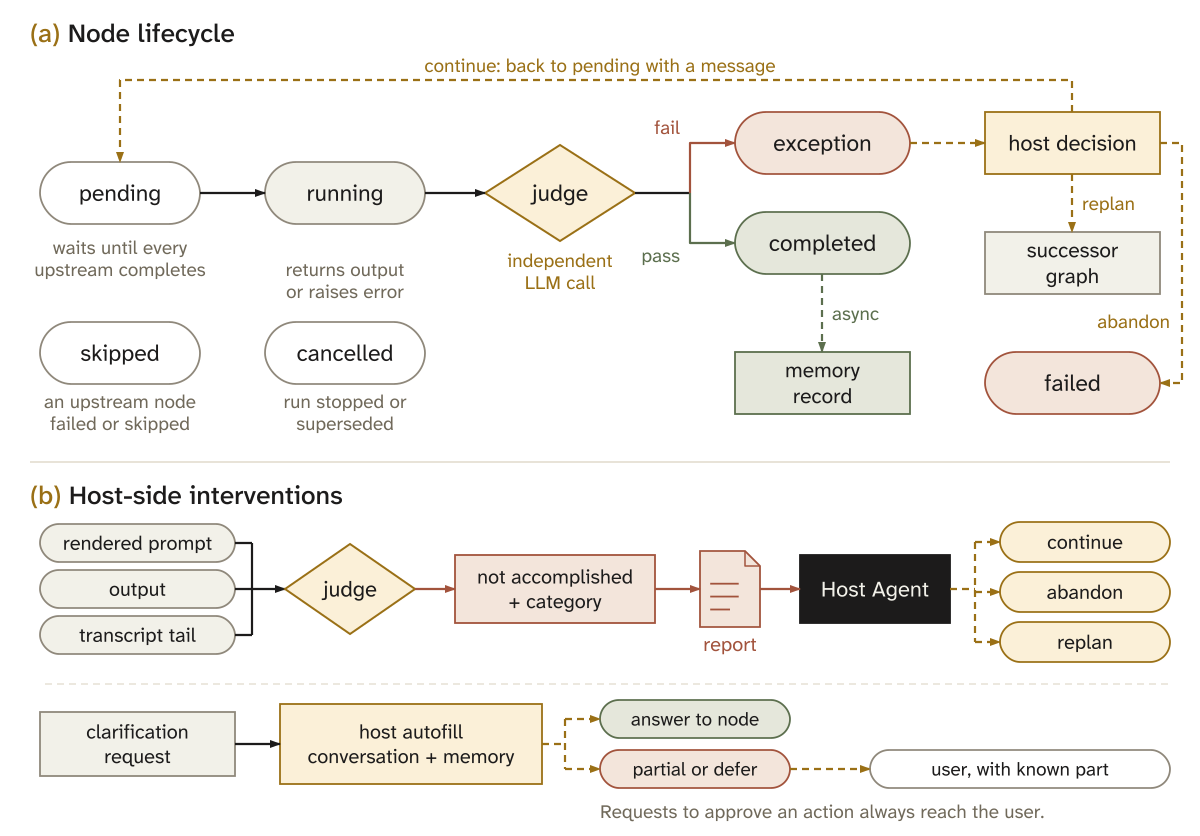
原論文 Figure 5,未修改重用。來源:Raven v1, Figure 5,© EverMind AI,CC BY 4.0。圖示 runtime lifecycle;completed 是控制流程狀態,不等同於獨立驗證的正確性。
MAOB 到底在測什麼
140 個職業情境、四個 specialist 領域
Multi-Agent Orchestration Benchmark(MAOB)是 Raven 論文評估 Host 規劃品質的核心。論文描述 140 個職業啟發的使用情境,涵蓋 137 種職業,建立人工審閱的 specialist 節點與依賴參考圖。四個主要 specialist domain 是 research、coding、content production 與 on-call execution。每個情境平均約 2.72 個節點、1.84 條依賴邊;作者也報告任務跨兩個、三個或四個領域的分布,並包含有序串行與允許平行的案例。
這個 benchmark 的設計,刻意讓計畫可以在執行前比較。它不是讓一群 agent 真的完成每項工作,再由人類評審成品品質;而是把使用者請求交給規劃器,取得 specialist 節點和關係圖,與審閱過的參考結構比較。這種方法成本相對可控,也讓「拆解任務」這個子問題變得可量測;另一方面,參考答案與規劃答案之間的相似度,只能作為某一種規劃品質指標。
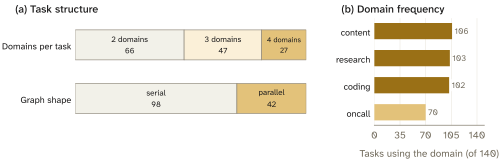
原論文 Figure 12,未修改重用。來源:Raven v1, Figure 12,© EverMind AI,CC BY 4.0。圖表描述 MAOB 任務/圖的組成;benchmark 由論文作者建立,不是外部機構的獨立樣本。
作者先從公開職業任務資料抽取 pattern,建立 template 和可能的 graph;接著先固定 reference graph,再由 GLM-5.2 反向生成請求文字,並以 Claude Opus 5 參與參考圖製作,最後做漏洩過濾與審閱。先定圖再寫請求,有助避免模型看到一段明示步驟後照抄答案;但它也表示 benchmark 的目標結構是作者流程先定義的。自動詞彙過濾不能排除所有改寫後的規劃提示,圖先行也不能證明參考圖唯一或完全合理。
作者稱任務經過自動品質檢查與專家審閱,包括節點、偏序與歸屬的檢查。這比完全未審核的合成圖更可信,但仍留下幾個需要讀者記住的邊界:資料集和參考圖來自作者的設計流程;目前檢視到的材料沒有提供外部團隊對完整參考圖標註的獨立一致性研究;每個任務也可能有多種同樣合理的分解方式。作者用偏序接受部分不同排序,是對「不只有一條合法路徑」的部分處理,卻不會自動涵蓋所有合理節點抽象或替代計畫。
四種圖指標各回答不同問題
- Node F1:規劃器是否選到參考圖中重要的 specialist 工作節點?它關注「做哪些事」,不是先後順序。
- Edge F1:預測的依賴邊與參考依賴邊相符多少?它關注明確連線,但對表示法和等價排序較敏感。
- Partial-Order Accuracy(POA):在節點對的順序關係上,預測是否符合可接受的偏序。它容許部分不必互相排序的工作保持獨立。
- Exact Match:節點集合和被接受的偏序關係整體符合參考圖的任務比例。它是嚴格的整體匹配指標,但不是 execution success。
指標的分母不必都等於 140。Node 或 edge 級別的指標會按可評估元素計算,任務級 exact match 才是整體圖是否符合的比例。閱讀摘要數字時,應保留論文的指標定義與評分單位,不要把所有分數都叫成「任務成功率」。
+10.4/+10.5 個百分點:是一項規劃結果,不是端到端勝率
作者以相同任務和相同 delegation instruction 比較 Raven、Claude Code、Hermes Agent,並使用兩個 backbone:Qwen3.8-27B 與 DeepSeek-V4-Flash-0731。各系統保留其原生 orchestration 介面;領域細節則透過各自的介面提供。這個配對設計有一個重要優點:不會只讓 Raven 使用較強模型、基線使用較弱模型,再把差異全算在 harness 上。不過系統介面本身仍不同,因此結果反映整套規劃方法及其配對實作,而非只替某個抽象演算法做無環境的單變數檢驗。
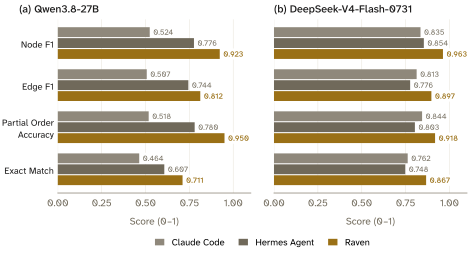
原論文 Figure 13,未修改重用。來源:Raven v1, Figure 13,© EverMind AI,CC BY 4.0。圖示作者報告的 planner-only MAOB 指標;exact match 的百分點差不是最終任務成功率差。
在 Qwen3.8-27B 設定下,Raven exact match 為 0.711,最強基線為 0.607,差 10.4 個百分點;在 DeepSeek-V4-Flash-0731 設定下,Raven 為 0.867,最強基線為 0.762,差 10.5 個百分點。論文也報告 Raven 在這兩個設定的四種 MAOB 圖指標領先。這些數字能支持的是:在這份 MAOB、這些 prompts、這兩個 backbone 及作者的比較實作下,Raven 產生的規劃圖更常符合評分參考。
它不能支持以下更大的推論:Raven 的 agent 任務成功率增加十個百分點、實際多步 workflow 的品質同步提升、workers 執行錯誤變少、總 token 或延遲下降,或任何模型加任何 harness 都能得到同樣增益。MAOB 的 workers 根本沒有被 dispatch,因此 execution quality 和 planning score 在這項比較裡不是同一個觀測量。
具體例子:走完整個方法,把「做網站安全設定」轉成可檢查工作圖
以下是為說明 DAG 構造而編寫的教學例子,不是論文中的 MAOB 任務,也不是 Raven 測得的案例。假設需求是替網站啟用一項安全防護,並交付變更紀錄與回復方案。Host 先需要知道 specialist registry 中有哪些能力,例如文件研究、程式/設定修改、測試和維運審查。合理的圖可能是:
- 研究與規格確認:核對現有架構、供應商文件、環境差異與限制,輸出有來源的設定要求。
- 變更計畫:依據已確認的要求列出要修改的設定、影響範圍和回復步驟。這一步依賴研究結果。
- 設定與範例修改:在受控環境準備變更,不能因為 coding specialist 可以編輯檔案就自動獲得正式環境寫入權。
- 測試與維運檢查:確認新設定與既有行為,檢查失敗時回復路徑。它要等候變更 artifact,但可以與文件整理部分平行。
- 整合交付:把證據、變更差異、測試結果與剩餘風險整理給使用者。
圖可以表示為 ,另讓不依賴修改結果的文件任務與測試前準備平行。真正部署要不要由 agent 執行,則是權限和審批政策,不該隱含在依賴圖中。這個例子說明 DAG 把工作順序變明確,卻不會自行回答「研究來源可信嗎」、「變更是否安全」或「誰批准寫入」。
把這例子拿來讀 Raven,可以分出三個檢查層:第一,planning 是否挑到必要工作且依賴合理;第二,admission/runtime 是否只接受結構上可執行、能力已註冊的計畫,並尊重預算與核准邊界;第三,execution/verification 是否真實完成並通過對應測試。MAOB 主要測第一層;論文的 runtime 設計討論第二層;這並不等於 MAOB 同時驗證了第三層。
證據地圖:論文主張、實測、推論和未證明事項
| 證據層 | 本文可以怎麼說 | 不應延伸成什麼 |
|---|---|---|
| MAOB 直接比較 | 在作者建立的 140 個任務與兩個配對 backbone 上,Raven 的參考圖匹配指標領先所比較的系統;exact match 差距為 +10.4/+10.5 個百分點。 | Raven 的端到端任務成功率提高十個百分點,或實際產出比基線正確。 |
| 系統設計 | Raven 將 model–harness pair 作為可組合 specialist,以 Host 規劃依賴 DAG,並在 dispatch 前檢查計畫結構與 agent capability。 | schema preflight 能判定目標正確、來源可靠或最終 artifact 符合需求。 |
| 理論分析 | 論文在共享資源預算及其成立條件下,討論互補能力組合如何擴大可可靠處理的任務範圍,並把規劃與執行誤差納入條件式界限。 | 理論結果保證任意多 Agent 系統總比單 Agent 好,或提供 MAOB 的實證成功率。 |
| 作者其他元件結果 | 論文亦討論 specialist 執行、harness evolution 和 skill reuse;其中部分結果承接 HarnessBank、SkillCorpus 等先前工作,需和新做的 MAOB 規劃比較分開讀。 | 把所有組件結果都說成這次 Raven MAOB 的新實驗或獨立重現。 |
| Bloss0m 工程解讀 | 多 Agent 平台可先記錄計畫圖、接受/拒絕原因、節點狀態、artifact provenance,再用 execution-level 成功與成本指標做第二階段評估。 | 這是作者已驗證的 Raven production policy 或普遍適用標準。 |
理論部分值得讀,但要避免把條件式命題變成通用口號。Host-level reliability 命題可概括為:
是 Host 組合系統在共同預算 下交付可被任務 verifier 接受之結果的機率; 上界描述 Host 沒選到有效計畫的風險; 則界定有效計畫裡節點與交接操作的累積失敗風險。此下界需要有效計畫與相容 handoff、各操作符合其合約、預算可行,以及 Host 在預算內選到有效計畫的機率下界。理論考慮規劃和協調成本,並不把它們當成免費。它不表示只要把 specialist 加進 DAG 就一定有收益;選錯專家、分工成本、等待時間或交接錯誤都可能吃掉收益。這是「在明確條件下,組合可能擴大可靠覆蓋」的分析,不是已在所有任務上驗證的多 Agent 定律(Section 2.4–2.6)。
Raven 的完整系統還包含 harness 演化、記憶和技能重用
MAOB 是本文主軸,但 Raven 論文並不是只有一個 DAG planner。更大的設計有三個彼此相關、證據來源卻需要分開看的部分:
- Harness 自我演化:固定 task model,不更新模型權重;Task Agent 的執行紀錄用來診斷失敗,Evolver Agent 提出修改 prompt、knowledge、runtime 或 config 的候選 harness,之後經有效性、啟動與成對增益篩選,再放入依 failure pathology 分格的 gene bank。候選會在 held-out tasks 上比較。這套方法建立在先前 HarnessBank 工作上;論文第 7.2 節明確將跨 benchmark 的數字標作 published HarnessBank experiments 的報告結果,不能寫成 Raven 團隊在本文新獨立重跑。
- EverOS 長期記憶:互動先被切成 episode,再整理出原子 facts、帶有效期間的 foresight 與來源 metadata;user memory 和 agent execution cases 分流。檔案產物完成時即可解除 DAG 依賴,記憶萃取則非同步進行。這讓「當前任務產物」和「未來可能重用的經驗」不是同一份資料,也能保留來源及 session 脈絡。
- Skill Forge:從整理過的 SkillHub catalog、local skills 和 EverOS agent cases 為當前工作找程序,並把執行經驗整理成後續可用或更新的 skills。論文將 catalog/retrieval 部分連回先前 SkillCorpus 工作;結構正確的 skill update 或高 confidence 本身不證明任務效能變好,效果需要另看固定 harness/model 條件下的 skill evaluation。
論文也分別評估 Raven-Research、Raven-Code、Raven-Design、Raven-Oncall 和技能檢索,不把它們併進 MAOB 的規劃分數。工程閱讀時可把整體系統理解成「組合能力、從經驗調整執行政策、跨任務重用資訊」三條路徑;但每條路徑使用的 benchmark、對照、來源版本與成本口徑不同。尤其 group memory 預設關閉且本報告未評估,作者亦指出記憶 verdict 可能錯誤、記錄不會過期、worker 原生寫入不受審查(Sections 3.3–3.4、4–7)。
從規劃指標走到系統評估,還缺哪些量
MAOB 清楚量出一個可重複問的中間問題,卻留下 planner-to-execution gap。若要判斷多 Agent 系統是否真的比單 Agent 更好,至少要把圖評分接到執行後的任務效用,而不是止於圖的相似度。延伸實驗可預先固定任務集與模型,對每張 plan 記錄:
- 任務是否完成、輸出是否通過獨立測試或盲評;
- 哪些 specialist 節點成功、失敗、重試或被取消,以及例外傳播到哪些下游節點;
- agent、工具和 judge 各自消耗的 token、wall-clock、API/GPU 成本與排隊時間;
- 產物間的 provenance、來源依賴、寫入權限、回復狀態及人工批准;
- 同一任務是否有多種有效 DAG,以及評分如何處理等價計畫;
- 單 Agent、固定 workflow 和動態多 Agent 的消融,避免只有更複雜系統彼此比較。
這些是對 MAOB 的下一步評估建議,不是 Raven 論文已完成的測量。要測規劃器本身,仍可保留圖層 metrics;要測系統價值,就必須讓 workers 真正執行、使用與規劃分離的結果評審,並把追加協調成本列入。兩層結果並列,才能知道更像參考圖的計畫是否更常帶來好的結果,或只是更符合 benchmark 作者偏好的分解形式。
Artifacts 與可重現性:有程式庫,仍要核對版本和資料
Raven 有公開的 GitHub repository,採 Apache-2.0 授權;截至本文查核時,repo 將專案標為 pre-alpha。Repository 可供讀者檢查程式、介面與範例,這比只有概念圖的提案多一層可檢視性;但它仍由作者組織維護,不能算獨立驗證。Repo 中的專案展示和後續更新也不能自動視為 arXiv v1 中 MAOB 的完全對應實作。
重跑 MAOB 還需要能取得同一份 140-task 輸入、參考 DAG、模型/harness 版本、system/delegation prompt、推論設定、原生介面、評分程式和執行記錄。即使這些都可公開,參考 DAG 標註方式和對「有效偏序」的判斷也需要可審核。本文查核到公開 repository 與專案文件,但沒有找到可確認為完整凍結版 MAOB 任務、標註審核紀錄、原始 run-level outputs 與成本的明確 release;也沒有找到外部團隊獨立重跑。因此,合理說法是「有 Apache-2.0 程式庫,獨立重現與完整 benchmark artifact 尚未確認」,而非「論文完全不可重現」或「結果已被驗證」。
本文引用的原論文圖取自 arXiv v1,該版本頁面標示 CC BY 4.0;圖表均未修改,並在每張圖下標示來源與授權。這些圖展示系統概念、benchmark 組成和作者結果,引用並不表示本站獨立確認了圖中實驗。
Bloss0m 工程判斷:把「任務圖正確」當成第一個 gate,不是最終驗收
Raven 的實用啟示,是把多 Agent orchestration 分成可獨立觀測的階段。我的工程解讀是,可以先保存 Host 產生的 plan manifest,檢查節點唯一性、依賴完整性、能力可用性與執行權限;然後把 dispatch、node state、artifact provenance、重試/取消和最終 verifier 結果另外記錄。這樣一來,失敗可以回答「規劃漏了哪個依賴」、「選了不支援的 agent」、「worker 沒產出」、「判定器放行錯誤」或「結果驗證失敗」,而不只是留下 agent 說自己完成的敘述。
若系統會寫入外部服務、部署、付款或修改生產設定,圖的正確性仍不足以授權操作。應把工具權限與任務節點綁定,讓高影響動作需要明確 approval;驗證不能只依賴同一個 Host 或 worker 的自評;而且失敗或取消時要保留已完成 artifact、外部副作用和補償/回復方式。這些控制是依論文架構邊界延伸出的工程建議,不是 MAOB 已測出的 Raven 安全保證。
另一方面,不應因為 DAG 看起來漂亮就引入多 Agent。若 specialist 彼此能力重疊、交接資料難以驗證、context 和 API 成本高,或任務本身是單一連續推理,單一 agent 或固定 workflow 可能更穩定。Raven 的論文提供一種可組合設計和 planner benchmark;是否值得部署,仍需用自己的任務、模型、工具、成本預算及失敗代價測試。
七題 teach-back:確認讀懂這篇論文的邊界
- Raven 的 composable unit 是什麼? 不是裸模型,而是模型與可執行 harness 的配對,包含工具、上下文、記憶、技能、政策及復原方式等執行特性。
- Host Agent 在圖裡負責什麼? 它依任務和 specialist 能力提出工作節點、輸入與依賴 DAG,runtime 再做結構和能力檢查;它不是單純讓多個模型自由聊天。
- MAOB 測到什麼? 140 個作者建立、經審閱的職業情境及參考 DAG 上,規劃器選擇哪些 specialist 工作,以及其偏序/圖結構與參考相符的程度。
- +10.4/+10.5 個百分點代表什麼? 兩個 backbone 各自設定中,Raven exact graph match 相對最強基線的差距。它不是任務完成率、答案品質或 worker execution 成功率差距。
- planning admission 能保證什麼? 它可在派工前拒絕格式、節點 ID、循環、依賴引用或 agent capability 等可檢查的結構問題;它不會因此知道語意目標、資料或最終答案正確。
- 最大的有效性限制是什麼? MAOB 在 workers dispatch 前評分,並且 benchmark 與參考圖由作者建立;結果只在兩個 backbone 和指定比較介面下成立,尚無獨立重跑。
- 若要證明 Raven 改善真實工作,下一步要補什麼? 讓 workers 執行,加入獨立任務品質評估、成本/延遲、失敗與重試、有效替代 DAG 和單 Agent/固定 workflow 對照,同時固定資料、版本與 prompts。
三件事帶走
- 架構觀點:agent specialist 是 model 加 harness;Host 以 DAG 組合能力,runtime 再驗證工作圖能否安全進入執行。
- 證據觀點:Raven 在兩個 backbone 的 MAOB exact graph match 高 10.4/10.5 個百分點,衡量的是規劃圖與參考圖的匹配,不是任務完成率。
- 評估觀點:planner-only benchmark 是有用的中間層,但要主張多 Agent 真正更好,還要觀察 worker 執行、外部 verifier、成本、失敗與有效計畫多樣性。
延伸閱讀
- LLM Agents Can Easily Tamper With Their Own Traces:Agent 系統的外部觀察與可稽核性,和 Raven 的 Host/runtime 狀態邊界互補。
- Completed Pairs Hide Capped Failures:評測 runner 如何影響可見結果;可和 MAOB 的計分單位與執行前截點一起思考。
- The RAT:RAG 評估的統一 Bayesian 模型:另一種將系統評估中的不確定性與計分層級明確化的研究。
主要來源
- EverMind AI,Raven: The Harness of Harnesses for Composable Agentic Intelligence(arXiv v1),提交於 2026-09-27。本文主要依 Sections 2–7、Appendices A–C,以及 Figures 2、4、5、12、13 整理;數字均為作者報告。
- Raven GitHub repository,Apache-2.0;截至 2026-10-01,README 標示 pre-alpha。repo 是第一方 artifact,不是獨立重現。