論文精讀
EfficientAgent 精讀:並行 Agent 的 KV Cache Offloading
原文:EfficientAgent: What Makes KV Cache Offloading Work for Concurrent Agents?
90 秒掌握論文
- 問題:Agent 一輪工具操作結束後,下一輪常把先前處理過的對話再次送進模型。GPU KV cache 放不下所有並行工作時,host memory offloading 看似能救回狀態;但 agent 等工具期間,伺服器還處理其他 Agent 的上下文,剛寫出的 cache 可能在回來前就被擠掉。
- 核心洞見:快取是否有用,取決於兩次重用之間有多少「其他 KV 區塊」經過,而不是單一請求有多長。論文稱這個容量需求為 reuse working set,並用 stack distance 預測;執行時只在估計 working set 超過 host tier、且 tier 正滿載驅逐時,拒絕大幅 refill。
- 最強證據:在 OpenHands/Qwen3-Coder 的 SWE-bench Verified 工作負載上,以固定的 4,427 次模型呼叫與輸出 replay,H20 host capacity 從 5 到 20 GiB/rank,computed prefill 從 76.7M 降至 5.3M tokens(93.1%),makespan 從 209 降至 128 分鐘(38.7%)。Figure 2、Table 3 與 Sections 5.2–5.7 顯示容量、並行度、寫入策略與 GPU 類型會改變結果。
- 主要邊界:這衡量固定工作軌跡下的 serving 行為,不衡量即時 Agent 是否更會解題。5 GiB 小容量時,減少寫入能避免反覆填入很快被驅逐的資料;40 GiB 足以容納 working set 時,同樣的固定拒寫反而把 computed prefill 拉高 4.3 倍。它不是「offloading 一定更快」的論文。
這篇論文的故事從一個直覺陷阱開始:若從 CPU 記憶體載回一段 KV 比重新 prefill 便宜,為什麼 offloading 有時讓 Agent 更慢?作者把答案拆成兩個必要條件。第一,硬體成本比要讓載回比重算划算;第二,狀態必須在 Agent 回來時仍留在 host tier。後者在多 Agent 伺服器上不能用單次請求推測:某個 Agent 等工具時,其他請求持續消耗容量,令它的舊 prefix 面臨一整個 active pool 的競爭。EfficientAgent 因而先估計並行工作造成的 reuse working set,再以容量估算和 eviction telemetry 共同決定寫入 admission。它在一組固定重播軌跡上改變 serving policy,呈現容量轉折與硬體敏感性;沒有證明更高 task success,也沒有聲稱所有工作負載都能套用。本文依據 2026-09-27 提交的 arXiv v1,該版本是預印本,來源未建立同儕審查狀態。
為什麼「載回比重算便宜」還不夠
Decoder-only LLM 在推論時會為每個已處理 token 保留 key/value(KV)狀態。下一次請求若以前綴完全一致的 token 序列開頭,服務端可沿用相符的 KV,而不是重新執行整段 prefill。這種 prefix reuse 有個嚴格條件:快取 key 依賴前面的完整上下文;若早期歷史被改寫,即使後面的句子一字未變,後綴也未必能沿用同一狀態。論文 Section 2.2 把能保持一致的前綴稱為 cache-stable prompt length,並在 Appendix G 說明 context folding/摘要可能減少送出的 token,卻同時破壞 prefix hit。
GPU HBM 快,但容量有限。KV offloading 把部分狀態保存在 CPU host memory,之後再經 CPU–GPU link 載回。只看每 token 的成本,若載回時間低於重算時間,似乎應該盡量保存。然而一次 host write 不等於未來會有 host hit:如果狀態先被其他 Agent 的工作逐出,伺服器最後仍重算,還額外付過寫入成本。對 coding agent 特別常見,因為同一任務每次模型呼叫都帶回長對話;論文在所分析的 SWE-bench traces 中指出,98.1% prompt tokens 已在同一任務之前的呼叫處理過,下一次呼叫也會重現多數新 KV。但「曾經重複」不能直接推出「host tier 留得住」。
論文先指出同一 agent workload 在 RTX 3090、H20、H800 上可呈現加速、無差別或變慢。Figure 1 對照兩件事:左邊是一個 agent 的工具等待被其他 agent 工作填滿,右邊是 GPU HBM 與 CPU host tier 的搬移成本。GPU 決定 host hit 值多少;競爭者決定 hit 會不會出現。這個區分是全文最重要的建模選擇:有利的傳輸比只是必要條件,不是成功保證。
核心直覺:每個 Agent 等待時,全池都在用快取
把 16 個 agent tasks 想成輪流前進的工單。Agent A 送出模型請求、拿到回覆後啟動測試;測試期間它不會向模型送新呼叫。其他 15 個 task 繼續產生請求,伺服器要處理它們的 prompt、可能驅逐較舊的 host KV。當 A 的工具回傳,A 再次提交長上下文時,先前保存的 prefix 是否還在,取決於中間其他工作觸碰多少不同 KV chunks。
作者稱這段中間競爭形成的資料需求為 reuse working set。在簡化的 backlogged pool 情況下,若 active pool 大小為 ,平均 prompt 長度為 ,每 token 每 GPU rank 的 KV footprint 為 ,則估計容量尺度為:
此式是容量尺度估算,不是每個部署都精確相等的定律:它假設每個 Agent 都有待處理請求、上下文長度相近;論文的 trace-based stack-distance model 會保留實際參照順序、長度與共享情況。直覺上,A 增加或 context 變長,A 的狀態就得跨過更多其他人的工作,host tier 所需容量也跟著上升。論文的 H20 設定以 16 個 active tasks 預估 11.4 GiB/rank;active pool 減為 8 時,尺度降至 5.3 GiB/rank,觀測到的容量轉折亦往下移(Section 5.3、Table 3)。
另一個比率是 ,其中 是 host tier 容量。 表示工作集大於 host tier,cache thrashing 的風險上升; 代表預估容量能容納工作集,但不保證任何 workload 都必然命中。GPU 端是否形成 offloading 機會,則由 active pool 的 KV 需求相對 GPU KV 容量 決定,論文用 表示。要有 host recovery 的空間,GPU 容量通常得不足以涵蓋整個 active pool;接著 host tier 是否能覆蓋 reuse working set,決定這種機會能否變成實際 hit(Section 3.2,Equations 4–5)。
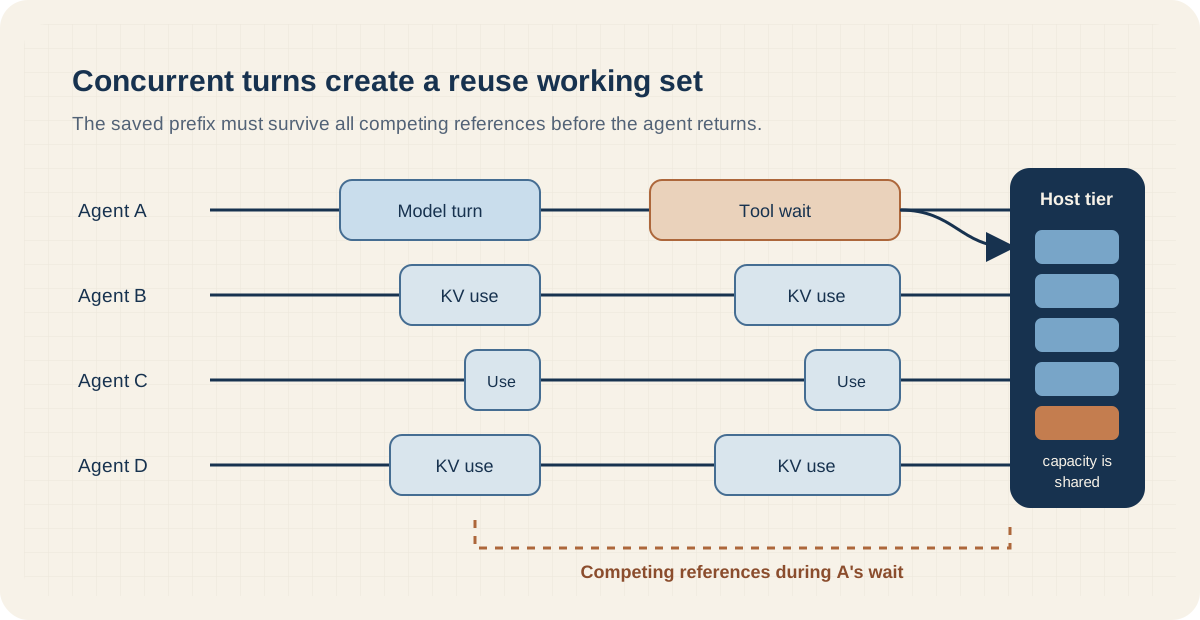
Bloss0m 原創圖解(無論文測量值)。它解釋 原論文 Figure 1 與 Sections 2–3:一個 Agent 等待工具時,其他 Agent 的請求會增加其 prefix 再使用前的參照距離。授權/重用狀態:原創說明圖,未重製論文圖。
用一個例子走完整個方法:從重複 prefix 到 admission 決策
以下是依論文機制整理的教學 trace,容量與 token 數為示意,不是作者報告的一筆新實驗。假設 Agent A 第一次提交 20,000-token prompt。GPU cache 保留最近使用的 KV;GPU 空間不足時,服務端把 A 的部分 KV chunks 寫進 CPU host tier。A 的模型回覆後呼叫測試工具。此時 B、C、D 等其他 Agent 接續送入不同的長 prompt,造成 host tier LRU 次序變化。等測試結束、A 再提交長上下文時,最前方仍相同的 chunks 才能從任何 cache tier 重用。
- 輸入與狀態:server 讀取 request 的 prefix match 長度、active pool 近期大小與 prompt 長度,以及 host tier 是否已滿並正在 eviction。KV 以固定 chunk 為單位處理;論文主要 replay 使用 1,024-token chunks。
- 離線容量定位:對每個 chunk,stack distance 計算兩次參照之間出現多少不同 chunks。在 fully associative LRU 模型中,容量可容納的 chunks 約為 ;若 ,該 chunk 在模型中可以存活。根據 trace 統計預測容量曲線在哪裡轉折,再安排實際容量實驗(Section 3.2、Equation 4;Section 5.4、Tables 4–5)。
- 當前 request 的新資料量:設 prompt 有 tokens、host 已命中前 tokens、chunk size 為 ,需新寫入的完整 chunks 為 。若前綴多半已在 host,u 小,這次通常只是延長可留存的 prefix;若大量前段已被逐出,u 大,寫入便像一次大規模 refill。
- 壓力條件:以 表示壓力。若有新鮮 telemetry,只有 working-set estimate 大於 host capacity、且 host tier 回報「滿且正在逐出」時, 才成立。若 telemetry 缺失或已過期,runtime 退回只依估計 working set 是否超過容量判斷;這能讓決策不中斷,但少了即時 eviction 狀態這道確認。repo 將 fresh report 的最大年齡設為 5 秒(Appendix D;repository runtime parameters)。
- Admission:若 成立且 ,這一整個 request 的新 KV 不寫入 host;已命中的 host prefix仍保留,request 後續不再重新考慮寫入。反之照常寫。論文以 的 chunk threshold 作主要設定,並在 Appendix D 分析參數敏感度。
- 下一次回來:若拒寫的 refill 本來就會在重用前被 LRU 驅逐,拒絕它便把有限空間留給會再被讀取的前綴。若 host tier 容量本來已超過 working set,拒寫可能排除一段本來可以存活的 cache,造成更多重算。這就是政策必須同時看容量估算與壓力 telemetry 的原因。
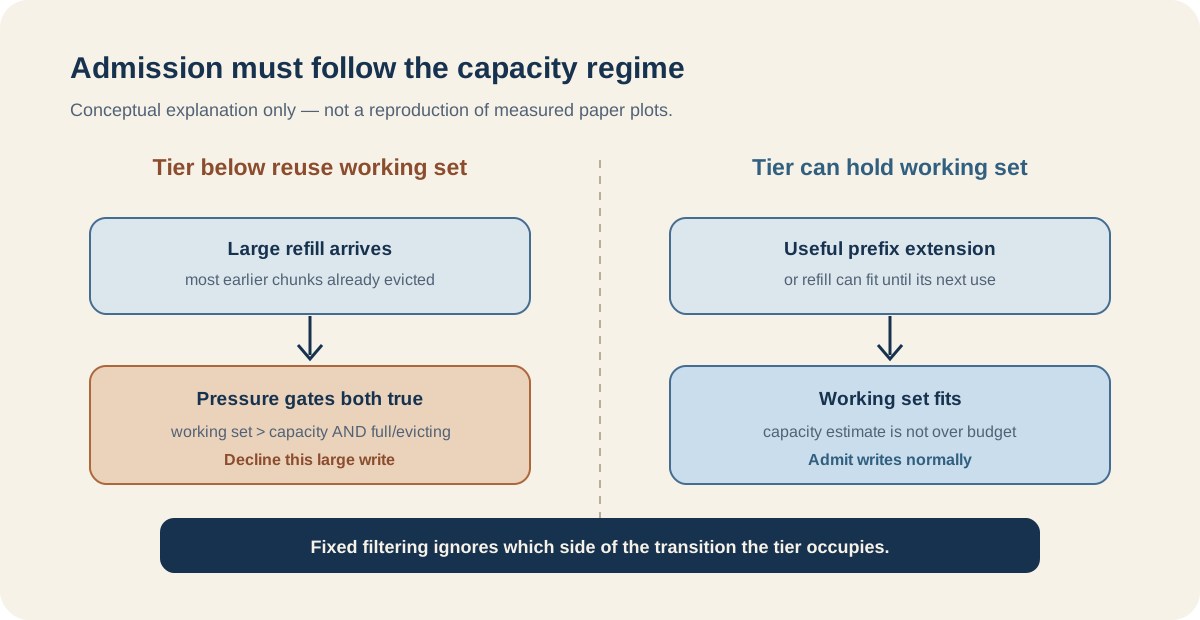
Bloss0m 原創圖解。它概括 原論文 Figures 2–4、Sections 5.2–5.5:working set 以下固定拒寫可有幫助,但容量足以保留 working set 時,一律拒寫可能適得其反。授權/重用狀態:原創說明圖,未重製論文圖。
技術機制:價值、存活機率與寫入控制不是同一件事
先算 host hit 值多少
論文定義 Offload Benefit Ratio(OBR),估計還原長度 的 prefix 相對重算節省多少時間。若重新 prefill 的有效時間為 ,host restore 需 ,則:
會隨模型、上下文長度、batching 與實際運作點改變; 是 host-to-GPU restore 的有效頻寬; 是固定載入成本; 是每 token、每 rank 儲存的 KV bytes。長 prefix 可攤薄固定成本,但 OBR 只回答「一個可用 host hit 值不值得」,不回答「host 裡有沒有保留住它」。若 OBR 大於零,卻每次都在 reuse 前被 eviction,紙面傳輸優勢仍無法兌現(Section 3.1、Equation 2;Appendix C)。
更完整的 serving time 近似式把 saved prefill、restore traffic 與排程等其他成本放在一起:
這裡 與 是 host tier 關閉/開啟時需重新 prefill 的 token 數, 是真正從 host restore 的 tokens;負的第一項表示少算的時間,正的 transfer 項表示搬回成本。 包含寫入、restore setup、排程暴露與無法重疊的等待。這個分解解釋為何「每 token restore 比 prefill 快」仍不是充分條件:如果成功 restore 數很少,或 host writes、eviction、queue delay 很高,總 makespan 仍可能不降(Section 3.1、Equation 3)。
再算容量能否讓 hit 存活
Stack distance 是完全相聯 LRU reference model 中一種離線分析量:對某 KV chunk ,看它上次與下次被引用之間,有多少個不同 chunks 被使用。若 host 有 個 chunk slots,reuse distance 小於 時,在該模型中 chunk 可存活;若達到或超過容量,則被更新的不同 chunks 擠出。這不是 GPU runtime 對未來的完美預言,而是根據 trace 估計 capacity transition 的方法。論文用它在實驗前定位容量邊界,並報告 20 與 80 GiB 上預測與實際 computed prefill 接近(Section 5.4、Tables 4–5)。
Prefix cache 還有「連續覆蓋」限制:即使較後方某個 chunk 仍在 host,若它前面的 chunk 不在,整段 prefix 不一定可直接從該點開始恢復。論文因而先由 chunk survival 推導 host prefix coverage,再扣掉仍留在 GPU 的部分估算可還原長度。這點防止把「cache 中的 chunk 命中率」直接等同「整個 prompt 能重用多少 token」(Section 3.2、Appendix C)。
最後決定該不該寫
作者稱這個策略為 capacity-conditioned write admission。它結合 feedforward 和 feedback:active pool/近期 prompt 長度估計 working set;若 telemetry 新鮮,host tier 再回報是否 full and evicting。新鮮狀態下,working set 超出 host budget 且 tier 滿載驅逐,才進入 pressure;telemetry 缺失或過期時,估計超出容量本身便作為 fallback pressure。最後還須當前 request 的新 chunk 數超過 ,才拒絕這一個 request 的 host writes。若只固定少寫,不論快取容量如何;容量不足時可能減少廢寫,容量夠時卻可能錯失可存活的 refills(Section 4、Appendix D;repository admission description)。
Proposition 1 提供一個條件化的 LRU 性質:在固定 reference stream 與 LRU tier 下,只拒絕下次使用距離已超過 tier 容量(或不會再使用)的 miss insertion,既有 full-admission 的 hits 不會因此失去。這不是證明實際估計器永遠能準確找出這些 chunks;論文 runtime rule 是以估計與 telemetry 近似選擇拒寫範圍。政策每 request 做常數時間檢查,而不是對每 token 計算複雜模型;不過其實際收益仍依賴估計品質、chunking、runtime telemetry 與 LRU 行為是否符合假設(Section 4、Proposition 1;Appendix D)。
實驗如何讀:固定工作相同,服務端策略不同
主要 live workload 在 OpenHands CodeActAgent 搭配 Qwen3-Coder-30B-A3B-Instruct BF16,vLLM 0.13.0 與 LMCache 0.3.12 上執行。核心 H20 設定是 8 張 H20、tensor parallel 8、最多 16 個同時處理 request、每 rank 的 GPU KV 容量固定、host tier 以 1,024-token chunks 儲存。活躍池與 host capacity 另外在 8–16 個 tasks、每 rank 3–80 GiB 間變化。跨硬體實驗使用 8×RTX 3090、2×H800、8×H800,並在部分設定測試 dense Qwen2.5-Coder-32B-Instruct(Sections 5.1、Appendix A)。
核心 replay 取自 host tier 關閉的一次 SWE-bench Verified live run,共 4,427 model calls、147.1M prompt tokens;每個 call 重送當時記錄的 prompt,也精確重現其輸出 token。每項 serving policy 重新跑同一份呼叫,agent/tool elapsed time 與 task dependency 保留,但模型輸出固定。這讓 cache policy 可以改變 queueing、task interleaving 和 makespan,同時避免模型生成分岔造成 token work 不同。代價是 replay 不會讓 Agent 因不同延遲或狀態作出新決策;它回答的是固定工作量怎麼被服務,不是 live agent 能否更快找到正確修復(Section 5.1、Appendix B)。
作者比較 no-host recomputation、沒有 admission 的 offload、固定拒寫與 capacity-conditioned admission;量測 computed prefill、host writes/restores、preemptions、prefix reuse 與 makespan。H20 上 16 個 active tasks,從 5 GiB 到 20 GiB/rank,prefill 由 76.74M 降至 5.28M tokens,makespan 由 208.91 降至 128.05 分鐘。20 增至 40/80 GiB 後,prefill 約 5.27–5.29M,表示在此 workload 下容量收益已趨於平緩。5 GiB tier 的 81.69M tokens 寫入只換回 12.57M restore tokens,且 makespan 仍約 209 分鐘;這是有 host cache 卻沒有有效 recovery 的負面例子(Figure 2、Table 3、Section 5.2)。
Figure 2 與 Table 3 支持容量與時間結果;Section 5.3 的 active-pool 比較顯示 16 降至 8 時,預估 working-set 尺度由 11.4 降為 5.3 GiB/rank,no-offload makespan 由約 212 降至 159 分鐘,容量轉折也隨之下降。Section 5.4 / Tables 4–5 檢查 stack-distance 預測,而 Section 5.7 / Table 1 對照 GPU ratio。這些是同一項系統研究的多個視角,不是互相獨立的外部重現。
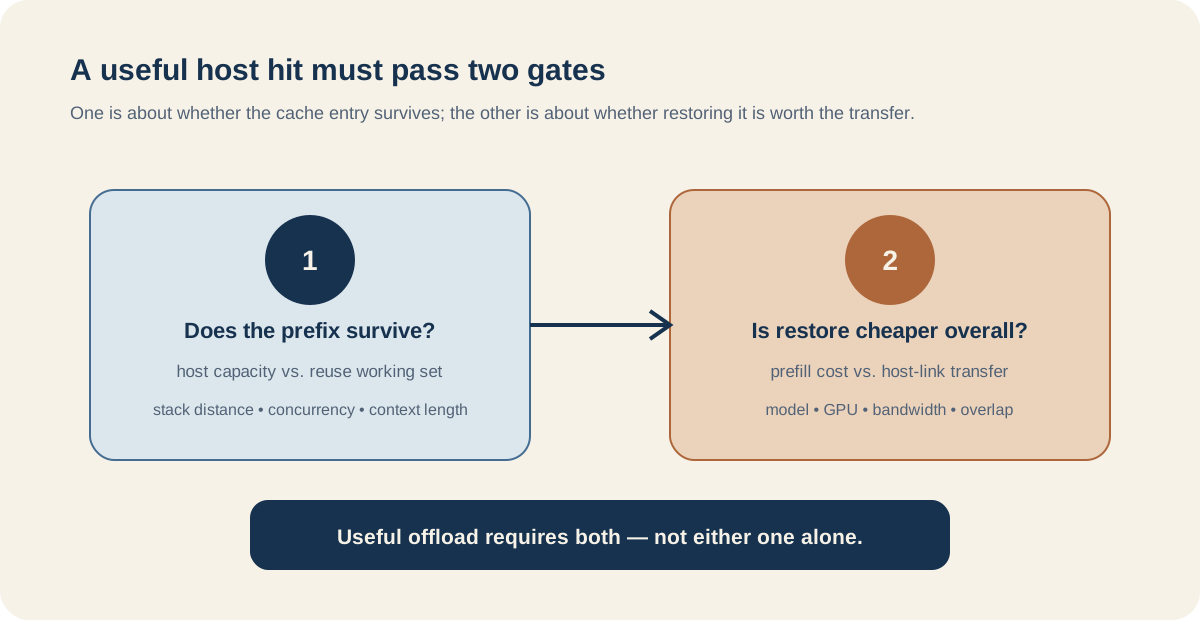
Bloss0m 原創圖解。硬體結果請以 原論文 Section 5.7/Table 1 為準:低 compute-per-link-byte 的 RTX 3090/H20 與較高比值的 H800 呈現不同 offload 結果。授權/重用狀態:原創說明圖,未重製論文圖。
關鍵負例:固定拒寫會在容量夠時反轉效果
這篇最值得記住的結果,不只 headline 的 93.1%/38.7%,而是同一種 admission 在不同容量下方向反轉。5 GiB/rank 時 working set 約 11.4 GiB,,固定寫入 admission 把 H20 的 computed prefill 從 76.7M 降到 48.9M,makespan 由 209 降至 186 分鐘;capacity-conditioned policy 對應到 49.7M 與 187 分鐘。它大幅降低 host writes,並讓可存活 prefix 得到更多 restore。
然而 40 GiB 已大於該設定的 working set。此時若仍固定拒寫,computed prefill 從 5.3M 增到 22.8M,約為 4.3 倍;makespan 從 124 增至 162 分鐘。容量-conditioned policy 觀察到估計 working set 沒超過 tier,沒有拒絕寫入,因此約維持一般 offload 結果。Section 5.5、Figure 3–4 與 Appendix D 的 trace 解釋了轉折:在 5 GiB 時,多數被拒 chunks 的下次重用距離確實超出容量或不再使用;40 GiB 時,固定拒寫錯過大量能留存的 chunk。
硬體還會再加一層限制。Table 1 / Section 5.7 報告 RTX 3090 和 H20 的 peak FLOP per host-link byte 約為 2.2K 與 2.3K,offload 在 tier 足夠時 makespan 比值約 0.91 與 0.60(比值低於 1 表示更快);H800 約 15.5K,實測各組 makespan 比值 1.08–1.87,也就是變慢。意義不是「H800 不適合 KV cache」,而是該 restore path 的 host link 相對 GPU compute 不夠划算。實際有效 prefill 速度、GPU memory pressure、PCIe/NVLink 路徑、batching 和重疊能力都會改變這個判斷。不能以 peak specs 單獨預測部署結果。
論文還報告 RTX 3090 在更高 GPU memory share 時,GPU-side prefix hit rate 從 44.6% 升至 98.1%、wall clock 從 407 分鐘降到 73 分鐘(Section 5.2)。這再次提醒:提升 GPU cache residency 也能影響結果;host tier 並非唯一因素。外部效度受單一主要 coding-agent trace、模型/runtime 版本、硬體與 replay control 限制;報告的重跑是論文實驗內的 independent repeats,不能稱為獨立團隊 replication。
證據地圖:作者證明了容量條件,不是 Agent 品質
| 層次 | 可以怎麼說 | 不應推成 |
|---|---|---|
| 論文直接量到 | 在指定 OpenHands/SWE-bench Verified trace、模型、serving stack 和硬體下,cache policy 改變 computed prefill、traffic、preemption 與 replay makespan;working-set 預測定位部分容量轉折。 | 任意 Agent、prompt、模型或雲端部署都會得到同一加速幅度。 |
| 作者的系統主張 | Concurrent agent interleavings 會擴大 reuse working set;容量估算加上 pressure-conditioned admission 能避免小 tier 的 thrashing,同時不在足夠容量時固定丟棄可重用狀態。 | admission 對所有 cache backend 或非 LRU 結構都具同一保證。 |
| 證據暗示 | concurrency、prefix 重寫、GPU/host-link 比與 tier capacity 應一起納入部署前 sizing;單 request KV size 不足以預測收益。 | stack-distance estimate 已解決所有動態 workload 或不需線上驗證。 |
| 本文的工程解讀 | 以容量掃描先找 transition,再比對實際 traffic/hit 與 latency,可能比直接購買更多 RAM 更能辨識瓶頸。 | 這是論文正式提出的普遍部署標準,或已有跨平台驗證。 |
fixed-token replay 是優點也是邊界。優點是所有政策面對相同的 4,427 個 prompts 與記錄輸出,較能隔離 serving runtime 變化。工作相依仍保留:某任務下一個呼叫要等前一個回覆與工具時間,策略造成的延遲會改變其他任務 interleaving。因此 measured makespan 不只是將離線 token 數乘上平均 throughput。但輸出固定也切斷「服務速度改變 → Agent 行為改變 → prompt/工具軌跡改變」的閉環;沒有測出 completion rate、解題品質、工具錯誤或策略對 live task outcome 的影響。
還需注意 outcome denominator。93.1% 是 H20 16-task replay 在特定 host capacity 介入下 computed prefill 從 76.74M 降到 5.28M 的相對變化;38.7% 是同一比較中 makespan 由 208.91 降到 128.05 分鐘。它不是 93.1% latency savings,也不是 38.7% token reduction。論文 live agent run用於生成 trace;headline serving comparison是在這些 trace 上 replay,不可將兩種評估混為一談。
Artifact 與可重現性:有工具程式,不代表完整原始 trace 已公開
截至 2026-09-30,作者的 efficientagent_release repository 可公開瀏覽,標示 Apache-2.0,包含 vLLM/LMCache admission connector、dependency-preserving replay framework、stack-distance/capacity analyses、examples 與 tests。README 描述如何輸入 agent traces,也有 synthetic trace 路徑;但目前不能確認論文原始 SWE-bench trajectories 已隨 repo 提供。因此讀者可檢視實作、跑 CPU-only tests 或在合成/自行收集 traces 上分析;這不等於可原樣重算論文數字。README 另外說明:telemetry report 新鮮時會把「估計超容量」與「tier 滿載且驅逐」合併;未設定 telemetry file 或無 fresh report 時則採 estimate-only fallback,預設最大報告年齡為 5 秒。
論文 full serving 設定要求 Linux NVIDIA GPU,文中環境使用 vLLM 0.13.0、LMCache 0.3.12,主要 H20 配置為 8 GPUs/TP8 與 Qwen3-Coder-30B-A3B-Instruct;模型權重、GPU 配額、OpenHands/SWE-bench 資料與長軌跡會影響重現成本。repo 指出 Python 3.10+ 與依賴環境。CPU 分析與合成 trace 能驗證容量模型的程式路徑,不能替代 GPU 執行/端到端 replay。本文沒有獨立重跑作者的 headline experiment;結果均為作者報告,並以論文與 repo 可見資訊限定 reproduction scope。arXiv v1 頁面列的是 non-exclusive distribution license,沒有明確的原論文圖再利用許可;正文因此不重製原論文圖,而使用三張有來源連結、清楚標示為 Bloss0m 原創的說明圖,不能將它們當成論文圖或結果圖。
Bloss0m 工程判斷:先量 reuse boundary,再決定買容量或改 admission
以下是 Bloss0m 工程判斷,不是作者經跨部署驗證的採購規則。若你的 Agent serving 有長上下文、多輪工具等待、並行 pool 與 GPU KV 壓力,先從一段可觀測 trace 做容量掃描:記錄每個 task 的 prompt、prefix match、GPU/host hit、eviction、restore/write bytes、queueing、preemption、active pool 與 wall-clock;然後比較 no-offload、一般 offload、capacity-aware admission。容量從低到高掃描,確認 prefill 與 makespan 是否在估算 working set 附近出現轉折,再檢查被拒絕的 writes 後續是否真的不會在 tier reach 內重用。
不應直接套用的情況包括:工作負載幾乎沒有穩定 prefix;早期對話常被摘要或改寫,導致 exact-prefix reuse 很低;Agent 次數/prompt 長度變化速度快到近期窗口失真;host access 是遠端網路儲存而非論文測試的 CPU tier;runtime cache eviction 並非 LRU;或 GPU prefill 非常快、host link 很慢,讓 OBR 接近或低於零。這些情況下,先優化 context identity、GPU residency 或 serving schedule,可能比擴充 CPU RAM 更合理。需要以自己的 trace 與硬體量測,不能從 H20 的 39% 直接推估成本回收。
部署試驗也應保留安全閥:以 shadow/replay 模式估計 admission decisions;記錄策略造成的拒寫比例、後續 miss 與延遲;在 active pool、context length、模型及 GPU SKU 改變時重新估算;若工作集快速漂移或讀寫比例惡化,回退到普通 admission。論文在單一工作負載上展示的 parameter sensitivity 並未等於生產環境的穩定性保證。工作集預測是容量規劃與 policy input,不是對未來 hit 的逐 chunk 承諾。
讀完後的三個記憶點
- 技術想法:Agent KV offloading 的核心不是「存不存得下單個請求」,而是共享伺服器中並行 Agent 的 reuse working set 能不能跨過兩輪之間的其他工作。
- 證據:SWE-bench Verified 固定輸出 replay 顯示容量與 admission 有明確轉折:小 tier 拒絕大 refill 有用,足夠大的 tier 固定拒寫則可能讓 prefill 多 4.3 倍。
- 邊界:93.1% prefill 與 38.7% makespan 是指定 H20 serving replay 數字;它不代表 Agent 成功率提高,也不保證其他硬體、runtime 或任務重現。
延伸閱讀
- Trajectory-Aware Benchmark Subset Selection for Cost-Efficient Software Engineering Agent Regression Testing:如何讓 agent regression evaluation 更省成本;和本文的 inference serving 成本是不同層次。
- Completed Pairs Hide Capped Failures:評估 runner 的停止規則如何影響可觀察結果,補充閱讀本文 fixed replay 的證據邊界。
Primary sources
- Shao et al., EfficientAgent: What Makes KV Cache Offloading Work for Concurrent Agents? (arXiv v1), submitted 2026-09-27. 文中以可定位的圖、表、章節與附錄標註證據;正文未重製原論文圖。
- EfficientAgent release repository(Apache-2.0; code and selected analysis tools, original paper traces not confirmed bundled)。