本篇讀的是 ACE: A Self-Correcting Agentic Canvas Editor for Multi-Slide Presentation Automation 的 arXiv v1。論文於 2026-08-25 提交;arXiv record 與作者的 GitHub repository 都標示 EMNLP 2026 Industry Track (Main) 的 acceptance,本文仍把所有數字固定在 v1 preprint、公開 repository 與 benchmark card 的可核對內容,不把這個 status 擴寫成已在所有部署環境驗證。
我讀過完整 paper HTML/PDF 與 source,包含 Sections 1–6、全部 tables、Figures 1–7、Appendix A–Q、limitations 與 ethics;也交叉讀了 repository 的 orchestrator、CARE router、self-correction runner、evaluator、公開 execution logs,以及 Hugging Face Figma Slide Editing Benchmark card。我特別跑過 repository 的 mock path,所以下文會把「論文與 artifact 直接支持的 evidence」、「作者的解讀」和「Bloss0m 的工程化整理」分開。
這篇 paper 真正值得問的不是「LLM 會不會畫投影片」,而是:當編輯結果沒有唯一的 ground truth 時,Agent 要如何在不重算整份畫布的前提下,讀懂結構、選對 context、知道哪個 edit 真的完成,並在變差時回到較好的版本?
90 秒掌握論文
- 問題:PowerPoint/HTML 一類 flat absolute-positioned 文件把物件位置寫成大量座標。Agent 若要在一個 element 新增內容或改 layout,常得重新計算其他物件;而不同但合理的設計可能被 reference-diff 指標誤判為錯。
- 核心洞見:ACE 以 hierarchical scene graph 保存 parent–child 關係、相對變換與 auto-layout,再用 98 個專用工具把意圖映射到結構化操作;CARE 只取與任務相關的 slide、節點或 design token。完成 edit 後,JsonDiff 對比原始與目前狀態,由不看 ground truth 的 instruction-following judge 提供下一輪 critique。
- 最強證據:完整 94-task benchmark 的 GPT IF 是 ACE 4.23、HTML baseline 3.81,paired p=.010;速度約 1.75 倍、成本約低 44%。但同一組的 VQ 是 3.66 對 3.57(p=.56),所以 headline 不是「所有視覺品質都提升」。
- 主要邊界:26 位 blind raters 在 ACE 對 HTML 的 overall decisive win rate 是 58.7%,self-corrected output 對 single-pass 是 81.5%;這些結果有小樣本、tie、低至中度一致性與 judge circularity 限制。它沒有證明 ACE 能改善所有 creative editing,也沒有證明 judge 能取代設計師。
我的 bounded verdict 是:ACE 最可信的貢獻,是把 canvas Agent 的控制單位從「輸出一份 flat 文件」改成「在有結構的 scene graph 上做局部、可差分、可回退的操作」。在任務偏向結構化、多頁、可觀測的 Figma canvas 時,這個 workflow 值得借鑑;在品牌美術、開放式構圖或跨平台轉移上,它仍是一個需要 human review 與重新校準的研究型系統。
論文身分、讀者問題與證據地圖
論文作者是 JooYoung Jang、Taegyeong Lee、Jihyeon Park、Nojun Kwak。本文使用的 source version 是 arXiv 2608.24103 v1(2026-08-25);repository 在 2026-09-04 的公開 commit 更新 citation 並標示 EMNLP 2026 Industry Track (Main) accepted。這裡的 acceptance 是 paper/repository metadata;可重現性判斷仍依公開程式、資料端點、logs 與實際執行結果,不把 venue label 當成部署保證。
讀者可以先把它放在幾條已存在的路徑之間:Parsing the Stream 的 live trace 關心怎麼留下可回放的執行事件,DRACO 的 dynamic rubric 關心怎麼讓評測依任務調整,A²E 的 auditing engine 關心 Agent 行為的證據鏈,而 CONTINUITY Security 的 context contract 關心跨回合狀態邊界。ACE 把相似問題搬到可編輯的多頁 canvas:representation、context routing、judge、rollback 必須在同一條 trace 裡互相對得上。
先把三種聲音分開:
| 層次 | 本文採用的說法 |
|---|---|
| Paper 直接支持 | hierarchical scene graph、98 個工具、CARE 三種模式、reference-free IF evaluator、最多三輪 self-correction、94-task 結果、53-task head-to-head、26 位盲評者、out-of-loop judge、strict-peak rollback 與 component ablation。 |
| 作者解讀 | 結構化 representation、相關 context、專用工具與 judge-guided correction 共同讓 ACE 在這份 benchmark 上領先 HTML/OpenXML;self-correction 可在不需要 ground-truth deck 的條件下修正部分 failure。 |
| Evidence 尚未建立 | universal creative-editing improvement、所有風格與平台的 transfer、judge 取代 human designer、公開 logs 足以完整重跑 paper metrics,或任何 production cost/quality guarantee。 |
| Bloss0m 工程化整理 | 若要借用 ACE,應把 scene graph、context scope、origin→current diff、IF/VQ/human review、rollback policy 與 artifact version 寫成一份可回放的 workflow contract。 |
Paper Essence Contract:六個問題的短答案
- 它解決什麼問題? Flat canvas representation 讓局部 edit 牽動大量座標,且 reference-free 任務沒有唯一正解;ACE 要建立一條結構化、可 self-correct 的多頁編輯路徑。
- 為什麼既有方法不夠? HTML/OpenXML agent 能產生頁面,但缺少 scene-level semantics、局部 context routing 與由 edit diff 驅動的回饋;單看 screenshot 也無法區分「內容沒有改」與「結構性改動合理但像素不同」。
- 核心技術想法是什麼? 用 scene graph 表示關係,用 CARE 選 context,用專用 tool 執行語意操作,再用 JsonDiff + instruction-following judge 產生 critique;strict-peak 只保留已觀測到的最佳迭代。
- 一個 input 怎麼走? 使用者 task → router 判斷 Micro/Macro/Systemic → 取得指定 slide、cross-slide skeleton 或 tokens → Agent 呼叫 scene-graph tools → Figma render/state → diff evaluator 與 judge → 需要時將 critique 帶回下一輪 → 輸出最佳 state。
- 什麼 evidence 支持 headline? 完整 94-task 的 paired IF 統計、53-task 的基線比較、human blind study、兩種 out-of-loop judge family、self-correction ablation 與 rollback sensitivity 共同支撐;沒有任何單一分數能獨自支撐所有 claim。
- claim 在哪裡停止? 停在這份以 Figma 為中心、任務偏結構化、包含 85 個 PPTArena 改編任務與 12 個新增任務、固定 judge/model/工具版本的 benchmark;它不會自動外推到所有 creative work、所有 canvas、所有 provider 或 production designer workflow。
前置差異:平面文件、結構化畫布與「沒有唯一答案」
平面座標為什麼會放大局部變更
在傳統簡報檔中,一個物件通常以 page、x、y、width、height 和 style properties 表示。把第五張 card 加進已經排好的 panel,Agent 不只要建立新 card,還可能要重排既有 card 的位置、尺寸與連線;若它只生成一個新的 HTML 或 OOXML 樹,原有語意關係很容易被座標字串淹沒。ACE 的 scene graph 讓 node 有 parent、children、relative transform 與 auto-layout 的 fill/hug/fixed 行為。這不是保證每次 layout 都漂亮,而是把「哪個 node 受誰影響」放到可操作的資料模型裡。
IF 與 VQ 不是同一個分數
ACE 主要使用兩個互補訊號:
- Instruction Following(IF) 看 original state 到 prediction state 的 focused diff,檢查任務要求的元素、文字、位置或結構是否完成;它不需要 ground-truth deck。
- Visual Quality(VQ) 看 reference 與 prediction 的 rendered screenshot,評估可見品質;它也只聚焦 salient changes,且論文指出 VQ 的均值和 HTML baseline 沒有顯著差異。
因此「IF 變高」只能說 edit contract 更常被滿足,不等於所有 layout、style、品牌語氣或視覺偏好都變好。這個 distinction 是讀後面 result 的前提。
核心直覺:讓 Agent 只看到需要的結構,再讓它接受可回溯的批評
把 ACE 想成一個五段式 controller:
task intent
   ↓
CARE scope → scene-graph state → semantic tool calls → render + JsonDiff
                                                        ↓
                                  IF judge critique ← current/origin state
                                                        ↓
                                  next turn or strict-peak rollback
舊的 flat workflow 往往把整份文件序列化給 Agent,讓 Agent 自己從座標和 style property 猜關係;ACE 先把關係放進 representation,再限制 prompt 的 scope,最後把評測訊號接回同一份 state。這個控制點移動有兩個實際效果:一是減少 irrelevant context,二是讓 correction 有一個能被 diff、log 與 rollback 指向的對象。
但它也引進新的依賴:scene graph schema 必須穩定、router 不能漏掉必要節點、tool execution 必須真的反映 state,而 judge 對 diff 的理解不能被 prompt 或 family bias 主導。ACE 的 evidence 主要說明這些元件在其 benchmark 內協同有效,不代表任何一個元件單獨造成全部增益。
用兩個例子走完整個方法
Example A:Case 112 的 auto-layout 變更
論文用 Case 112 說明 scene graph 與 flat OOXML 的差別:
- Input:任務要求在一個已有五個 child 的 auto-layout parent 中新增兩個 children。
- Intermediate representation:scene graph 保存 parent、child、相對關係與 layout mode;平面 OOXML 則以每個 shape 的絕對 EMU 座標保存結果。
- Decision:Agent 可以呼叫語意化的新增/layout tool,讓 parent 根據 fill/hug/fixed 規則重新流動,而不是手算所有 card 的座標。
- Output:新的 children 出現,既有 children 由 parent layout 重新排列;這個例子展示的是 representation 的可操作性,不是所有設計都會得到最佳視覺結果。
- Likely failure point:若 router 只給 target node 卻漏掉必要的 parent constraint,或 tool 沒有把 layout state 正確寫回,局部 edit 仍會造成錯位。
這個案例也解釋為什麼 Figure 3(c) 很重要:ACE 的 claim 不是「JSON 比 XML 短」,而是 hierarchical relation 改變了 Agent 能採取的 action。
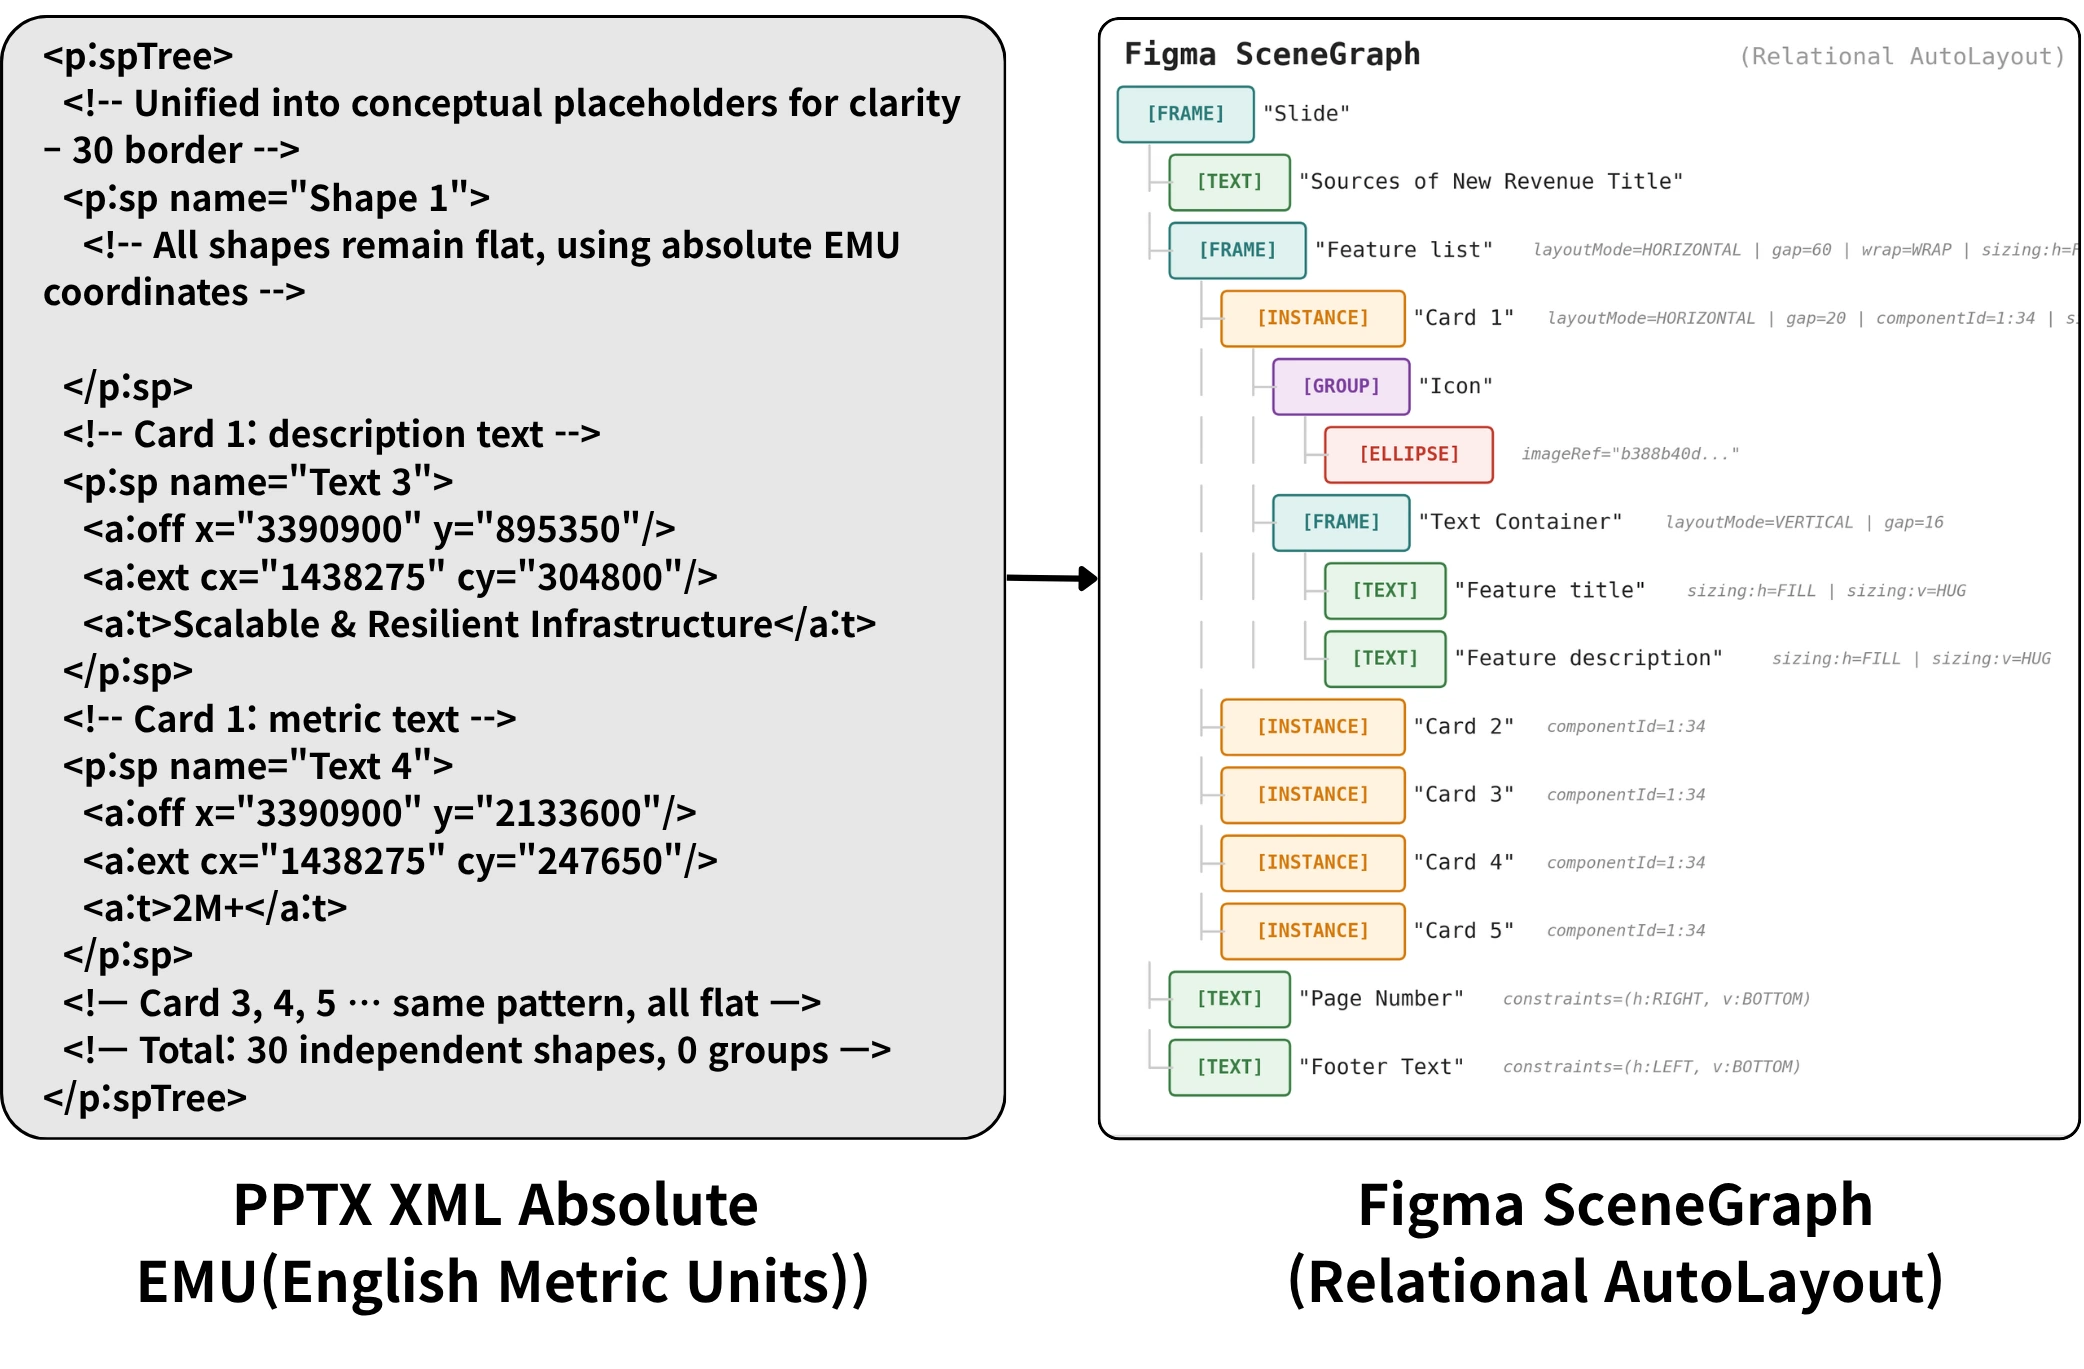
Figure 3(c),論文 Section 3.1 的 representation 對照:原始 Figure 3。我注意到 flat OOXML 的 p:spTree 以絕對 EMU 位置承載 shape,而 Scene Graph 展示 parent–child 與 relational layout;原始 arXiv HTML/source 標示 CC BY 4.0,本圖由作者 PNG 轉成 WebP,依授權保留作教學引用。
Example B:Case 54 的 self-correction
Case 54 是論文用來說明 judge-guided iteration 的案例:
- Input:Agent 先根據 task 在 Figma canvas 上執行一輪 edit。
- State comparison:評估器保留 origin snapshot,並從 origin 到目前 state 建立 JsonDiff;judge 看到的是實際 edit、必要的 render 與 task instruction,而不是一份 ground-truth deck。
- Decision:第一輪 IF=3,沒有達到
τ=4的停止門檻;judge 產生自然語言 critique,下一輪 Agent 讀到 critique 後補足 edit。 - Output:第二輪 IF=4,達到停止條件;若後續迭代分數下降,strict-peak 會回傳已記錄的較佳版本。
- Likely failure point:judge 的分數與 critique 可能受 model family、diff normalization、render quality 或任務文字影響;因此「修正成功」要和 human/out-of-loop evidence 一起讀。
Figure 6,論文 Section 3.3 的 Case 54 final panel;原始 caption 描述 iter1 IF=3 的 critique 與 iter2 IF=4 的結果:原始 Figure 6。原始 arXiv HTML/source 標示 CC BY 4.0,本圖取自作者提供的原始 panel 並轉成 WebP,依授權作教學引用;它是 paper example,不是我重新跑出的 live output。
技術機制:Scene Graph、CARE 與 self-correction
1. Scene graph 把可編輯關係變成 action surface
ACE 的核心 state 是 hierarchical scene graph。node 具有 parent/children、stable source ID、相對位置,以及 auto-layout 的 fill、hug、fixed 等約束;render engine 是 Figma。Agent 不是只回傳一份新的 HTML,而是透過 MCP tools 讀取與修改可定位的 canvas state。
論文列出 98 個工具,分成 11 個 module:contentTools 56、slideTools 13、chartTools 7、dataChartTools 4、smartArtTools 4、tableTools 4、connectionTools 3、importExport 3、Unsplash 2、batch 1、math 1。94-task benchmark 實際呼叫其中 66 個(67%),每個 backbone 使用約 46–57 個;所以不能把「98 tools」讀成每個 task 都獲得完整 action space。
語意化工具是 representation 的另一半。Appendix O 對 active tasks 比較 create_graphics 的 22 個 operations 與 primitives 的 66 個 operations;在 task 需要 chart/SmartArt/table-to-graphic 時,較高階的 operation 可以減少組裝步驟,但這個 comparison 不是說專用 tool 對所有 task 都更好。
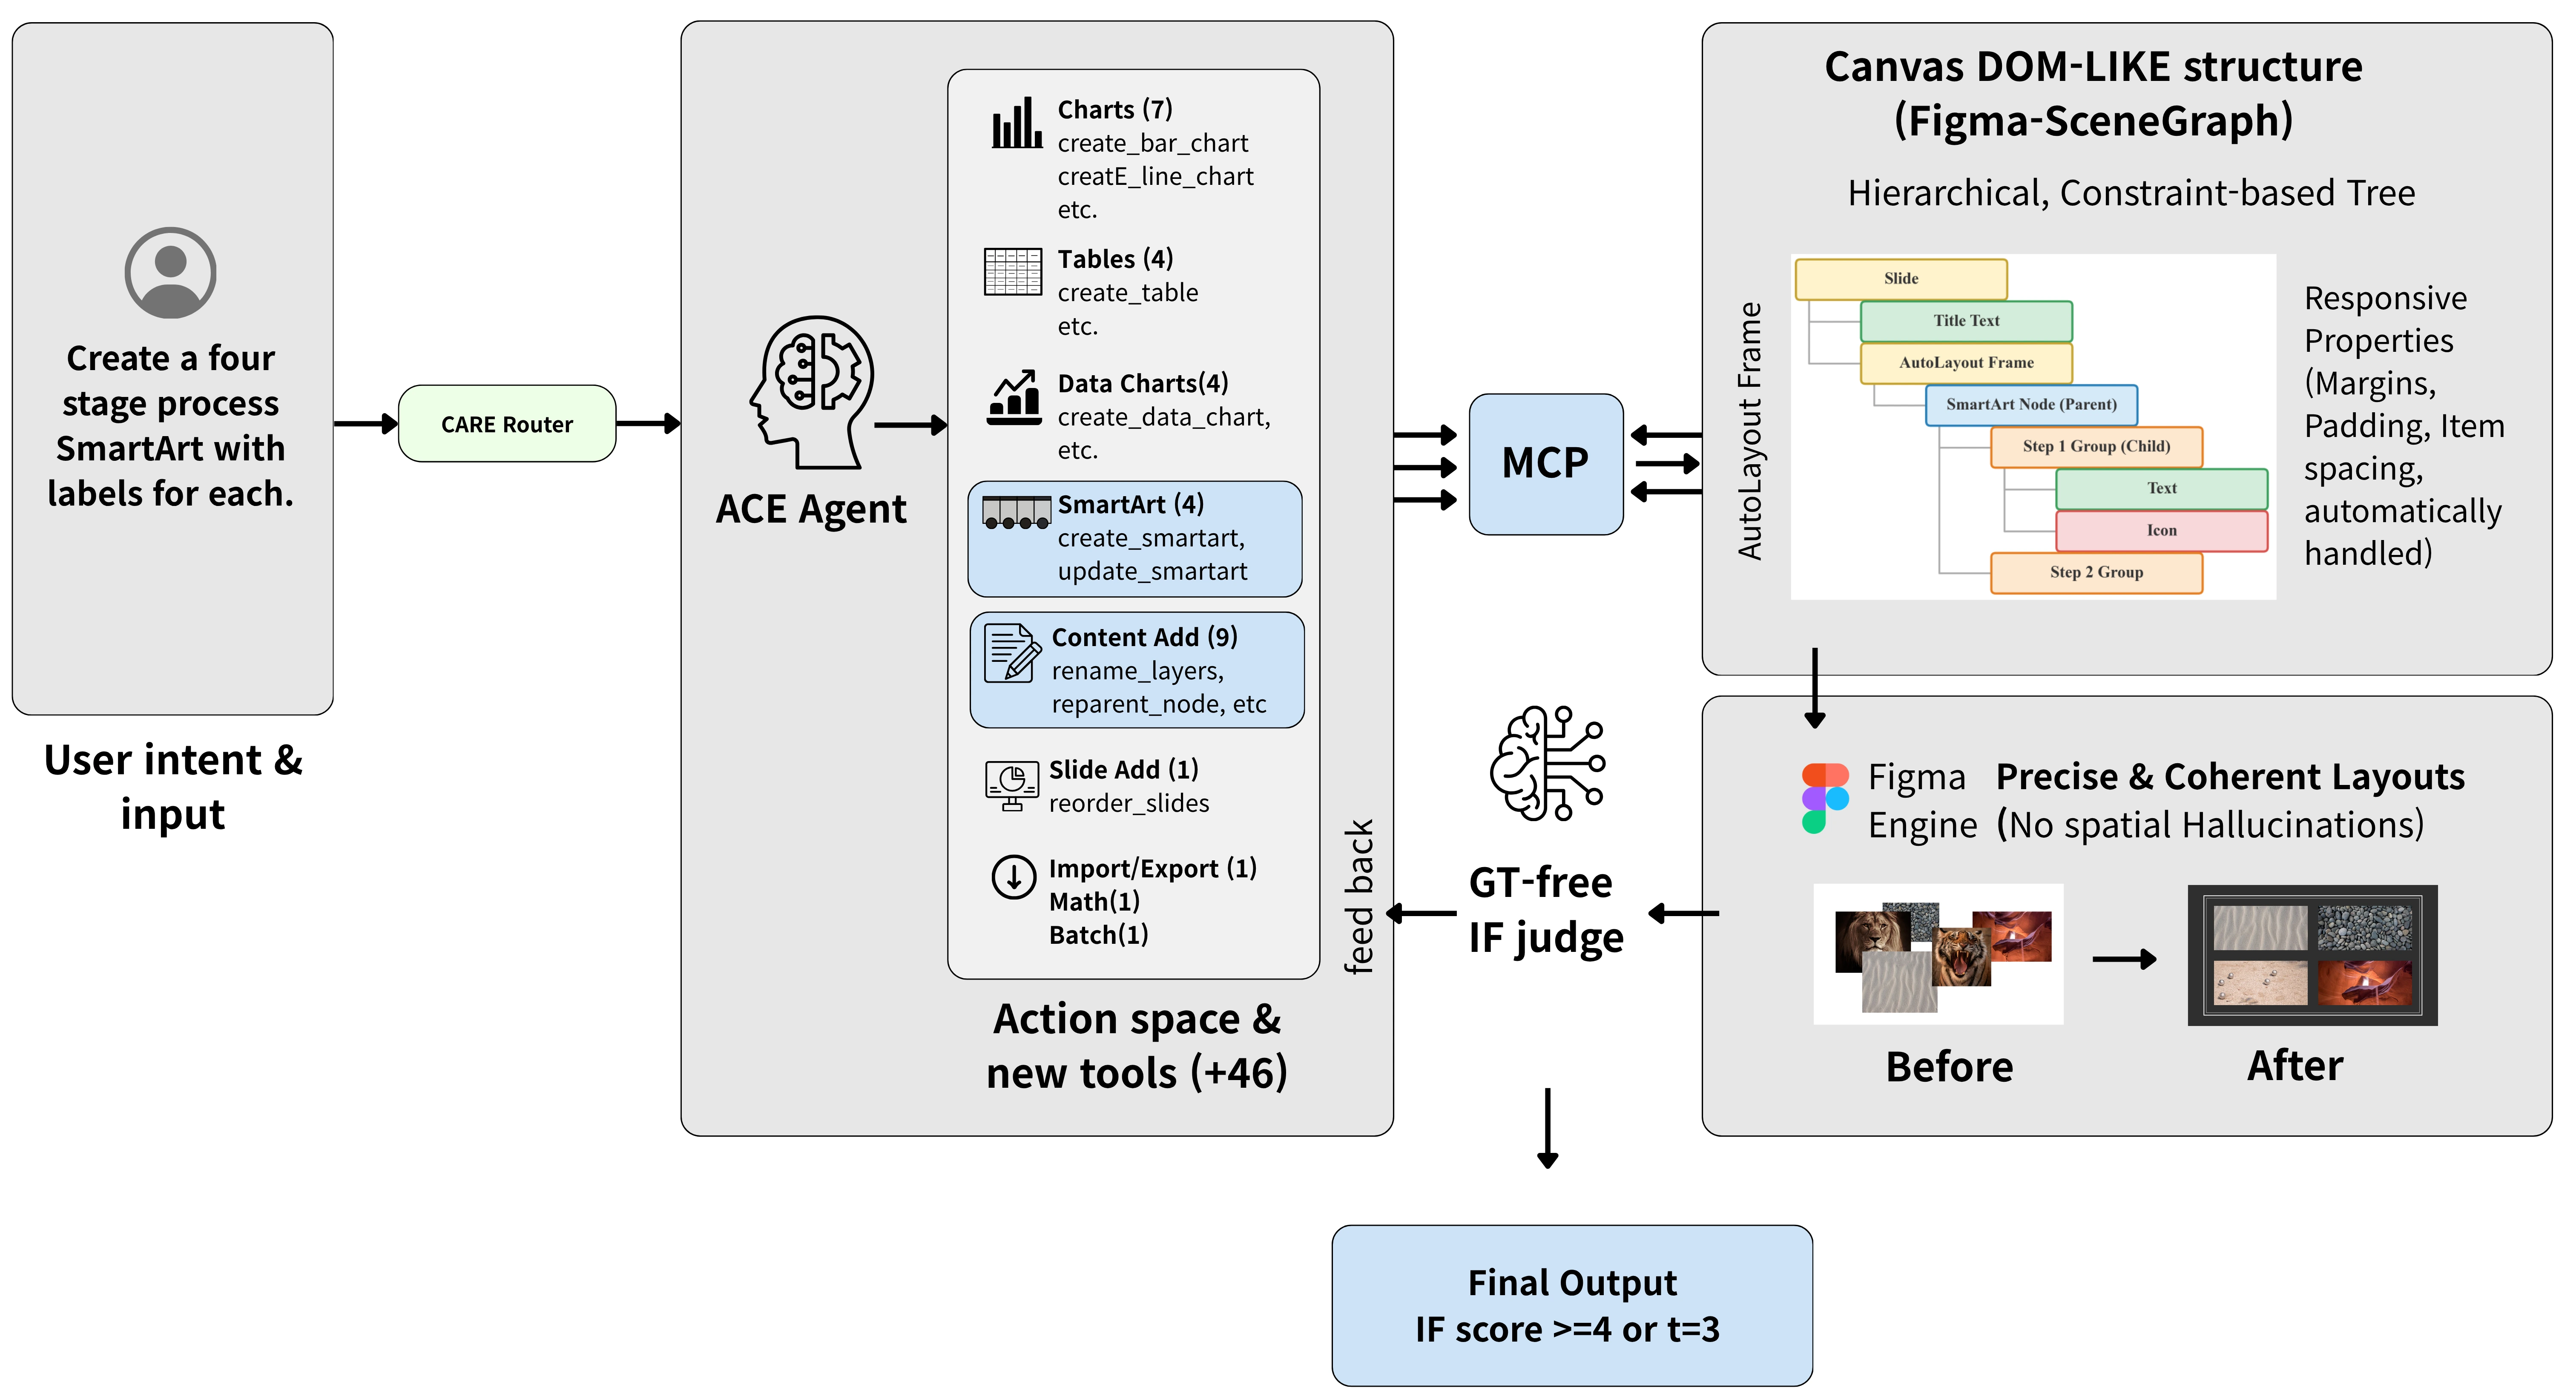
Figure 2,論文 Section 3 的 ACE closed-loop architecture:原始 Figure 2。我注意到圖中把使用者 intent、CARE Router、ACE Agent、MCP、Figma scene graph 與 ground-truth-free IF judge 接成 feedback loop;原始 arXiv HTML/source 標示 CC BY 4.0,本圖由作者 PNG 轉成 WebP,依授權保留作教學引用。
2. CARE 把 context scope 變成可診斷的路由
CARE(Context-Aware Routing and Extraction)有三種 mode:
| Mode | 傳給 Agent 的範圍 | 適合問句 | 論文報告的平均 input-token reduction |
|---|---|---|---|
| Micro-Spatial | target slide 的完整 JSON 與必要 render | 「把這張 slide 的圖例移到右側」 | 50 tasks,86.6%(70.1%–99.9%) |
| Macro-Programmatic | 跨 slide skeleton、node ID 與 text | 「把整份 deck 的標題樣式統一」 | 37 tasks,90.9%(73.3%–98.8%) |
| Systemic-Token | design token/style ID 與全域規則 | 「把 brand color 換成另一套 token」 | 7 tasks,95.7%(90.7%–99.4%) |
這些 reduction 是相對於 full deck context 的 task-level average,不是每個 request 固定少掉 89% token。router 先走 deterministic heuristic,遇到模糊 query 才可用 lightweight LLM fallback;若找不到可靠 scope,會回到較保守的 context。論文的 16-task CARE quality ablation 顯示 full context 反而讓 Claude IF 降 0.75、GPT 降 0.38、Gemini 不變;52/53 routing audit 命中 mode,另有一個 under-scope,沒有 over-scope。
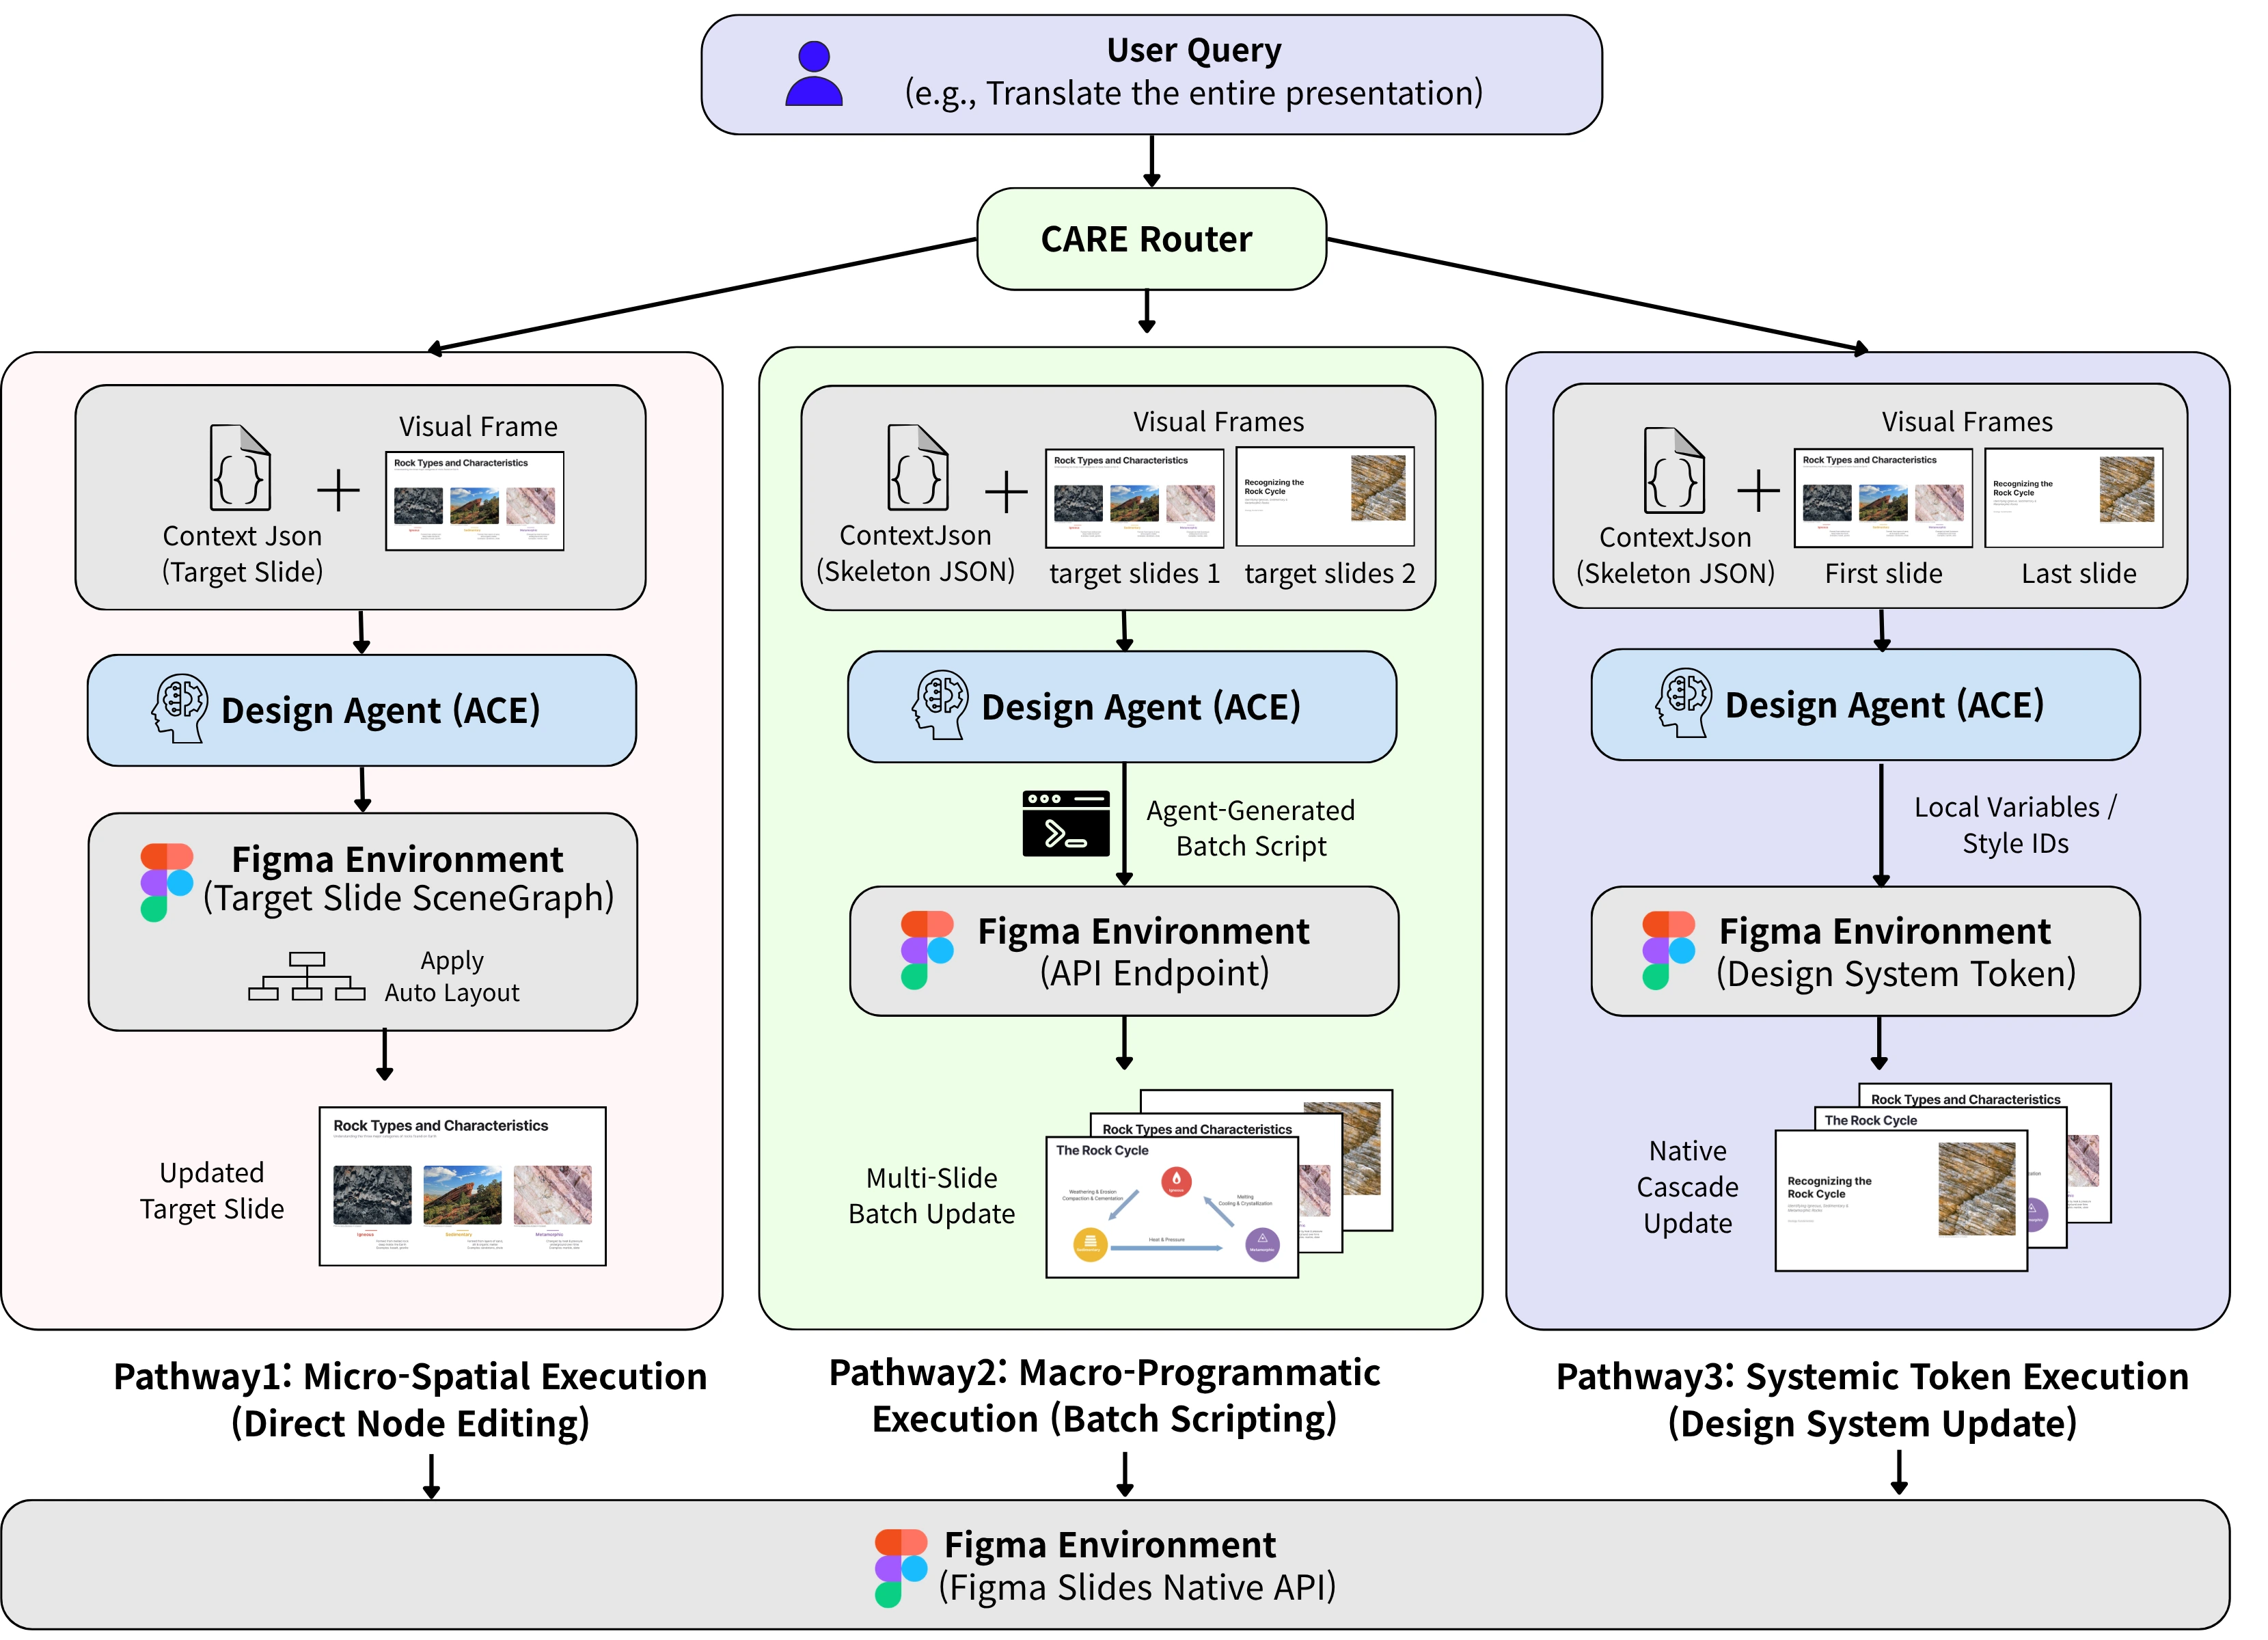
Figure 4,論文 Section 3.2 的 CARE workflow:原始 Figure 4。我注意到三條 pathway 分別對應 local slide、cross-slide programmatic context 與 systemic design token;原始 arXiv HTML/source 標示 CC BY 4.0,本圖由作者 PNG 轉成 WebP,依授權保留作教學引用。這張圖說明 routing design,不是所有 query 都能完美分類的證據。
3. Judge-guided self-correction 與 strict-peak
每一輪 Agent 最多執行 35 個 turns、最多三輪;paper 的設定以 τ=4 作 IF stopping threshold。評估器以 per-slide origin snapshot 和目前 state 產生 JsonDiff,對 text、typography、bbox、rotation、opacity、fill、stroke、effect、children 等欄位做 normalization,並對數值與顏色套用 tolerance;render image 只在 visual changes 需要時附上。judge 因此回答的是「這個 instruction 要求的 change 是否反映在 current state」,不是「current state 和一張唯一答案圖是否 pixel-identical」。
Self-correction 的最小 loop 是:
- Agent 根據 task 執行 edit 並記錄 state。
- evaluator 從 origin→current diff 建立 focused evidence;IF judge 給分與自然語言 critique。
- 若 IF 未達 threshold 且尚未超過迭代上限,critique 進入下一輪;state 會累積,不是每輪從空白畫布重建。
- 只要 trajectory 的分數下降,strict-peak rollback 回傳歷史最佳版本;這讓「最後一輪」與「最佳已觀測版本」分開。
在 Claude 的 53-task self-correction analysis 裡,35/53(66%)第一輪就停止;18 個進入 loop,其中 13 個 IF 平均增加 0.94、VQ 增加 0.78,2 個不變、3 個 regression 不超過 1 分。加入 strict-peak 後,IF 由 4.45 變 4.49、VQ 由 4.02 變 4.06,paper 報告的四個 observed regression 都被移除且沒有 harmed case;這是該設定下的 safeguard result,不是 rollback 讓 judge 變可靠的證明。
實驗設定:任務、基線、指標與成本
Benchmark 與比較對象
Figma Slide Editing Benchmark v1 有 97 個 human-authored tasks;其中 94 個有 origin deck,可自動評測,另有 3 個(Cases 102–104)需要 scope 外的 template retrieval,沒有納入 automatic evaluation。資料由 85 個改編自 PPTArena 的 task(41 個 verbatim、12 個 minor variants、32 個 rewritten)和 12 個新增 task 組成;新增 task 中 9 個沒有 PowerPoint analogue。這使它比純 slide generation 更接近 edit workflow,但也代表 benchmark distribution 偏向作者選定的 structured canvas operation。
主要 53-task head-to-head subset 將 ACE 輸出轉成 PPTX 與 Claude-Skill HTML agentic baseline、PPTArena baseline 比較;subset 並沒有只由 12 個 novel task 組成。Backbone 是 Claude Sonnet 4.6、GPT-5.5、Gemini 3.5 Flash;in-loop IF/VQ judge 是 GPT-5.5,out-of-loop 額外用 Claude 與 Gemini family。每個 pipeline 的 model temperature 為 0,max output tokens 多數為 16,384(Gemini 32,768),Agent 最多 35 turns、self-correction 最多三輪。
IF、VQ 和 human preference 各自回答什麼
IF 來自 original→prediction 的 structured diff,核心是 instruction 是否被完成;VQ 由 rendered screenshot 與 reference screenshot 的 salient change comparison 評分。作者特別提醒,ACE/PPTArena 的 absolute score 不能直接和 PPTArena 原始報告互換:judge family、protocol、沒有 style target 與 Figma environment 都不同。
Human study 有 26 位 non-expert blind raters,排除兩位 rater 後留下 935 judgments;有 51 個 ACE-vs-HTML comparisons 與 17 個 self-correction comparisons。Case 37 的 transition 與 Case 67 的 font adjustment 因變更不可見而排除。Fleiss κ 約 0.20–0.29,raw agreement 約 65%–67%;在決定性 cases 中,judge-human agreement 是 IF 80%(n=41)、VQ 76%(n=37)、Overall 78%(n=50),但這不能移除小樣本與 tie-heavy 的不確定性。
證據如何讀:主結果與三個診斷
1. 完整 benchmark 的 IF 增益,不是全方位視覺勝利
這個結果問的是:「在同一批 94 個可評測 task、同一套 benchmark protocol 下,ACE 是否更常滿足指定 edit?」主要 observation 是:
| Setting | ACE | HTML baseline | 讀法 |
|---|---|---|---|
| Full 94-task GPT IF | 4.23 | 3.81 | paired p=.010,ACE 的 instruction-following higher |
| Full 94-task Gemini IF | 4.62 | 4.21 | paired p=.022,方向一致 |
| Full 94-task GPT VQ | 3.66 | 3.57 | p=.56,沒有顯著差異 |
| Full 94-task Gemini VQ | 3.93 | 3.78 | p=.57,沒有顯著差異 |
作者另報告 ACE 約 1.75x faster、cost 約低 44%;但成本包含 judge/router 的口徑、baseline 的 logging coverage 與 provider price 都會影響解讀。最穩妥的讀法是:ACE 在這份 protocol 內顯示 instruction-level advantage,visual-quality means 仍接近,不能把 IF delta 寫成 universal creative-editing improvement。
2. Human 和 out-of-loop 結果是重要的交叉檢查,但不是獨立真理
26 位 blind raters 在 ACE vs HTML 的決定性勝率是 IF 59.6%、VQ 57.1%、Overall 58.7%;self-corrected vs single-pass 則是 IF 80.9%、VQ 83.5%、Overall 81.5%,只有 17 個 self-correction cases。Overall 的 58.7% 更接近「小型人評 panel 在這批 examples 的 preference」,不是顯著普遍偏好,也不是設計師取代測試。
作者用兩個 out-of-loop judge families 重新評估相同 outputs,排名仍是 ACE > HTML > PPTArena;self-correction IF delta 從 in-loop 的 +.94 降到 Claude 的 +.61、Gemini 的 +.56,約保留三分之二 gain。這降低了 single-judge circularity 的疑慮,卻沒有消除它:in-loop judge 仍參與 loop,且 external judges 與 metric 共享某些 model/protocol assumptions。Human agreement 與 κ 也顯示「哪個畫面更好」本身不是 deterministic label。
3. Self-correction 的增益來自少數需要 loop 的 case,rollback 是 safety net
Claude 53-task ablation 的 no-SC 是 IF 4.04、VQ 3.75;加 loop 後為 IF 4.45、VQ 4.02。35 個 cases 一輪停止,18 個進入 loop;因此 headline delta 不能讀成每個 request 都需要三輪。Sensitivity analysis 也顯示 external IF 隨最大輪數 K=1、2、3 從 4.04、4.26 到 4.38,threshold 由 2、3、3.5/4 也會改變結果。
Representation ablation 顯示 scene graph→OOXML 在 Claude 的 IF/VQ 約 −.64/−.62、Gemini −.78/−.63、GPT −.69/−.45;specialized tools→primitives 在三個 backbone 也有負向差異;CARE full-context ablation 則以 16 個 multi-slide tasks 顯示 Claude −.75、GPT −.38、Gemini 0。這是 component isolation evidence,不能加總成因果分解,也不能證明每個模組在其他 task distribution 同樣有益。
新 task 的 aggregate 也應保留在畫面上:9 個 novel editing tasks 的 ACE self-corrected IF/VQ 是 3.78/3.22,低於 full 94 的 4.23/3.66;Case 101 layered image 是 2/1,Case 109 LaTex→SVG 是 0/0。這些 failure 是提醒,不是噪音:representation 與 tool space 對某些 creative/asset-heavy task 仍不夠。
限制、威脅有效性與未支持的解讀
Judge circularity 與 metric asymmetry
公平性最大的問題是只有 ACE 把同一類 IF judge 放進 self-correction loop;HTML 與 PPTArena 是 multi-turn agentic baseline,卻沒有同一個 closed-loop critique。作者量化了 circularity,並以 out-of-loop families 與 human study 做對照,但沒有宣稱它已被完全排除。VQ 不作為停止訊號,且 full-benchmark VQ 和 HTML 不顯著,正是不能只看 IF 的理由。
Human sample 與 subjective prompt
26 位非專業盲評者、935 judgments、17 個 self-correction cases 對方向有幫助,卻不足以估計廣泛設計市場的 preference。Fleiss κ 的 0.20–0.29 反映有 disagreement;排除 imperceptible cases 能保留可見比較,卻也改變了 sample composition。高度主觀的 brand、composition、typography prompt 可能產生不同 ranking。
Benchmark distribution 與 platform transfer
85/97 tasks 改編自 PPTArena,只有 12 個新增、9 個沒有 PowerPoint analogue;3 個 tasks 甚至不進 automatic eval。53-task head-to-head 沒有 novel-only slice。ACE 以 Figma scene graph/plugin/MCP 為中心,轉到 PowerPoint 或 Google Slides 需要重新綁定 tool surface、layout semantics、render 與 export,不能從 paper numbers 直接外推。
不要從這篇 paper 推導的三句話
- 「ACE 對所有創意編輯都比較好」:不成立;evidence 只涵蓋指定 task distribution,VQ means 也沒有顯著差異。
- 「Judge 可以取代 human designer」:不成立;judge-human agreement 不是完美,且 judge 只看受限的 diff/render/prompt。
- 「Mock 跑通就重現 paper」:不成立;mock 沒有呼叫 model、Figma 或完整 benchmark,full run 需要 credentials、services 與 user-owned decks。
Artifact 與可重現性:mock 可跑不等於 live reproduction
以下是我以 2026-09-17 為 as-of date 讀到的公開 artifact 狀態:
| Artifact | 端點觀察 | 可以支持什麼 | 還缺什麼 |
|---|---|---|---|
| GitHub code | repository public、Apache-2.0;讀到 commit 5c222201dc42290b291ab82a9c65263125f35754 | 可檢查 orchestrator、CARE、tools、evaluator、mock 與 run instructions | live 仍需要 Figma plugin/server、使用者自己的 decks、tokens、model API keys |
| HF benchmark card | public CC BY 4.0;card 描述 94 task pairs/188 decks;API metadata 可取得,頁面標示約 5.53 GB | 可定位 TestA/GroundTruthA 的 deck JSON、frames、index 與 meta.json;Case 108 的 metadata 端點可讀 | 我沒有下載 5.53 GB 全量資料,也沒有把 dataset full viewer 當成 paper rerun |
| execution logs | README/paper 寫 94;我獨立枚舉 repository 的 execution_logs/ 得 93 個 case directories,且歷史檔與 self-correct history 也各為 93 | 可檢查公開案例的 turns、IF trajectory、feedback 與 cost fields | 釋出的 logs 缺 heavy provider payload、完整 PNG render 與部分 raw structure;93/94 discrepancy 需要作者解釋 |
| mock path | python3 main.py --mock 成功;模擬 Case 108、CARE micro routing、iter1 IF=3、iter2 IF=4 | 證明 repository 的 dry-run path 可執行、基本流程可理解 | 沒有呼叫 API、Figma 或 benchmark deck;sample log 與 paper metrics 不是 live evidence |
Mock output 的六步流程是:載入 benchmark、列出 modules、略過未附 decks、模擬 Micro-Spatial context、模擬第一輪 IF=3 的 critique、模擬第二輪 IF=4 的停止。這很適合檢查環境與閱讀 data flow,卻不能當成 Case 108 的實際 reproduction。
Full live path 還要啟動 Socket Server(ws://localhost:3055)、MCP Server、HTTP MCP client(localhost:3001)與 Figma desktop plugin,提供 Figma access token、模型 API keys、IF judge key,並使用自己的 Figma files。故本篇的結論是:code 可讀、mock 可跑、artifact 可檢查;full paper reproduction 仍是有條件的 setup path,而不是我已完成的獨立 live rerun。 這個 distinction 也解釋為什麼我把 execution log count discrepancy 寫成 blocker/risk,而不是自行補成第 94 個 case。
工程判斷與不適用條件
以下是 Bloss0m 工程化整理,不是 paper authors 的新實驗:
值得移植的 workflow contract
- 先選 representation:只要任務會觸發 parent、layout、group、chart 或 cross-slide relation,先保留可定位的 scene graph;不要把所有圖形降成一袋絕對座標。
- 把 scope 寫進 trace:每次 request 記錄 router mode、selected slide/node/token、fallback 原因與 context size;under-scope 應該是可診斷事件,不是靜默省 token。
- 拆開 quality signals:至少保存 IF、VQ、render、tool success、human preference 與 cost;任何一個 judge score 都不應代表整體 creative quality。
- 讓 diff 可回放:記錄 origin snapshot、current state、stable node ID、normalization tolerance、critique 與 judge version,才能知道 correction 改了什麼。
- 把 rollback 當保護層:採用 strict-peak 時同時保留最佳 state 與最後 state,並監控 judge drift;如果只保存最高分,仍可能把被 judge 漏看的 visual regression 帶進 production。
- 把人放在邊界上:品牌敏感、不可逆 export、外部 asset、法律/資料正確性與大幅構圖變更,應保留 human approval 或 policy gate。
什麼時候不該直接採用 ACE 式 loop
- 任務主要是開放式美術、品牌 direction 或「看起來更有品味」而沒有穩定 observable diff;IF judge 很難當成充分停止訊號。
- canvas backend 不是 Figma,且沒有對等的 hierarchy、layout、render 與 tool semantics;直接套用 98-tool schema 會製造假的可移植性。
- 任務的 correctness 依賴外部資料、商標、圖片授權或精確數值;scene graph 和 judge 只處理 edit surface,不能替 provenance 與 domain validation 背書。
- 產品需要一次性、低延遲、低權限的小修改;三輪 Agent loop、router 與 judge 的成本可能高於人工或 deterministic tool。
- 團隊沒有保存 origin/current state、judge prompt、model version 與 rollback event;那就算分數提升,也無法完成 incident review。
因此 ACE 的工程價值應被描述成「一種結構化 canvas Agent 的可觀測閉迴路設計」,而不是「creative editing 的通用增益」。
讀完後的三個記憶點
- Technical idea:Scene graph 讓 parent–child、relative transform、auto-layout 與語意化 tool 成為 Agent 可操作的 action surface;CARE 再把 context 限制到 task 真正需要的範圍。
- Evidence:IF 在 94-task full benchmark 和 out-of-loop/human checks 方向一致,self-correction 在少數進入 loop 的 cases 有增益;VQ means 沒有顯著差異,且人評樣本小、judge circularity 仍存在。
- Boundary:公開 mock 只證明 dry-run path;logs 目前枚舉到 93 cases 而 paper/README 寫 94;full live reproduction 需要私人 deck、Figma/MCP services 和 API credentials。這篇 paper 不支持 universal creative-editing improvement 或 judge replacing humans。
Primary sources
- ACE arXiv abstract and v1 record
- ACE v1 full HTML
- ACE v1 PDF
- Official GitHub repository
- Figma Slide Editing Benchmark card
- CC BY 4.0 license
本文的判讀與 artifact 狀態整理是 Bloss0m synthesis:數字、方法與限制以 paper/repository/benchmark card 為準;工程建議與「哪些地方不能外推」則是我把 evidence 放進實際 Agent workflow 後的明確推論。