遙測資料到 Agent 評測
系列 · 1 篇
-
BTS-AgentBench:把只讀遙測編譯成可重播的 Agent 評測回合
進階精讀 Jeong-Yoon Kim 的 BTS-AgentBench(arXiv:2608.27334 v1):從 BTS 建築遙測建立只讀工具、可執行任務、有限互動契約與證據化評測;精確重播很強,但不等於生產安全或任意領域的可攜性。
90 秒掌握這篇論文
- 問題
- 建築現場累積了多年 sensor 與 equipment 的只讀遙測,但 raw history 不是可直接交給 Agent 的多回合任務。若逐筆手寫任務,既難保留站點的本地名稱與關係,也難維護來源答案、split 與 evidence 的一致性。
- 核心洞見
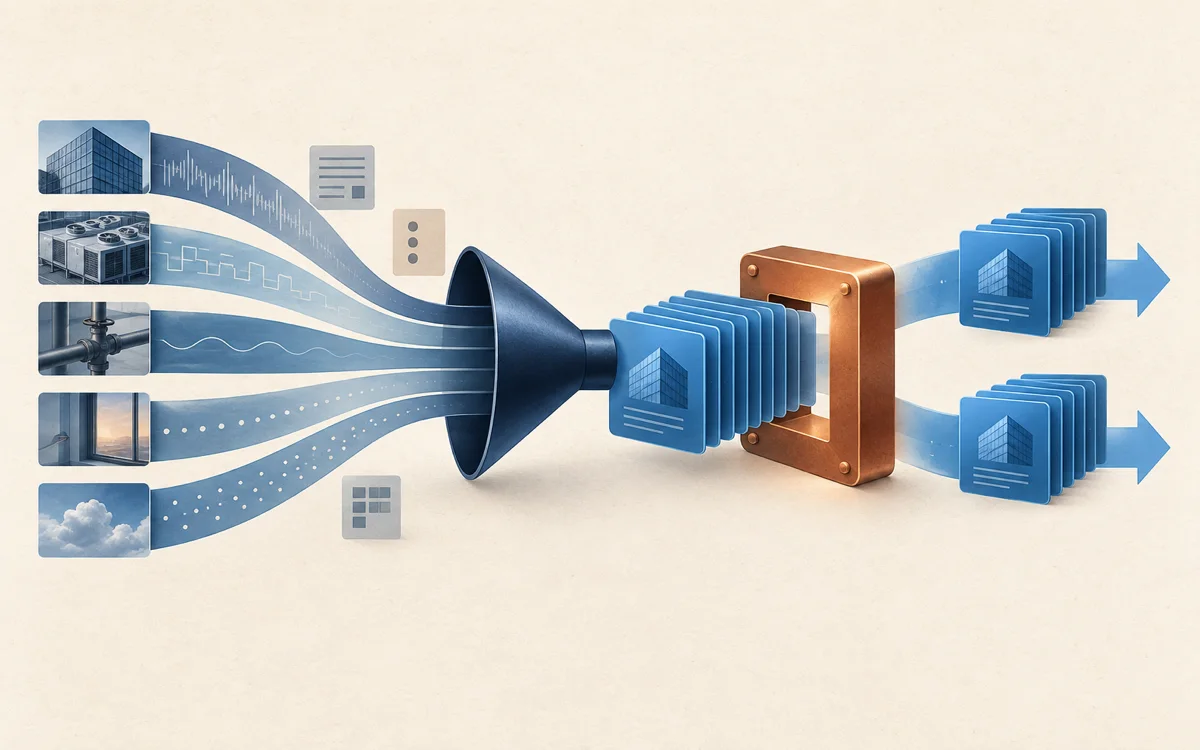
- 把 benchmark construction 當成一條可重播的編譯鏈:先將 metadata 與歷史資料放進只讀 tool store,再由固定規則建立 static task,最後把原本的計算包進 typed、有限的互動契約。互動表面可以增加澄清、目標修訂、nearest timestamp、品質決策與證據追問,但來源計算與 gold 必須一起重新執行。
- 最強證據
- 兩次獨立的 raw-to-episode build 對上 11 個 logical tool-store exports,也逐筆重現 BTS 的 356/87/89 train/dev/test release;公開的 532 筆 episode 通過 coded contract preflight。這是 construction consistency 的證據,不是 operator realism 或生產部署的證據(論文 Table 7、Appendix A.3)。
- 主要邊界
- BTS-AgentBench 是只讀、離線、有限回合的 building-telemetry benchmark。它的零 controller success 是 construction-exclusion 條件,不是任務難度的獨立估計;XAI4HEAT 的 41/41 也只說明第二個遙測 corpus 上的執行可行性,不能外推到任意 event log 或物理控制。
歡迎演講、企業內部技術分享與架構交流;可以先查看我適合分享的主題與公開工程成果。
演講與聯絡