論文精讀
Agent Skills 論文精讀:版本限定外掛遷移的回溯評估
原文:Evaluating Agent Skills for Version-Specific Plugin Migration: A Retrospective Study
90 秒地圖 / The paper in 90 seconds
- 問題:版本升級建議必須遵守目標版本的 API、資料責任、安全邊界與生命週期契約。Agent 能提出聽起來合理的遷移步驟,但若沒有檢查精確邊界或實際可呼叫介面,答案仍可能錯。
- 核心洞見:評分器獎勵「說對了多少」不能取代對「建議是否滿足契約」的檢查。論文把歷史回答、criterion-level judge decisions、任務契約、人工協助覆核與有限可執行機制探針串起來。
- 最強證據:focal comparison 的 16 個靜態任務、64 份報告與 328 個 criterion decisions 中,原始 GLM-5.3-Flash reward 從 93.83 到 98.75,差 +4.92,95% task-bootstrap interval 為 [0.31, 10.86]。但六題改善、兩題退步、八題都在滿分天花板,S1 一題貢獻 +42.5;移除它後只剩 +2.42(Table 1、Figure 3、Appendix A)。
- 主要邊界:這是單一 plugin framework 中、development-exposed static diagnosis 的回溯比較。分數不是正確遷移率;它沒有測量 agent 是否修改並成功執行完整 plugin migration,也沒有跨 framework 的外部驗證(Sections 3、4.1、7)。
這篇論文值得讀的地方,不是「skills 已經被證明有效」,而是作者讓平均分數回到具體契約、裁判敏感度和 artifact 能支持的範圍。以下按這條論證順序讀;本文把原始記錄、直接檢查到的結果與工程解讀分開。 本文依據 2026-09-24 提交的 arXiv v1 cs.SE preprint;其同儕審查狀態未獲確認。
先前方法限制:為什麼遷移建議不能只看分數? / Prior approach limitation
軟體遷移不是把舊名字替換成新名字。維護者要知道目標版本到底公開哪些 API、誰負責產生或保留資料、路徑邊界怎麼定義,以及程序何時必須結束。外掛框架把這些問題拆散在載入、認證、事件、渲染與 shutdown 等不同契約上。模型即使提到正確版本或版本卡,也可能推薦不可用的 API,或漏掉一個讓修補失效的邊界條件(Introduction;Section 3.1)。
Agent skill 將指令、參考資料與工具包成可載入的知識套件。它可能讓代理更快找到版本特定事實,也可能帶入過時步驟、過度自信或不必要操作。過去的 skill benchmark 已顯示不同任務的效益並不一致;因此這篇研究把問題收窄為:在一個已出貨的 dsh plugin-upgrade skill 案例中,增加 skill 可用性時,recorded diagnostic reward 如何變化?評分變化又是否對得上目標版本契約?(Sections 1–2)
這個設計有一個重要的介入邊界:comparison 不是只測 procedure。skill 附帶升級卡、特定版本事實與工作流程;S1 的 rubric 還明確獎勵把答案對應到提供的 migration cards。因此估計量混合了「取得組織好的事實」和「使用程序」的價值。沒有 raw-document 或 generic-procedure control arm,不能把效果單獨歸因於 skill 的編排方式(Sections 3.1、5.2、7)。
核心直覺:從 aggregate reward 走回操作契約 / Core intuition
把一份回答想成多個契約主張的集合:某 API 存在、某元件擁有資料、某個路徑仍在允許根目錄內、某個 timer 修補符合宿主生命週期。Rubric 逐項給分後,deterministic scorer 將 weighted decisions 合成 0–100 reward。這個 reward 有用,因為它能比較同一批任務條件;它仍然只是在既有 rubric 上匯總 judge decisions,不會自動成為軟體行為的 ground truth(Section 4.1)。
本文用「契約檢查」指回到答案依賴的可觀察條件:呼叫 public API 是否可行?.. 是否能逃離 root?測試只檢查提議還是實際跑過?清理函式是在 host unmount 時觸發,還是在仍掛載的 probe 中就得讓 process exit?這些條件比抽象地問「答案看起來完整嗎」更能區分可用建議與得分很高的錯誤答案。
因此研究結合兩層分析。第一層保留全部 focal cohort 的 328 個原始決策,避免只展示成功或出錯的精選案例。第二層把每個選定 rubric criterion 對到契約領域,再對少量回答做非盲、目的性 review 和具體機制探針。兩層回答不同問題:全 cohort 統計描述原始 judge 給了什麼分;bounded review 找到分數可能漏掉的具體反例,卻不能估計反例在整體中的發生率(Sections 4.2、4.4、6.1)。
端到端 worked example:沿 S11 走完整個契約反例 / End-to-end worked example
S11 是全文最清楚的 worked example。任務要求相對路徑不能離開允許目錄。附 skill 的回答提出一個詞法 predicate:接受空字串,或接受非 absolute、且不以「兩個點加 path separator」開頭的相對路徑。這看起來像防止 ../ traversal,但它沒有拒絕剛好等於 .. 的輸入。
- 輸入:系統有一個被允許的 root,例如
/workspace/plugins,答案需要判斷使用者提供的 path 是否留在 root 內。 - 中間表示:實作先把候選 path 對 root 做 relative calculation。輸入剛好是 root 的 parent 時,結果字串是
..;更深層 ancestor 會帶有類似../的 prefix。 - 決策:predicate 只排除以
..加 separator 開頭的字串,所以../child被拒,但字串..本身不符合被排除的形狀,遂被接受。 - 結果:可執行探針在 Node 的 POSIX 和 Windows path algorithms 中都觀察到 parent/ancestor escape。七類宣告 lexical inputs 中,兩種平台合計測的例子有 2 個不如預期,其餘 12 個 control cases 如預期。這只驗證 predicate,不等於驗證 HTTP route、原生 Windows filesystem 或 symlink resolution。
- 最可能的誤讀:把 rubric full credit 當成 containment 已驗證。原始 judge 的確給這個 criterion full credit;bounded review 把 criterion 調為 partial、整份答案從 90 降到 80。是否可被利用還取決於周圍 route,paper 的 probe 沒有執行該 route(Figure 1;Sections 4.5、5.2)。
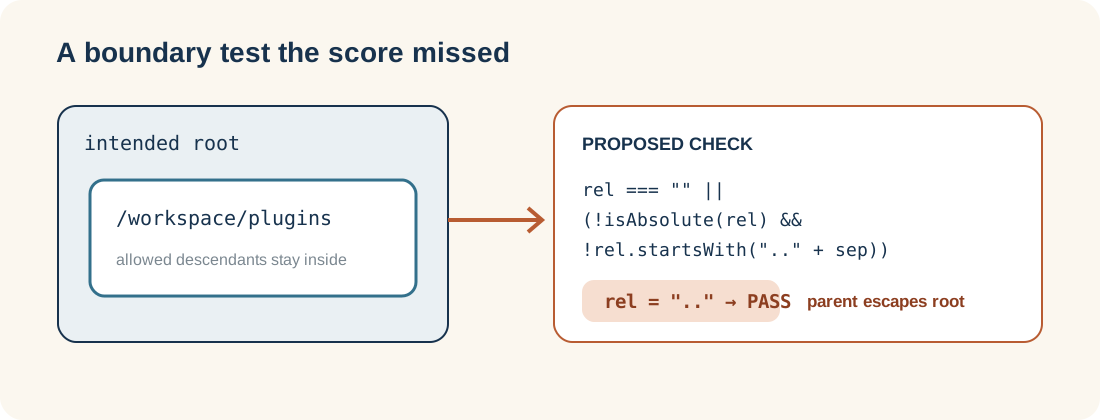
Bloss0m 原創 Figure 1 解說圖,依據論文 Figure 1、Sections 4.5 與 5.2 重畫概念而非複製論文圖。原論文位置:Figure 1 anchor。原圖未重用:arXiv 頁面標示的是投稿用 perpetual non-exclusive license,未見 Figure 1–3 的明確 Creative Commons reuse license。
這個反例沒有推翻 focal mean;它改變的是我們對 reward construct 的信任程度。當 91.5% 原始 criterion decisions 都是 full credit 時,高一致率和高分本身很容易顯得令人安心,但一個被忽略的 parent boundary 足以說明測量仍需要契約層面的有效性檢查(Section 5.3)。
方法骨架:比較了哪一批證據? / Method and evidence tiers
本文只把 focal comparison 當主估計量。作者回顧不同時期累積的資料,明確區分焦點 archive、歷史比較與補充設定。不同配置有不同 task pool、judge、aggregation 和 artifact coverage,不能合併成一條「模型能力曲線」(Sections 3.2–3.3、Appendix B)。
| 證據層 | 資料與角色 | 這裡如何使用 |
|---|---|---|
| Focal comparison | 從 22 個 static tasks 以 seed 20260915 分層抽 16 個;每 task、每 arm 各兩次,合計 64 reports、328 original criterion decisions | 主要的 paired reward estimate、task-level 分布、完整 criterion accounting、有限 review 與 judge sensitivity |
| Historical context | 五個舊配置,56、23、21 或 22 tasks;評分方式、重複數與環境不同 | 只作各自配置內的描述;不併入 focal mean |
| Supplementary evidence | 新 Qwen 16-task 設定,以及後來三輪 GLM-5.3 | 不把缺少原始回答或換 judge 的設定當成 focal estimate 的複製 |
Focal S16 是設定名稱,不是 task S16。抽樣任務包括五個 static-contract diagnosis、七個 runtime/client API、三個 release/install 與一個 Cordis profile;14 個 prompt 是英文、2 個中文。這 16 題來自 development-exposed pool;seeded draw 能重現 selection,但不能把先前 development exposure 變成乾淨 holdout。每個 task 得分先平均兩次,再以 task 為等權單位,計算 skill-minus-no-skill 差,再對 16 個 paired tasks 做 10,000 次 percentile bootstrap。區間描述這批觀察到的任務在 resampling 假設下的變異,不表示任意 repo 或 model version 的不確定性(Section 4.1)。
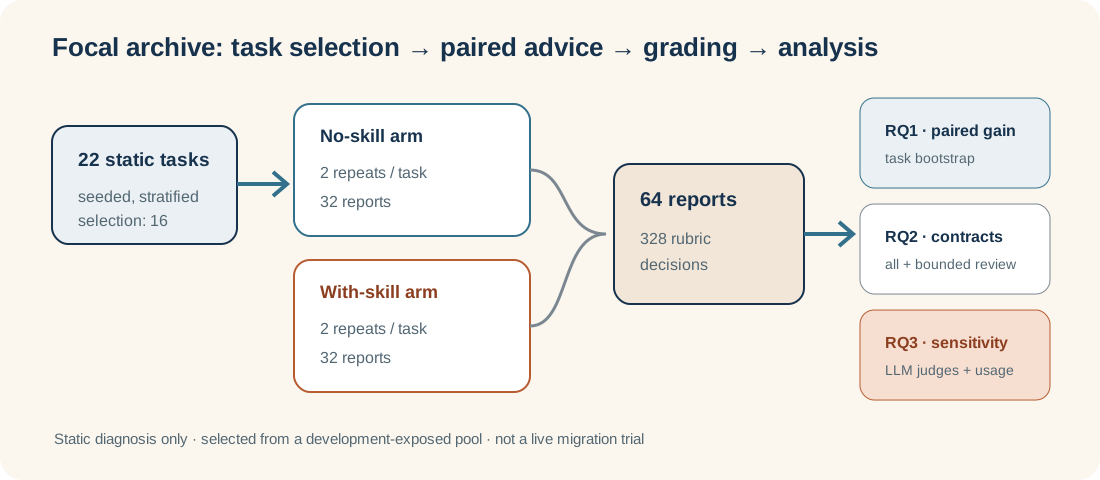
Bloss0m 原創 Figure 2 研究流程圖,依據論文 Figure 2、Sections 3–4 呈現 focal cohort;不含論文圖像素材。原論文 Figure 2 anchor。原圖 reuse 權利未獲明確授權,故本文以原創圖說明流程。
Criterion scorer 對 pass 給全權重、partial 給一半、fail/missing 給零,並可套用 rubric 中的 declared cap。原 judge 先對每份報告給逐項 verdict 和理由,再由 deterministic scorer 算 total reward;提出「應該怎麼驗證」可以符合 static task 的某個要求,但敘述測試不等於已執行測試(Section 4.1)。此區分也解釋本文為什麼保留 advice reward 這個名稱,不把它改寫為 migration pass rate。
結果一:平均增加,但改變集中在少數任務 / Result 1: a higher mean with task concentration
| 原始 GLM-5.3-Flash endpoint | No-skill mean | With-skill mean | 差 | 95% task-bootstrap interval |
|---|---|---|---|---|
| Original judgments | 93.83 | 98.75 | +4.92 | [0.31, 10.86] |
| 只替換 reviewed S11 | 93.83 | 98.44 | +4.61 | [−0.23, 10.63] |
| 替換全部 reviewed decisions | 93.05 | 98.44 | +5.39 | [0.00, 11.80] |
Table 1 的第一列是 archive 原始端點,後兩列只替換少量已 review 判斷,是 sensitivity analysis,不是全資料集驗證後的 corrected score。第一列的原始差異為 +4.92 points,區間下界大於零;但論文把它解讀為描述性關聯,而非確證因果。Figure 3 展示 task-level 分布:6 題改善、2 題退步、8 題沒有改變;後面 8 題在兩臂均為 100,沒有上升空間。S1 一題增加 42.5 points;排除 S1 後,15 題平均差降為 +2.42(Section 5.1、Appendix A)。
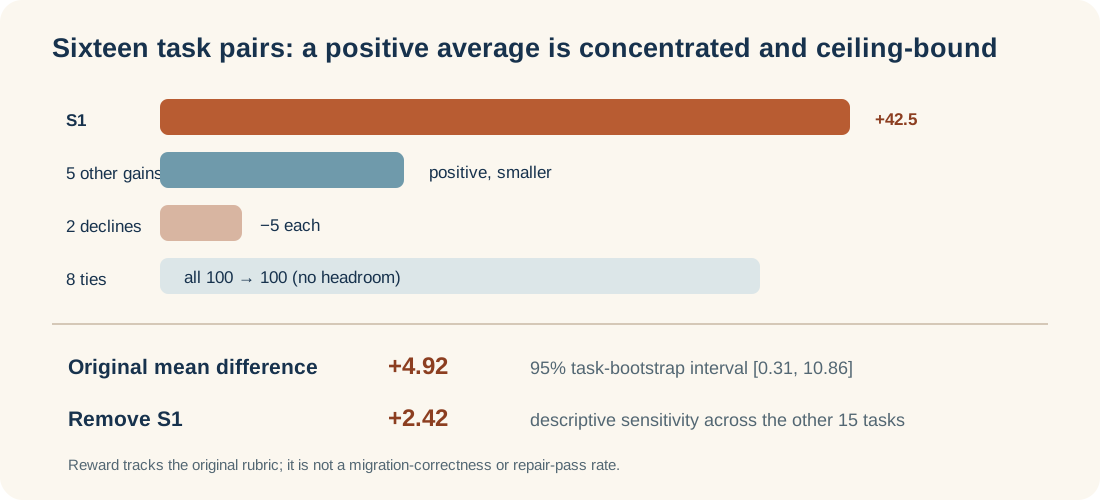
Bloss0m 原創 Figure 3 任務集中度圖,將論文 Figure 3、Table 1 和 Appendix A 的 task-level 結果整理為讀者導向示意;不是原圖複製。原論文 Figure 3 anchor。Figure 3 原圖 reuse 授權未明確,本文以原創圖表達同一項公開數據。
整體 signed-rank approximation 為 p=0.0797,但只有 8 個 nonzero paired differences;作者補充的 exhaustive sign enumeration tail fraction 是 20/256=0.0781。這些是資料描述與 sensitivity evidence,不能因某一種區間或檢定跨過慣用門檻,就把 study 說成驗證一般性的 skill effect。所有 16 個 leave-one-task-out mean 仍為正,範圍 +2.42 至 +5.58;這說明方向沒有因刪除單題而翻轉,但規模非常受 task composition 影響(Section 4.5、5.1)。
歷史比較同樣呈現異質性:舊配置的平均差從 −3.07 到 +10.67,卻使用不同 task pool、重複數、judge、環境、timeout 處理與 protocol。論文不把這些列相加,也不以 baseline score 回歸出能力曲線。補充的新 Qwen 結果報告 +6.72、區間很寬,且原始答案和 grading reasons 未被封存;後三輪 GLM-5.3 的 median lift 是 +1.59,但第三輪換了 judge。它們適合作為背景,不是獨立重現(Appendix B)。
結果二:契約領域的 full credit 不等於安全率 / Result 2: criterion credit is not correctness
作者將 focal rubric criteria retrospective mapping 到六個 primary domains:version/release applicability、API/data/ownership、lifecycle/ordering/deployment、safety/boundary handling、failure attribution、evidence/verification/provenance。Table 2 依 domain 和每 arm criterion denominator 列原始 full-credit counts;例如 version/release 是 8/12 對 12/12,API/data/ownership 是 35/46 對 45/46,safety/boundary 和 failure attribution 都是兩臂全滿。這是對原始 judge 的 finite-cohort accounting;domain mapping 每個 criterion 只指定一個 primary label,沒有獨立驗證成正式 taxonomy,也不代表正確率(Section 4.4、Table 2)。
這也呈現兩個常見錯誤讀法。第一,不能將分母不同的 domain 當作難度排序或因果機制;同一 task 可出現在不同 domain。第二,safety/boundary 的 10/10 full credit 不能說成 verified safe,因為 S11 的父目錄 escape 仍然存在。全體統計讓讀者知道 reviewer 沒有只挑亮點,但原始 judge 的全部決策仍舊可能受 construct validity 限制(Sections 5.2、6.1)。
S6 說明錯誤也可能偏向另一臂。no-skill 答案正確建議移除舊 defensive code,卻把 informational-event handling 完全歸給 host,又建議一條未限定的 append route。Review 將兩項 criterion 變更,把該答從 87.5 降為 62.5;paired with-skill answer 卻保留 100,因它區分 producer responsibility、retention 與不可用的 public surface。修正 S6 會放大 skill 差異,和修正 S11 讓估計下降的方向相反。三個 criterion disagreements 來自十份目的性選取回答中的兩份,不能用來估錯誤率(Sections 4.2、5.2)。
S18 顯示 rubric 可能比任務指示更窄。skill answer 建議 host teardown;原任務描述想解決 probe 掛住,rubric 則要求 timer 在 host 尚 mounted 時就不能阻止 process exit。作者用最小 self-rearming timer child-process reconstruction 測試:timer chain 與未被呼叫的 cleanup 會一直活到 watchdog 停掉;unmount 並取消 timer,或讓每個 timer unref,則自然結束;只 unref 第一個 timer 在另有 live handle 時仍不足。這是機制觀察,不是原 plugin 執行,也不代表 teardown 永遠不能修復 CI hang。partial credit 告訴我們答案沒有符合窄版 rubric,不能推出替代修補無效(Sections 4.5、5.2)。
結果三:評審敏感度、使用量與 Table 3 / Result 3: judge sensitivity and resource accounting
論文以另外兩個模型家族對全部 64 份報告重新評分;每個 item 隱去 arm labels 和先前 scores,沿用同一 prompt、rubric 和 frozen excerpts。條件隱藏有限:18/32 份 with-skill 報告本身會提到 skill;Claude 採 16 個隔離 session、每次四題,GPT-5.5 則在一個 isolated sequential session 中完成 64 題。這是 judge-config sensitivity,而非獨立人類標註(Sections 4.3、Appendix C)。
| Table 3 judge | No-skill → with-skill | Mean difference | 95% task-bootstrap interval | 與 GLM criterion decisions 一致 |
|---|---|---|---|---|
| GLM-5.3-Flash(original) | 93.83 → 98.75 | +4.92 | [0.31, 10.86] | — |
| Claude Opus 5.5 | 87.19 → 97.81 | +10.63 | [3.44, 19.14] | 91.8%,weighted κ=0.64 |
| GPT-5.5 | 93.28 → 99.38 | +6.09 | [1.56, 11.09] | 95.7%,weighted κ=0.72 |
| All-judge mean | 91.43 → 98.65 | +7.21 | [1.98, 13.46] | 不是額外 judge |
兩個 cross-family LLM judge 都保留正向 mean direction,卻估得比 GLM +4.92 大。全體原始決策 300/328 是 full credit,所以 exact agreement 需要和 chance-adjusted weighted κ 一起讀。Claude 對原 judge 是 301/328 一致,GPT 是 314/328 一致;兩者彼此 297/328、κ=0.57。三個評審全是 LLM,沿用同一套 rubric 和 prompt;高一致不證明 rubric 有效,更不是 human validation。非盲 plugin-author review 只涵蓋 56 decisions,且從原 judge 的決策開始,也不是 gold standard(Sections 5.3、7)。
Resource accounting 也必須分開解讀。64 筆 formal execution 的記錄合計 no-skill 3,185,993 個 subagent_tokens、skill 12,320,379,比例 3.87;task durations 加總分別為 9,446 秒和 11,450 秒,比例 1.21。token 欄位沒有分開定義 input、output、cache,因此不是 billing cost;執行有 overlap,duration 加總也不是 end-to-end wall-clock time。研究支持「此配置下較高 reward 同時伴隨較高記錄 token 使用量」,不支持貨幣化 cost-benefit 或「額外 token 帶來更多成功修補」(Section 5.3)。
證據地圖 / Evidence map:資料支持什麼、停在哪裡
| 論文或本文主張 | 支持它的證據 | 解讀邊界 |
|---|---|---|
| 此 focal archived configuration 中,skill 可用時原始平均 reward 較高 | Table 1、Figure 3、16 paired tasks | 描述性關聯;task ceiling、S1 濃度、開發暴露與非隨機 arm order 限制因果解讀 |
| judge 分數可能漏過具體契約錯誤 | S11 predicate probe、Figure 1、Sections 4.5/5.2 | 探針測 predicate,不測整條 request route、symlink 或 live plugin |
| 重算差異依 judge configuration 變動 | Table 3:+4.92、+10.63、+6.09 | 所有 judges 均是 LLM;共同 rubric 未經獨立驗證,不能推出人類一致或正確 |
| 更多 skill-context 與此配置較高記錄 token 數一起出現 | Section 5.3 的 3.87x token ratio | 欄位不是 billing accounting,也不是成功遷移 cost |
| 評估需要把 aggregate reward 連回操作條件 | S6 API/ownership、S11 containment、S18 liveness 案例 | 這是可從案例導出的 review lesson,不是作者驗證過的通用 checklist |
作者的研究貢獻是 traceable retrospective evaluation:任務 contract、原始答案、criteria、judge records 與 resource data 可以接在一起,還可看到一個可執行驗證的反例。更強的命題都沒有被這組資料建立:skills 普遍有效、procedural organization 單獨造成提升、agent 在 live repository 做出正確 repair、或者 LLM judge 分數已由獨立人類確認。這些主張都超出本文實際 endpoint(Sections 1、6、7)。
威脅、限制與外部效度 / Threats and external validity
- Construct validity:static diagnostic reward 並非 functional repair success。Rubric 有些 criterion 獎勵 card mapping 或 metadata;semantic grading 和 keyword grading 也不是同一 construct。將分數正規化到 0–100 不會讓不同 construct 等價(Sections 3.3、7)。
- 內部效度:這是 retrospective archive,skill 與 tasks 由有重疊的 contributor workflow 開發。Seeded sample 仍來自 development-exposed pool。兩臂非 container-isolated,workspace paths 不同;model identity 是 infrastructure 記錄標籤,不是獨立確認 served weights(Sections 4.1、7)。
- 統計結論效度:只有 16 tasks,每臂每題兩次;8 組都在天花板,incident sources 也可能重疊,但 bootstrap 把 task 當可獨立 resample。bounded review 是 outcomes 已知後的目的性選樣,不能估 population error。review replacements 只改被檢查的 decisions,未檢查判斷仍不確定(Sections 4.2、4.5、7)。
- Judge validity:cross-family rerating 降低對單一 judge 的依賴,卻無法消除共同 rubric 的 construct validity 問題。family 和 session structure 部分混淆,每種 judge 只評一次;人類 follow-up 由參與開發的 plugin authors 做、且非盲,沒有獨立 item-level scoring sheet(Sections 4.3、7)。
- 外部效度與可重現性:主 cohort 僅一種 plugin framework 和 static report。完整 future rerun 仍受 live model、dependency 變化影響;歷史與補充 artifact coverage 不同。公開 archive 支援 focal 分析的確定性重算,不保證重現原始未來模型輸出,也沒有跨 framework validation(Sections 7、8、Appendix D)。
論文的中間立場值得保留:案例讓某些原始評分錯誤和 timer mechanism 可被具體檢查,所以比單看 aggregate reward 有更多解釋力;但 selected counterexample 不是全體錯誤率,domain table 也不是 correctness census。兩種證據彼此補充,不應互相冒充。
Bloss0m 工程判斷與不適用條件
Bloss0m 工程判斷:版本限定 skill 適合先當作知識與工作流程的可追溯輸入,而不是 migration correctness certificate。若團隊打算把 skill 的加載狀態當作「修補安全」證據,這篇研究正好說明它缺少哪一層驗證。
對高風險遷移,可以從 paper 案例整理出三種 review prompt:
- API 與責任歸屬:每個建議的 method 是否在目標版本 public surface 上?由 host、plugin producer 或 storage layer 的哪個部分負責事件、保留或寫入?S6 顯示答對版本名不等於答對資料流。
- 邊界值:測試正向子路徑外,也要測 exact parent、ancestor、prefix sibling、empty path 與平台差異。S11 的漏洞只有在
..這個精確值上暴露。 - 生命週期效果:答案描述 cleanup、unmount 或 timer unref 時,先明確要求是「符合 rubric 指定策略」還是「在實際宿主中可達成 liveness」。S18 的兩者不是完全相同的命題。
這三項是從觀察案例整理的 review questions,不是 paper 提出的已驗證通用 framework。當任務要求靜態比較版本知識、追查某個 rubric 為何給分、或定位需要人工/執行驗證的契約時,這篇方法提供可用的評估思路。如果你需要的是 live migration 的通過率、production defect 降幅、安全認證、跨外掛平台的效果,或 skill 本身能因果提升修補正確率,則不應從這篇 focal reward 推出採用結論。那需要 prospective design、raw-document/generic-procedure controls、隨機盲評與 version-pinned executable repairs(Sections 6.2、8)。
Artifact 與可重現性 / Artifacts and reproducibility
截至 2026-09-27,官方 GitHub artifact 可公開瀏覽,repository 標示 MIT license。公開 tree 包含 benchmark task fixtures、各配置的 outputs/results、paper audit records、scripts 與 generated summaries。論文 Appendix D 指出,focal archive 的選擇、schedule、execution order、原始報告和判斷、aggregate scores、paired analysis 與早期 targeted review 均有留存;新增 review 把 frozen selection、criterion verdicts 和 replacement score 獨立保存。
這使研究者能沿存檔資料檢查 task/report coverage、核對報告 hash,並透過 paper/scripts/summarize-submission-evidence.mjs 重算 review sensitivities 與 historical resource summaries,或執行 --check 檢查已提交 summary。本文沒有重跑模型,也沒有重新執行 benchmark tasks。Model/provider state 會變,論文也明確記載身份驗證缺口、missing raw artifacts 和待補聲明;公開檔案可讓 focal recorded endpoint 重算,不表示能重新生成相同 64 份回答或完成 16 個 live migration。
所謂 artifact availability 應按證據層閱讀:focal archive 充分到可追溯報告和原始 criteria;補充 Qwen cohort 的回答與 judge reasoning 不在 repository,無法 exact rerun;future model reproduction 受服務版本和環境影響。MIT repo license 是程式與 artifact 專案授權資訊,與本文不重用 arXiv Figure 1–3 的圖像版權判斷分開處理。原論文圖只引用其 anchor,不複製其像素;本文的三張 SVG 是 Bloss0m 原創教學圖,完整 inventory 也在指定 asset directory。
三件事值得記住:三點離場回顧 / Three takeaways to keep
- 分清楚 endpoint:這個 focal comparison 評的是 skill availability 下的 rubric-scored static advice,不是 executable migration success。
- 看 task distribution 和測量邊界:+4.92 的原始差異伴隨 S1 +42.5、八組 100 分天花板,移除 S1 只剩 +2.42;S11 也證明 full criterion credit 仍可能漏掉
..escape。 - 把重算當 sensitivity,不當 correctness:兩個其他 LLM judge 都估正向 uplift,但不同幅度;共同 rubric、非盲作者 review、token/time accounting 和單一框架都限制外推。
延伸閱讀 / Related reading
- Trajectory-Aware Benchmark Subset Selection(Paper Reading #67):如何看 benchmark 子集選擇和任務集中度。
- Agentic Configuration Management(Paper Reading #74):版本、runtime provenance 和 agent system governance 的另一個軸線。
Primary sources
- Liu et al., Evaluating Agent Skills for Version-Specific Plugin Migration: A Retrospective Study, arXiv:2609.30120v1, submitted 2026-09-24. 本文主要引用 Figures 1–3、Tables 1–3、Sections 3–8 與 Appendices A–D。
- Authors’ artifact repository:benchmark、results、paper audit material 與 scripts;repository 表示 MIT license。