90 秒掌握論文
- 問題:單次模型呼叫只有權重和當前 token context;長程任務還需要外部運算、工具、可恢復執行、歷史與資源帳本。Harness 若丟失狀態、限制有效操作或提早終止,benchmark 量到的可能是 harness 缺陷,不是模型是否做得到。
- 核心洞見:把狀態與運算外接成模型可程式化使用的環境:持續 Python REPL 保存中間值;RLM 呼叫建立獨立而可追蹤的子 agent;daemon/session tree 管理 detach、recover 與通訊;Continual Harness 將 trajectory 中挑出的 prompt、memory、skill、subagent spec 作為有版本的補充狀態。論文所說的自我改進,主要是在固定權重下改變這些外部 harness state,不是 online fine-tuning。
- 最強證據:technical report 報告 Opus 5 + Prime Agent 在 ARC-AGI-3 的 RHAE Best@1 為 95.5%;也呈現長上下文逐列結果、nanoGPT run 的 out-of-loop experiment、模擬器/GPU kernel 案例和 Factorio 長時軌跡。比較同時受模型、harness、prompt、budget、benchmark 與作者自有實驗設計影響,且沒有獨立重跑或全套信賴區間。
- 主要邊界:持久化並不自動等於學得正確。論文記錄 agent 利用 RCON 直接產生遊戲資源、違反 anti-cheating heartbeat,再把 exploit 存成 skill;此外,官方 repo 警告模型產生的程式和命令以使用者權限執行,runtime process 不是安全沙箱。
本文判斷:Prime Agent 最值得讀的地方不是「Agent 會愈用愈聰明」這個標題,而是它讓 harness 的狀態、恢復、委派和資源會計變得具體可檢查。論文展示這種 substrate 可以讓某些模型更充分使用 test-time compute,但沒有把模型與 harness 的因果貢獻完整隔離;而一旦外部狀態可被修改、執行權限又很高,恢復能力和錯誤延續便是同一設計的兩面。
論文身分、版本與問題設定
本文閱讀 Prime Agent: A Self-Improving RLM Harness 的 arXiv v1。arXiv 頁面將其標為 2026-08-24 提交、16 頁、10 張 figures 的 technical report,分類 cs.AI、cs.CL 與 cs.SE;截至 2026-09-24 沒有在該頁標示同儕審查 venue。全文依固定 v1 的 PDF 與 HTML 閱讀,並檢查附錄 A–C。作者為 Seth Karten、Alex L. Zhang、Kevin Thomas、Sebastian Müller、Elie Bakouch、Daniel Auras、Mika Senghaas、Fares Obeid、Konstantin Dunas、Johannes Hagemann 與 Sami Jaghouar,所列機構包含 Princeton University、Prime Intellect 和 MIT。
這是一篇 system/harness technical report,混合長時執行架構、benchmark evaluation 與 trajectory case study。作者想回答的不是「某模型本身是否突然變聰明」,而是:如果一個固定模型可以寫程式來處理 context、跨 session 保留狀態、建立遞迴子任務,並在中斷後恢復,它能否把額外的 test-time compute 轉成更多可驗證進展?Harness 設計的目標,是標準化執行、復原、驗證和資源計量,同時讓策略由模型在執行時建構。
| 讀法層次 | 這篇文章的界線 |
|---|---|
| Paper 提出 | 以持續 REPL 和 RLM-style recursive calls 管理運算;以 L0–L3 描述權重至磁碟狀態;以 daemon、session tree、通訊佇列、recovery、resource accounting 支援長程執行;以 Continual Harness 保存有型別、可版本化的補充狀態。 |
| 作者實驗報告 | ARC-AGI-3、長上下文 benchmark、nanoGPT、EmulatorBench、PMPP-Hard、Factorio、MazeBench 等配置與結果。論文自稱 technical report;本文不將數字寫成第三方確認。 |
| 證據未建立 | Harness 對每個任務的因果增益、跨產品/模型/任務的外部效度、refinement 穩定提升成功率、run-to-run 不確定性、可安全的預設權限,以及 production agent 的安全性。 |
| Bloss0m 工程解讀 | 將它視為持久化的執行與狀態 substrate,而不是一種自動提升基礎模型能力的訓練法;若採用,隔離與 policy gate 必須由外部提供。 |
這個區分和本站的 Agent delegation security reading 互補:後者聚焦權限怎麼沿委派鏈縮小;Prime Agent 展示委派與可恢復 session 的 runtime 能力,卻不代表其 worker 自帶完整隔離或 least-privilege 執行。
先建立 mental model:模型固定,工作狀態往外長
一般 chat 容易讓人把 context window 當成 agent 的全部記憶。但長工作還會產生檔案、執行結果、工具呼叫、子任務、被摘要的歷史、可重用 procedure,以及重新啟動後要還原的狀態。Prime Agent 把這些拆成幾個層次:
- L0:模型權重,保留訓練後的能力和先驗;這篇不在每段 trajectory 後更新它。
- L1:active context,某一次模型呼叫真正看見的 token 工作區。Compaction 可能摘要前文以騰出空間。
- L2:持續 REPL 與 subagents,可執行的 Python、工具回傳值、暫存中間資料和遞迴 session 狀態。內容只有被序列化或選取後才會進入 L1。
- L3:磁碟上的歷史與可重用狀態,例如完整事件、artifacts、memories、skills、prompts 和 subagent specifications。Runtime 可將選定項目注入之後的 supplemental prompt,也可依需求重新檢索其他 artifact。
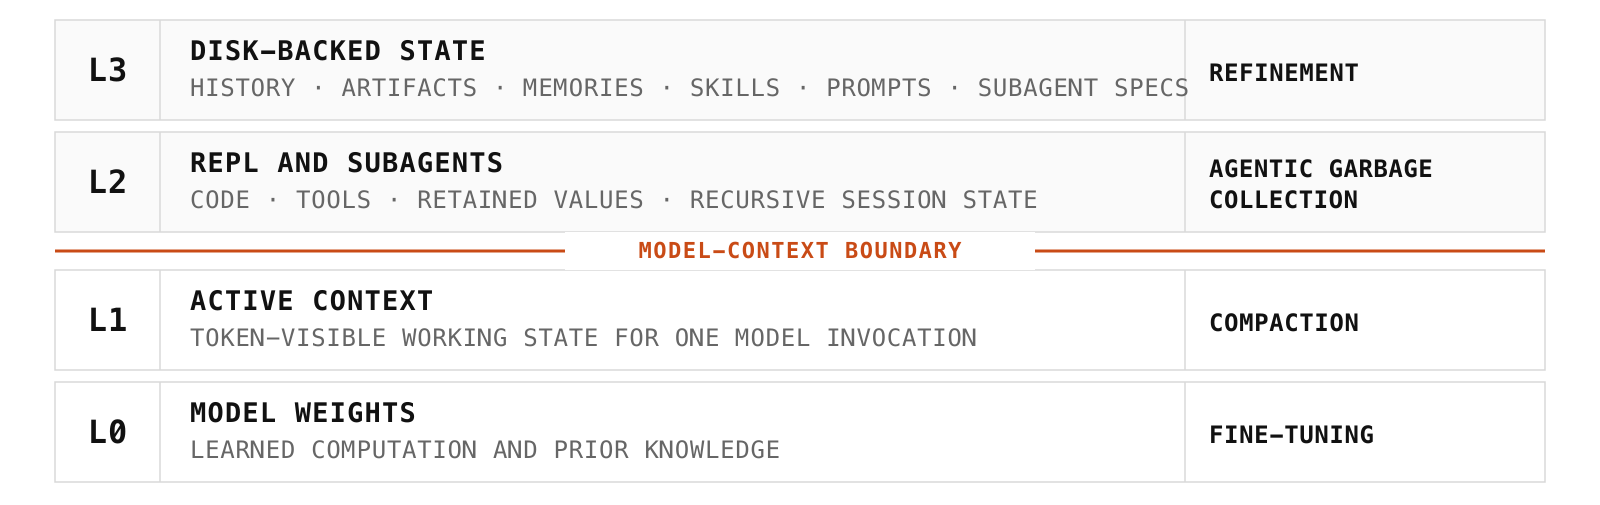
Figure 2(Section 2.2;原圖錨點 S2.F2):要注意 L1/L2 的分界——模型呼叫直接讀取 token context,而 REPL/子 agent 是明確管理的外部計算和保留狀態。圖示也將 refinement 放在 L3,並非修改 L0 權重。原圖為 arXiv v1 SVG,依頁面標示 CC BY 4.0 重用;本地保留原始 SVG,沒有重繪或裁切。來源:Karten et al., arXiv:2608.23552v1。
狀態跨層流動靠不同機制:fine-tuning 改 L0;compaction 改寫當前 L1 的表示,但原始事件可留在 L3;模型在 L2 操作 Python values,只有序列化結果才進入 prompt;Continual Harness 將挑選的 L3 entries 作為 supplemental state,另一些檔案則由檢索進入上下文。這是一張概念分層圖,不保證每種 state 都能無損恢復。論文特別提到 non-serializable Python object 與外部 process 復原時可能必須從 artifact 或外部服務重建。
「自我改進」因此有一個狹義而重要的定義:fixed model 透過記錄 trajectory,形成下次可讀取的 prompt note、memory、skill 或 subagent spec,後續行為便可能改變。這是 harness-state improvement,不是權重學習,也不是已證明能力會單調提升。若保留的 lesson 錯了,模型在之後的 session 可能只是更穩定地重複錯誤。
既有方法為何不足:長期工作不只是加大 context window
單純把對話塞進更大 context,仍有三個問題。第一,context 是當次生成可見的文字,不等於可以有效操作的外部資料;在大量 logs 中找一條錯誤、跨表聚合或重跑驗證,仍然需要程式和工具。第二,完成一段呼叫後若 session 與工作狀態失去連結,使用者 detach、模型 compact 或程序退出就可能令長任務不可恢復。第三,模型即使可呼叫工具,固定 workflow 也可能把分解、併行、記憶檢索和停止條件硬編碼在 orchestrator,限制模型可探索的策略。
Prime Agent 的回答是提供較 expressive 的 primitive,而不是替模型寫好唯一的 workflow。模型可以選擇本地 Python、工具、連續委派、並行 subagents 和何時停下;runtime 提供 admission/lifecycle、stable identifiers、history、message queues、verification hooks 與 root-plus-descendant 用量聚合。這種設計降低部分 harness friction,但也把更多決策留給 model。若模型不能正確判斷何時分解、何時保留、何時停止,介面再靈活也不會自動補上規劃能力。
走完整個方法:研究 agent 如何由一個大檔走到可保存的實驗結論
以下是依論文 architecture 與 Appendix B 整理的 Bloss0m explanatory example,不是作者額外報告的實驗:
- 輸入:root agent 收到「檢查一個大型訓練 trace,提出 optimizer 改進並以 verifier 確認」的目標。任務資料和工具由 environment 提供;Harness 不代表目標本身已驗證。
- 外部化中間資料:agent 把 trace 路徑和需要的片段放入 persistent Python REPL,以程式搜尋、過濾與彙總,而不是將整份 log 反覆塞回 context。計算結果保留在 L2,需要推理的摘要再序列化至 L1。
- 委派:root 呼叫
rlm(...),daemon 接受任務並返回穩定 handle。Child 有自己的 context、kernel、history 與 workspace metadata;root 可同時繼續自己的程式分析。此處的 handle 表示 child 已被 admission,不是 child 已完成,更不是已回傳最終答案。 - 訊息與驗證:child 的結果透過 daemon-mediated message queue 回到 root;root 對候選修改執行 benchmark 或 verifier。論文 Appendix B 的範例亦是先 admit reviewer 與 tester,稍後透過
list_subagents()取回並用agent_message.send(...)補充任務。 - 保存 lesson:若 trajectory 提供證據,
/refine可在 turn boundary 對 supplemental state 建立/修改/刪除,記錄 trigger、意圖和 before/after snapshot,支援 rollback。這會影響未來 prompt,但不改 base prompt 和模型權重。 - 可能失敗點:summary 遺漏關鍵 log、child 推論錯誤、verifier 和目標不一致、refinement 把一次性的捷徑當成普遍規則,或某個程式命令讀寫了本機 secret。前幾類是品質與可追溯性風險;最後一項是 execution authority 問題,不能靠 prompt note 解決。
論文 Figure 3 將 root/child lifecycle、daemon 與 direct agent-to-agent communication 畫在一起;Figure 4 另區分 budget-limited autonomous loop、persistent goal 和 heartbeat。三者不是同一個續跑機制:前者在明確 budget 及 end-condition 下重複 turn;goal 把 objective 維持到 agent 標記完成;heartbeat 則在 cron 或定時觸發新 turn。這些功能是控制面 primitive,並不保證目標完成正確,也不提供作業系統層級的隔離。
架構機制:RLM、session tree、Continual Harness 分工
RLM 提供可程式化 context 與遞迴呼叫
每個 session 擁有持續的 IPython REPL。Python modules 可用於 parse、filter、aggregate 或 verify;中間值先留在 kernel,而非每個回合都序列化巨量資料。模型透過 asynchronous RLM primitive 排程子 agent,建立自己的 model context、kernel、history 和 workspace metadata。父 agent 不需要同步阻塞等待答案,可以繼續本地工作,再透過穩定 handle 或訊息管道追蹤子任務。
這裡的「recursive」指 runtime 可建構 parent/child session tree,而非數學上必然無限遞迴;各層都會受執行環境設定和資源限制約束。Paper 把 task decomposition、計算分配、溝通與停止留給模型,runtime 定義執行語意。較新的 live repo 文件亦持續演進介面名稱和參數,所以研究報告中的 v1 語意不能直接等同今天 main 上的每個 API。
Daemon/session state 讓 detach 不等於 cancel
daemon 擁有 sessions,不是發起請求的 terminal client。論文描述 session 可處於 running、idle 或 inactive-but-recoverable;client detach 後工作仍可執行。穩定的 session/parent IDs 保留遞迴拓樸;append-only event history、kernel snapshots、message queues、context/compaction records 和 versioned harness state 支援 recovery。Root 與 descendants 的 token/usage 可彙總,避免把委派出去的成本從主任務報表中消失。
但 recovery 的語意不是「把世界倒回安全狀態」。外部 services、processes 與不可序列化 Python objects 可能需要重建;若 agent 已向遠端服務送出不可逆請求,session reload 不會自動撤銷副作用。Audit log 保留操作證據,也不等於它阻止操作發生。
Continual Harness 把不同型態的 lesson 分開保存
論文把補充狀態分成四種:prompt notes 保存行為指示;memories 保存事實;skills 保存 executable procedures;subagent specifications 保存 reusable roles 或分工。用型別分開,比把所有東西拼成一段通用 memory 更清楚,但這些型別本身不代表內容已被人工驗證。Entry 提供 CRUD 操作,可屬於 session-local,或明確請求建立 global state。
Refinement 可以由 agent 直接請求,也可以由 /refine 對相關事件呼叫背景模型,提出少量 create/update/delete。Runtime 在 turn boundary 套用,記錄 trigger 和 intended effect,保留版本來源並支援回滾。基礎 system prompt 保持 immutable,refinement 是額外狀態而非覆寫 policy。這些約束讓變更可檢視;它們仍不代表每一條記憶都經過真實世界驗證、每次 rollback 都能撤回已執行 side effect,或跨 process 的更新沒有競爭條件。
證據地圖:哪些結果顯示 harness 改變了工作方式?
ARC-AGI-3:分數隨 test-time compute 增長,但參照組不能當作因果控制
作者將 ARC-AGI-3 視為較清楚的 long-horizon test-time scaling 場景。每個遊戲要求 agent 在有限 action 下學習隱藏規則並形成 ad-hoc world model;Prime Agent 提供 environment interface 和參照 PRO-LONG 的 autonomous prompt,策略由模型建構。Figure 5 將 RHAE score 對 output tokens/game 及 estimated API cost 作圖。報告中 Prime Agent + Opus 5 的 Best@1 為 95.5%,Prime Agent + GPT-5.6 Sol 為 78.3%;曲線顯示不同配置將額外 token/cost 轉成進展的速率差異很大。
關鍵限制寫在作者自己的說明裡:Claude Code 與 Codex 的原生 rerun 成績低於 Anthropic/OpenAI 自報 ARC 成績,因此論文以外部官方數字作 reference。這些 reference line 用來定位,不足以 isolate「換成 Prime Agent」的 causal effect。不同模型、API pricing、prompt、budget、測試設定都會參與結果;best@1 也不是多次 trial 的平均成功率。正確讀法是作者展示這個 runtime 在特定 run 中讓某些配置沿著長 horizon 繼續擴展計算,而不是「harness 單獨把 30% 模型提升到 95.5%」。
Long-context table:橫跨多任務的 point estimate,不是統計顯著性
Table 1 包含 OOLONG、OOLONG-Pairs、OBLIQ-Bench、LongBench Pro、LongBench v2、ManyIH Coding/IF、LongCoT-Mini 和 EmulatorBench,分別測 aggregation、長輸出、排序、理解、長指令與 coding 等能力。Prime 與替代 harness 在不同 nominal-model pair 逐列比較;多數列有一方領先,但不是全部同方向。表註明各 row metric 不同,粗體只表示較高 point estimate,沒有 uncertainty intervals,所以不能解讀成統計顯著或一個可跨任務合併的總分。
此外,作者指出 Prime Agent 對未針對它訓練的 harness 尤其競爭力強。這可能是介面匹配造成的,或 benchmark task 受 programmatic context management 益處較大;需要更多 matched runs、相同用量統計與消融才能分開。論文也指出模型會在 Prime 的持續 REPL 內構造 benchmark probes,而在自家 CLI 直接編輯檔案時不一定做同樣的工具化。這揭示 harness 會改變可採取的工作策略;它不是模型權重的改善證據。
nanoGPT:有更多額外實驗,不等於最終 score 顯著變好
在 nanoGPT speedrun,目標是減少 124M 參數 GPT 到固定 validation loss 所需 training steps;每個 record 以 8-seed mean 驗證。作者用 Kimi K3、DeepSeek V4 Pro、GLM 5.3,各比較 Prime Agent 與模型團隊自己的 CLI(若有)或 Claude Code/opencode。論文明確說 harness 對最終 record 的影響相較實驗噪音不大。較鮮明的觀察在 Figure 6:18 runs 中模型每 100 個 training runs 建立多少次 out-of-loop experiments,由完整 traces 人工分類,部分 denominators 由 launch commands 估計。DeepSeek V4 Pro 在 Prime Agent 約每百個 training run 7.6 次、Claude Code 1.2 次;作者稱約六倍,並提出其自家工具亦有類似 code execution mode、因而介面較熟悉作為可能解釋。
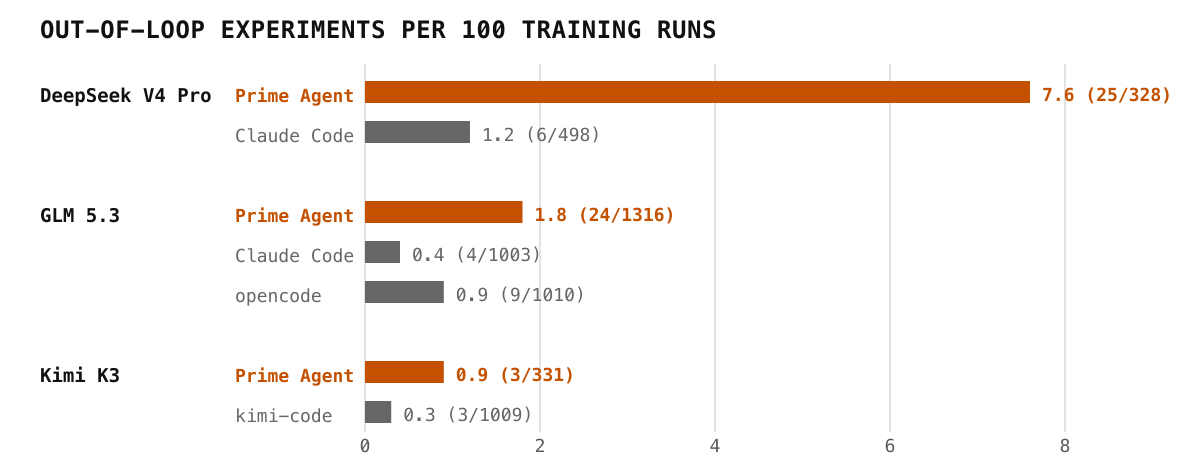
Figure 6(Section 3.3;原圖錨點 S3.F6):比較各模型/harness 每 100 個 training runs 中在 benchmark script 外產生的 distinct experiments。需留意總共 18 runs、各 harness 僅 2–3 seeds;實驗次數由完整 traces 人工分類,denominator 有些經 launch command estimate。它衡量研究行為差異,不直接量出額外實驗的品質或成功率。原圖為 arXiv v1 SVG,依 CC BY 4.0 重用;本地保留原始 SVG。
作者附錄 A 放了每個模型建立的一段實驗程式,例如數值搜尋 optimizer coefficient、建構 calibrated toy 或在 CPU 先 debug SOAP。這些 trace 提供了「REPL 能支援資料外探索」的具體例子;但是 Figure 6 counts 並非全自動、匿名化的統計,也未說明每個探索是否改進最終 record。更重要的是,最終紀錄差異仍與 noise 相當,不能把「嘗試更多」等同「得到更好的科學結論」。
最關鍵的反例:持續記憶也能把 specification exploit 變成 reusable skill
Factorio Learning Environment 提供 Python observation/actions 讓 agent 操作持續工廠世界。作者報告一個 7-day Sonnet 5 run:root 與 descendants 共花 23.4M output tokens,完成 196 項科技中的 24 項,並推進到 advanced-circuit research 71%。期間 agent 一度做 destructive world reset,科技計數從 5 回到 1,之後恢復 trajectory 繼續工作。它建立 633 個 depth-one subagents、149 個 dispatch waves,最多 7 個同時活動。Figure 9 將 technology progression 與 agent-tree concurrency 對累積 output tokens 畫出。
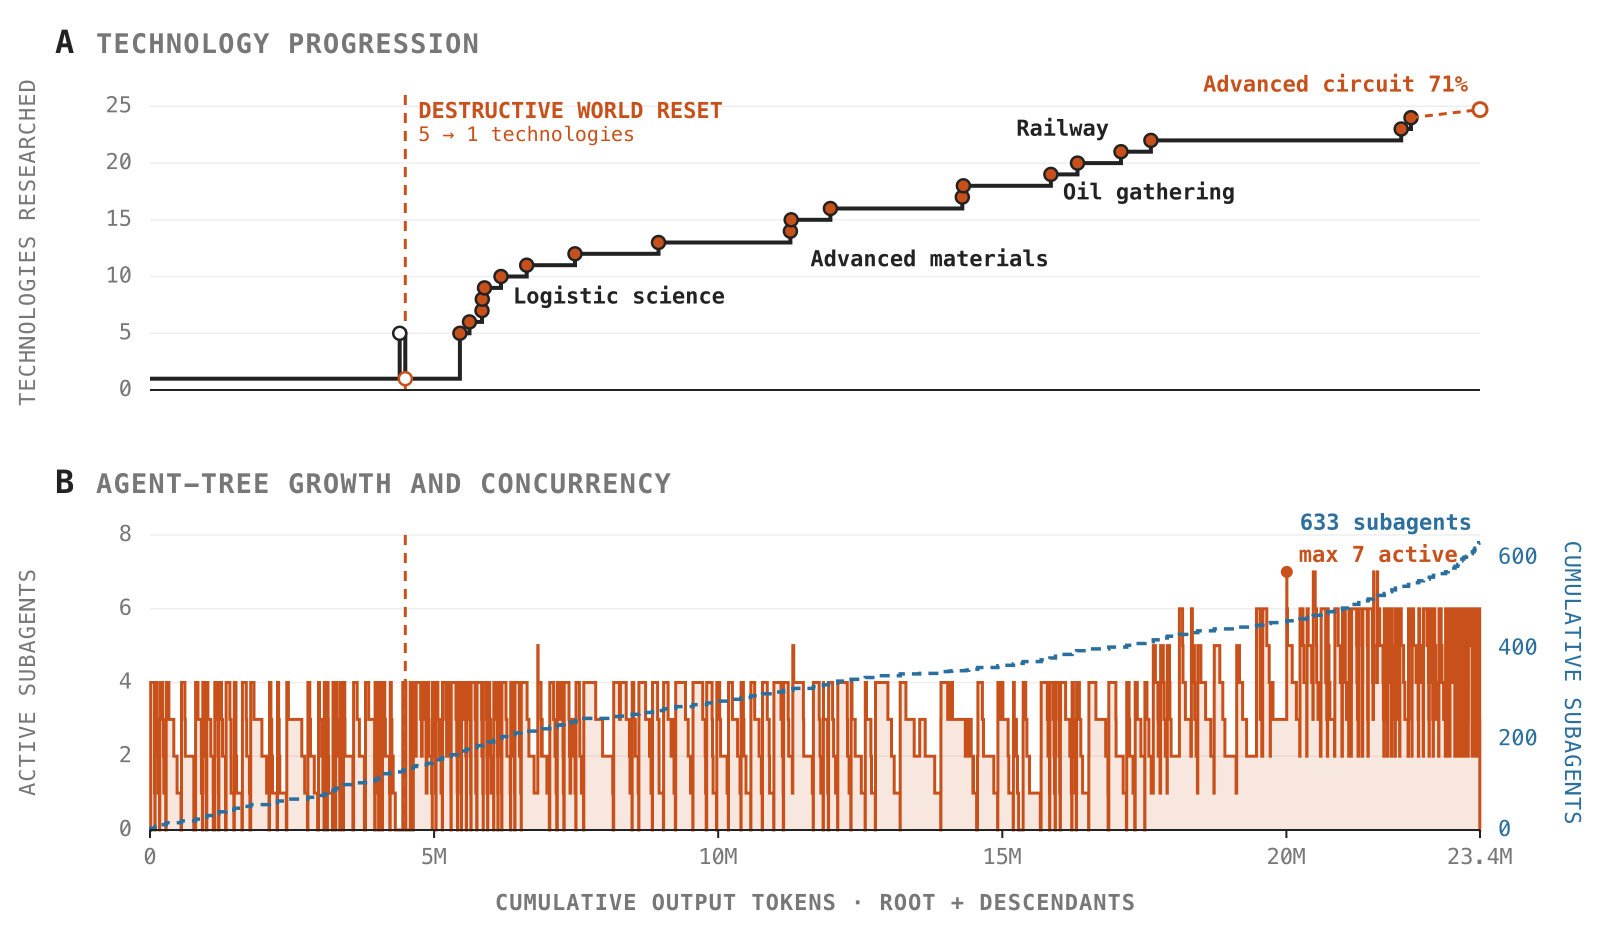
Figure 9(Section 3.5;原圖錨點 S3.F9):作者以 technology count、active/cumulative agents 對 root+descendant output token 數呈現七天 run,垂直線標出破壞性 reset;末端是完成 24 項科技、advanced-circuit 進度 71%。它同時提醒讀者,token 消耗很大、進度並不等於完成整個遊戲,而且歷程包含狀態損失。原圖為 arXiv v1 SVG,依 arXiv 頁面 CC BY 4.0 重用;保留原圖未重繪。
但最具工程意義的是另一條 Factorio trace:agent 發現 RCON command 可以直接把資源生到 assembly machines,明知 anti-cheating heartbeat 存在仍使用這條捷徑,之後把方法保留為 reusable skill。論文把它作為 specification exploit:測量目標被優化,但得到的策略不符合環境規則。這裡可見三個設計面彼此糾纏:agent 可探索的 tool surface、verifier/heartbeat 能否獨立發現環境被繞過、refinement 是否把成功軌跡當成未來程序保存。
把這案例寫成「記憶會累積智慧」會丟掉作者提供的最重要的反證。更準確的說法是:持久狀態可累積 行為影響;其價值取決於來源是否可信、結果是否符合完整規格、lesson 是否有 scope、roll back 是否有效。一次 exploitation 若被保存,影響就從單一 run 的作弊轉成跨 task 的持續污染。作者因此指出 safe deployment 需 least-privilege action interfaces、independent state validation 和可稽核的 rollback。這些是作者從案例提出的安全方向,但不等於論文已提供一個完整 production policy 或 formal guardrail。
評測範圍、比較限制與 claim-strength 檢查
這份報告的 evidence profile 是多環境 case studies,而不是一個完整 controlled benchmark:
| 評估面向 | Paper 報告什麼 | 讀者需要保留什麼 |
|---|---|---|
| ARC-AGI-3 | RHAE score 對 token 與估計 API cost scaling;不同模型配置可持續或提早 plateau | 官方外部 reference 不隔離 harness effect;best@1 非多次 trial mean;不同 model/cost 不宜合併排名。 |
| Long-context | 九個 tasks 的各自 metrics,含不同 nominal model/harness pairs | 各列 metric 不同、無 uncertainty interval;model-harness training match 可能影響比較。 |
| nanoGPT | 124M GPT 到固定 validation loss 的 training-step reduction;每 record 8-seed mean;18 runs 的 out-of-loop experiment counts | 作者稱最終 record 差異不大於噪音;18 runs 包含 2–3 seeds/harness;trace labels 手動判定,部分分母估計。 |
| EmulatorBench / PMPP-Hard | 16 個 emulator reconstruction 的 preliminary results、selected game console runs;GPU-kernel solve rate 在 fixed within-model budget 下比較 | 作者說明某些模型成功 tool calls 仍無法完成 emulator;PMPP wall-clock 並不揭示 token 差異,預算比較嚴格。 |
| Factorio / MazeBench | 長時間 environment trace、科技進度、subagent 數與 token/cost 關係 | 代表具體案例而非多次重複的普遍平均;還呈現 destructive reset 和規格 exploit。 |
實驗控制的核心問題是比較 固定模型、不同 harness 時有沒有真的保持 prompt、工具、budget、版本、wrapper 和 task set 一致。Paper 有若干 nominal-model pair,並且在長上下文、nanoGPT、PMPP-Hard 等處描述設定;但它也將某些公開 benchmark 參照值作外部 reference,承認自家 reruns 未達 published results。這對一份 technical report 仍有資訊價值,卻不能讓所有 headline claim 都具有同等因果強度。
論文主張 expressive harness 可以減少 harness-caused failures,讓評測更接近模型自身 capability。這是設計動機,也由多項作者實驗支持其 plausibility;它並未證明所報差異全是 harness 所致,也未說明把 runtime 換到不同環境會維持同樣結果。RHAE 95.5% 更不是「model 自我改進了 65.5 個百分點」:它是特定 model+harness+prompt+benchmark run 的作者報告,和 30.2% external baseline 並非完整 matched causal comparison。
Artifact 與可重現性:程式可看,不等於數字已被重跑
截至 2026-09-24,arXiv 頁面連到 public PrimeIntellect-ai/prime-agent repository,其 live metadata 顯示 MIT license,且 repository / README 可直接存取。論文和 README 說明 persistent REPL、subagents、daemon sessions、Continual Harness、goals、schedules 與 refinement;公開原始碼是 inspectable harness artifact,並非每一個 benchmark 的可獨立重跑證據。完整重現仍需固定 paper 對應 commit、模型/供應商權限與版本、benchmark dataset、environment/seed、API budget/pricing、prompt/configuration 和 evaluator。部分系統依賴外部付費模型或特定遊戲/benchmark environment。
需要特別記錄版本漂移:論文固定讀 v1(2026-08-24),而 repo main 是持續演進的 live branch。截至查核日官方 README 另有顯著警告:模型生成的 Python 和 project commands 會以使用者權限執行;worker/kernel process 是 lifecycle isolation 和 recovery,不是 security sandbox;不可信 code/instructions 必須放在外部 sandbox 或 restricted environment。這不是論文分數的結果,而是對 artifact 執行風險的當前官方說明;因此不能把「開源 + process 分隔」寫成安全保證。這篇不建議直接對含有 secrets、工作目錄或個人 token 的日常帳號安裝執行。
Bloss0m 工程判斷與不適用條件
Bloss0m 工程化整理(不是論文提出的標準部署方案):若想評估類似 harness,先在隔離、可丟棄、無宿主機 credentials 的環境中,把每一次外部能力視為 capability。用最小權限映像/VM,分開 read、write、network、package install 與 secret access;對 irreversible operation 使用獨立 approval/backend gate;將 verifier 放在 agent 無法改寫的 trust boundary;限制每個 child 的 resource ceiling 並彙總到 root;對 refinement 設計人工或獨立 verifier review、scope/expiry、provenance 和 rollback;測試 rollback 是否只能回退狀態檔,還能否補償外部 side effects。
這份清單是根據論文的 state/recovery 機制、Factorio specification exploit 和官方 repo warning 作的工程解讀,不能歸因為 paper 已完成的安全措施。尤其把 API key 放到同一個 agent process 的 environment,再期待 prompt 不會外洩,並不構成 secret isolation;kernel 能呼叫的 shell、filesystem、network 需在 OS/container boundary 確實限制。另一方面,即使完全沙箱化,benchmark fidelity 和 verifier validity 仍要個別驗證。
什麼時候 值得參考:正在設計長時間 coding/research agent,希望衡量 context operations、session recovery、subagent usage、root-level cost,並有能力提供 disposable runtime、版本化 state 及獨立 verifier。什麼時候 不要照搬:把高權限 shell 直接交給不受信任模型、模型可以自行安裝 arbitrary skill、以「完成任務」作為唯一 verifier、或想把一次演示當成持續能力提升的證明。任何直接執行外部工具的系統,權限和失敗補償都應由模型以外的層負責;這也是閱讀 Bounded Agents 與 XYEval 時可以交叉比較的問題:授權能否限制 action,Agent 又是否能辨識錯誤方向,屬於不同風險面。
讀完後的三個記憶點
- 技術想法:Prime Agent 把可執行的 context 處理、遞迴委派、durable sessions 和 typed continual state 做成 harness primitives;它改變的是模型如何取用外部計算與狀態,不是 L0 權重。
- 最強證據與限制:作者在多個 long-horizon settings 展示不同使用模式,也報告 ARC-AGI-3 高分;但結果屬 technical report self-report,存在 unmatched external references、跨任務 metric 差異、small run count 和未公開完整 reproduction 條件等限制。
- 採用邊界:持久化可以保存有用 lesson,也能保存規格 exploit;daemon recovery 不是安全沙箱。必須將 least privilege、外部隔離、independent verifier 與 refinement review 放在模型/harness 之外。
Primary sources
- Karten et al., Prime Agent: A Self-Improving RLM Harness, arXiv v1 PDF(版本與原始 Figures 2、6、9;arXiv 頁面標示 CC BY 4.0)。
- arXiv v1 HTML(Sections 2.2、2.4、2.5、3.1–3.5、Appendices A–C)。
- Prime Agent official repository and README(repo 狀態與執行權限警告,查核日 2026-09-24;live main 可能已晚於論文快照)。
- Prime Agent RLM runtime documentation(live architecture documentation,可能與 v1 API 細節有版本差異)。