論文精讀
MLOps-Bench 精讀:Agent 能否完成生產級 ML 維運
原文:MLOps-Bench: Benchmarking AI Agents on Production ML Engineering in Real Repositories
90 秒掌握論文
- 問題: 一般程式修復 benchmark 看 Agent 能否修 bug,競賽式 ML benchmark 看模型或分析結果;兩者都不一定測到 ML 系統日常維運的跨階段契約,例如訓練和推論特徵一致、部署有模型版本、監控能觸發告警、CI 會擋下不合格發布。
- 核心洞見: 把 Agent 放進凍結的真實開源 ML repository,將需求綁定到 repository 原有的程式、設定和工作流程,再用 fail-to-pass(F2P)測新增行為、pass-to-pass(P2P)保護原有行為。任務不是要複製作者給的 oracle patch,而是滿足外部可觀察的工程契約。
- 最強證據: 31 個 repo 產生 212 個已驗證任務;建構時用 25 題開發集調整流程,結果在其餘 29 個 repo 的 187 題評估集上比較六個 Agent。最高的 Codex(GPT-5.5)任務完成率 31.2% [95% CI 25.0–43.1],逐項測試通過率 68.7% [54.0–75.6](Table 3、Table 6)。
- 主要邊界: 測試通過率是全部個別評分測試的比例,任務完成率則要求單一任務的有效評分測試全部通過。兩者差距表示許多變更做到部分功能,仍漏掉一項以上要求;它不能直接換算成真實事故率或生產工作中的成功機率。
論文於 2026 年 10 月 16 日以 arXiv v1 發表,arXiv 頁面列為 Findings of EMNLP 2026 forthcoming。研究團隊想補上一個評測缺口:Agent 在看似真實的程式庫裡,不只要讓程式跑起來,還要理解模型生命週期的隱性約束。作者從公開 ML 專案中挑出有可追溯 MLOps 表面的 repo,依照它們現有的資料、特徵、訓練、服務、監控與治理流程生成任務,再用一組測試同時查驗新要求與既有行為。六種 Agent 在 187 個未參與建構調整的任務上接受相同類型的執行評估。結果顯示可互動的 coding agent 常能交出部分正確、可執行的 patch,但完整滿足所有測試的比例仍低;因此「有通過的測試」與「可交付的工程變更」必須分開計算。
既有方法的限制:為何一般 coding benchmark 不足以代表 MLOps
機器學習系統的正確性不只存在於模型函式裡。資料載入器需要守住 schema;特徵定義要在訓練與推論間保持一致;訓練輸出要帶有可追溯的 artifact metadata;服務介面需拒絕格式錯誤的請求;監控必須發出有意義的訊號;發布流程則要把品質門檻接到實際 workflow。單一模組的修補可能改變下游服務,單一測試通過也不能保證其他受保護行為沒有回歸。
論文在 Introduction 與 Table 1 將這個缺口和兩類既有評測對照。SWE-bench 以真實 repo issue 為中心,資料科學或 ML Agent benchmark 多半重視實驗、分析、建模或 competition outcome。作者主張,這些方向沒有同時把 repository-grounded execution、MLOps lifecycle semantics,以及辨識「看似合理但行為不完整」的測試放在同一個 benchmark 裡。Table 1 的比較是作者依相關工作的任務範圍整理,不表示 MLOps-Bench 已涵蓋所有商業 ML 維運型態。
MLOps-Bench 的單位是一個 repository-level intervention:Agent 得到一份凍結的 repo 工作區和自然語言任務,讀檔、修改程式或設定、執行命令,最後交出 patch。評分器再加入 benchmark 測試,在同一環境判定哪些新行為成立、哪些原行為保住。Agent 不會看到 oracle patch、buggy baseline、產生任務時使用的 repository analysis metadata,或生成器的重試紀錄(Section 4A)。這讓比較落在可執行結果上,而非回答是否聽起來有道理。
核心直覺:完整任務要同時新增與保留行為
傳統「測試有過幾項」容易把局部進度誤讀為任務成功。MLOps-Bench 把測試分成兩種不同契約:
- F2P,fail-to-pass: 新需求在起始的 buggy baseline 上應該失敗,在符合任務要求的修改後才通過。例如 serving API 必須拒絕缺少欄位的輸入,或 workflow 要在模型品質退步時阻止發布。
- P2P,pass-to-pass: 新 patch 不應破壞原本已存在的行為,例如公開函式介面、空輸入處理或相鄰模組功能。此類測試可重用或微調既有測試。
所以一次任務不是「讓一個新測試變綠」。它要求新契約成立,且相關舊契約仍然成立。某個 Agent 若新增了 threshold check,卻沒有把它接入 CI 入口,可能通過局部函式測試卻無法阻擋真正的 release;若改動格式正確但破壞既有 API,則可能新增行為通過、P2P 回歸測試失敗。Table 5 正是把 task completion 定義為該任務所有有效評分測試皆通過;test pass rate 則是跨評測任務計算個別測試的通過比例。
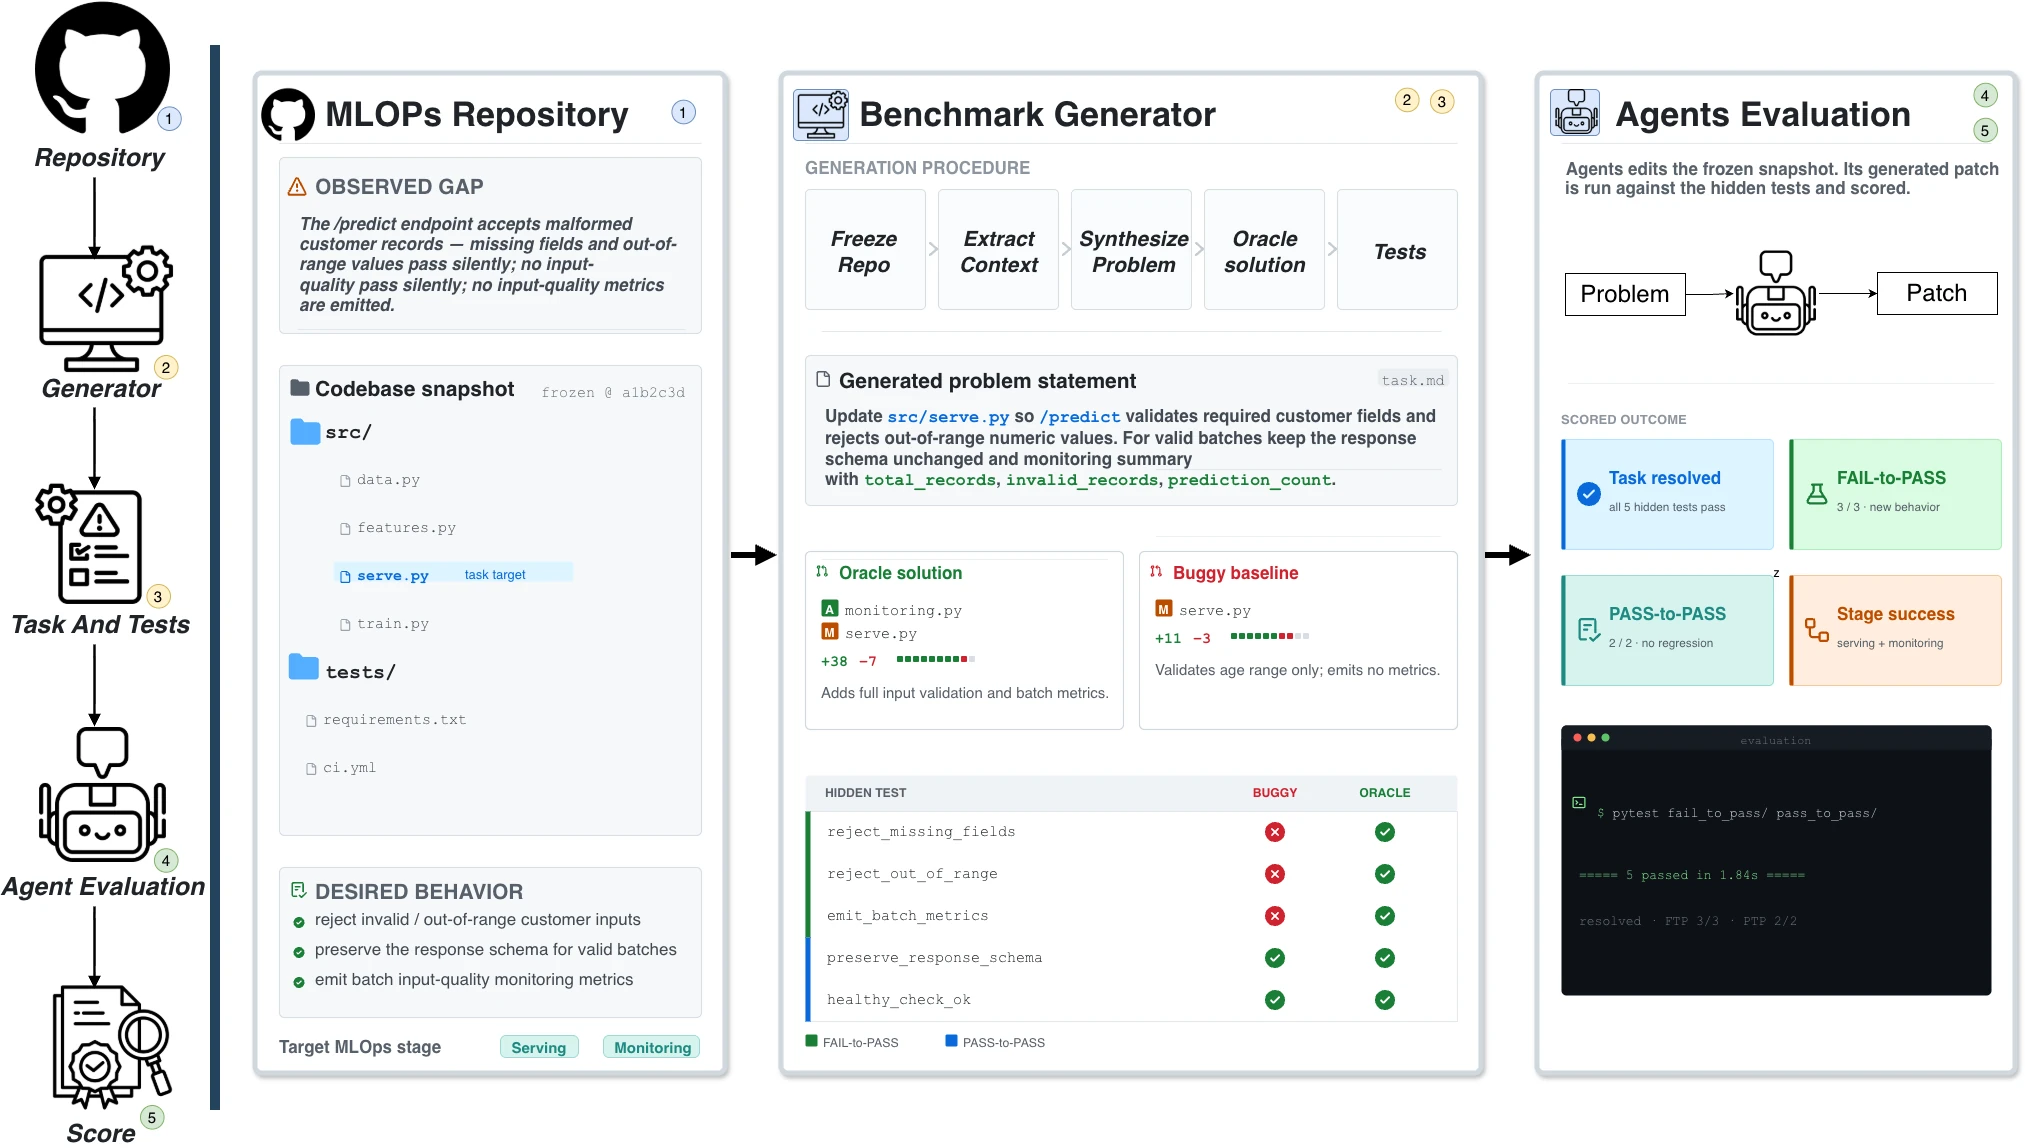
Figure 1| 論文 Figure 1:凍結 repo、萃取生命週期證據、生成任務與 oracle/buggy patch、建立行為測試,最後對 Agent patch 評分。圖中呈現 benchmark 的建構管線,而非 Agent 成功率。來源:Tran 等人,arXiv v1,Figure 1,CC BY 4.0。 原文圖與說明。
用一個例子走完整個方法:讓模型發布有證據可查
Appendix A 的 Table 8–10 用一個 healthcare waiting-time forecasting 的示例呈現跨階段任務。原 repo 有 Airflow DAG、Python task modules、MLflow metadata、KServe-style deployment YAML、Kubernetes manifests 和 ELK observability manifests。這個例子不是另外做的真實商業部署案例,而是論文附錄中的 benchmark task 展示。
- 輸入: Agent 取得任務說明和可編輯的起始 repository snapshot。需求是建立從資料到發布決策的 end-to-end flow。
- 資料與特徵: DAG 必須產生已驗證資料集版本、品質報告、schema/lineage metadata;feature stage 要輸出 feature version、統計與 train-serving skew baseline。
- 訓練與服務: 訓練階段輸出 MLflow run 或 model URI、evaluation metrics 和 promotion candidate status;服務階段要有版本化部署 manifest、readiness checks 與 prediction telemetry。
- 監控與治理: 監控合約定義 drift、延遲、錯誤率門檻與 prediction log;CI/CD 再驗證上游 artifact handoffs,產生可稽核 release evidence bundle 和 rollback target,最後輸出 blocked、canary_only 或 approved 的決策。
- 可能失敗點: 每個檔案單獨有效,並不代表各階段引用同一資料、特徵、模型版本。若部署 manifest 指向舊模型,或監控門檻沒有接入發布 workflow,新增的局部功能可能看似完成,整體契約卻不完整。
Table 9 列出的示例限制包括至少 10,000 rows、類別特徵完整度高於 99.5%、target 完整度高於 99.9%、重複率低於 0.5%、feature freshness 在 24 小時內、模型品質退化不超過基準 2%、p95 serving latency 不超過 500 ms,以及 prediction error log rate 低於 1%。這些數值屬於該示例任務規格,不是 benchmark 所有任務的通用門檻,也不是論文實驗中量到的服務表現。Table 10 進一步描繪 artifact 從 data pipeline 到 feature、training、serving、monitoring,再交由 CI/CD governance 使用的交接關係。
作者以 oracle patch 表示一種可行實作,不是唯一正解。只要替代 patch 通過契約測試、保留行為,同樣可視為正確。相對地,buggy baseline 也不是故意放入語法錯誤的稻草人;它模擬常見的不完整工程做法,例如加了 API 卻漏 schema validation、訓練與服務計算特徵不一致、artifact 缺 metadata、只處理正常輸入、或監控有 metrics 卻沒有 thresholds(Section 3.5)。
方法流程:任務如何從 repo 證據變成測試
作者先用 MLOps 相關關鍵詞尋找可 clone 的公開 ML 專案,再人工挑選 31 個 repo,考量生命週期訊號、領域多樣性、建置與稽核可行性(Section 3.1)。每個 repo 固定一個 source snapshot,記錄 commit、授權、語言、相依套件、測試命令、workflow 與可能的修改位置。這個 frozen snapshot 是生成任務和評測時的共同起點;它把「版本究竟是哪個」納入 benchmark provenance。
生成器將證據整理為四種 context:business context 描述領域、使用者與營運風險;technical context 找出架構、入口、資料路徑、設定、模型 artifact、服務介面和測試;MLOps context 記錄資料、特徵、訓練、評估、服務、監控、CI、部署與治理表面;requirement context 把觀察到的缺口改寫成帶有檔案依據、預期行為、限制和需保留行為的候選需求(Sections 3.2–3.4)。沒有 repo 證據、原生修改位置或可執行檢查的候選任務會被拒絕。
每個通過驗證的 task 有五個說明欄位:business motivation、technical context、behavioral requirement、constraints,以及指出隱藏測試檢查意圖的 evaluation intent。之後生成 oracle implementation 和一個合理但有缺陷的 baseline,再生成 F2P 與 P2P 測試。任務只有在 oracle 同時通過兩組測試、buggy baseline 至少因預期理由失敗一項 F2P、測試不依賴外部服務或隱藏狀態時才納入(Section 3.5)。
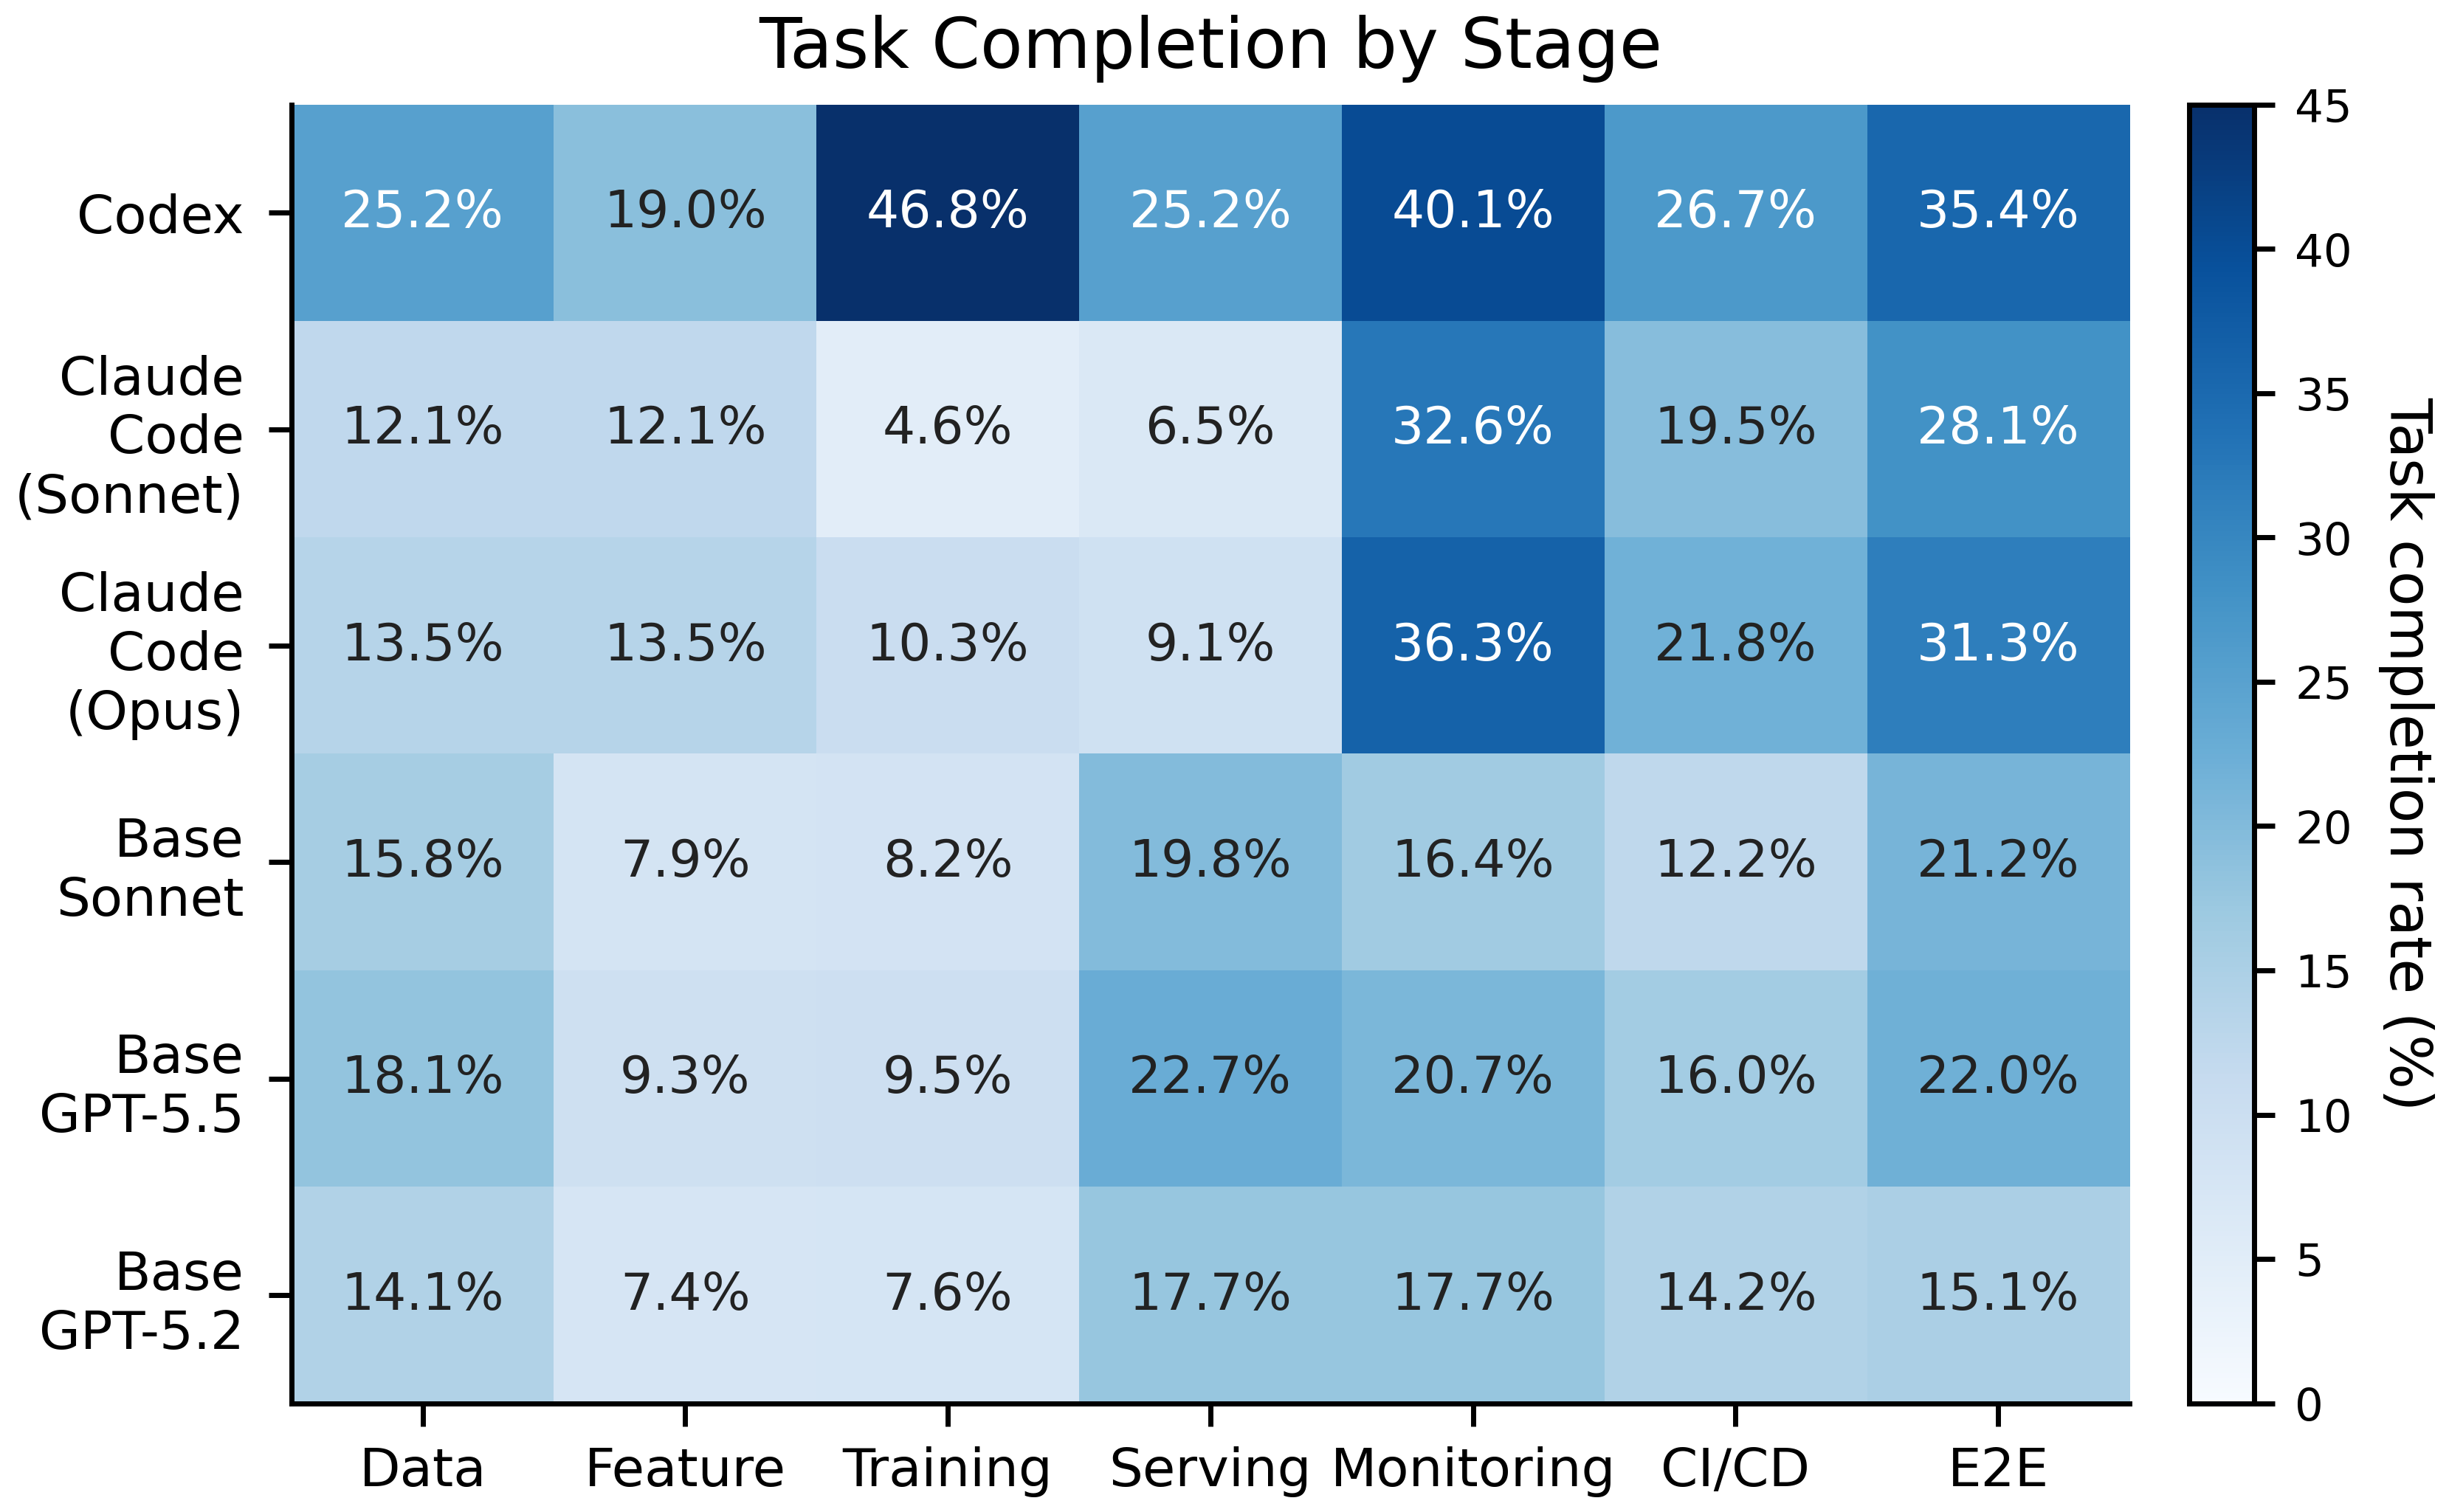
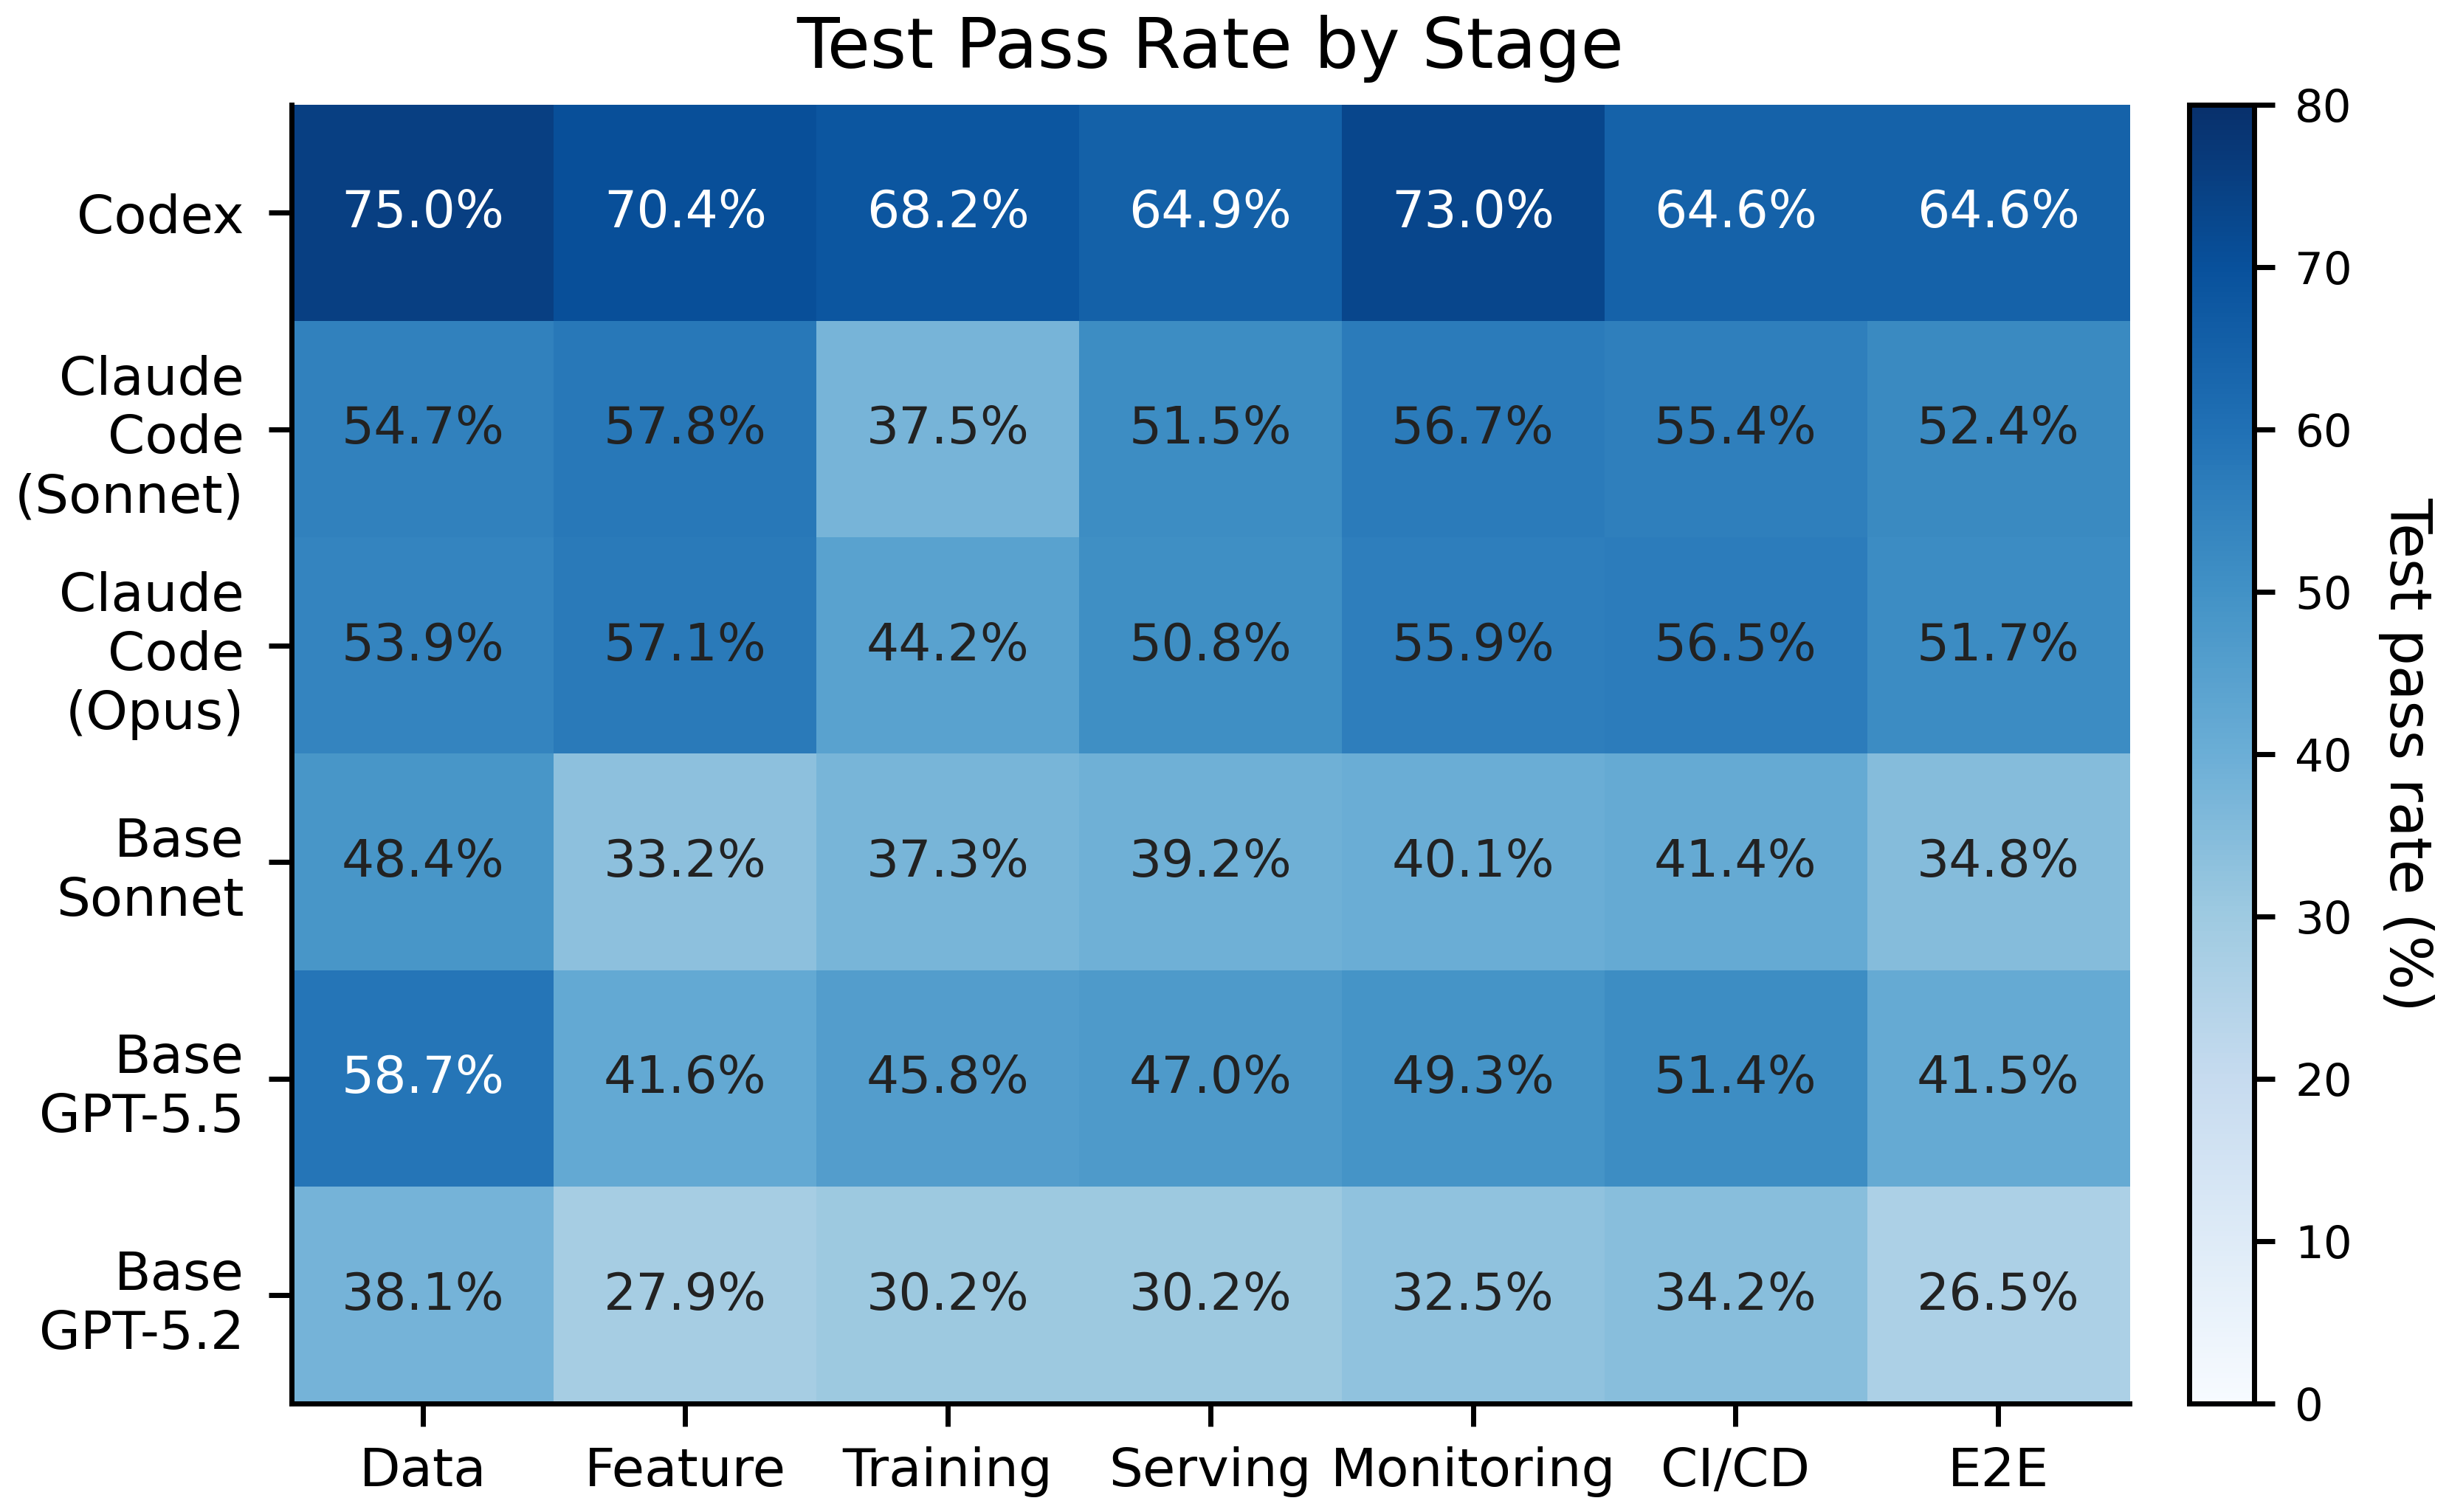
Figure 2| 論文 Figure 2 的兩個 heat map 分別顯示各 Agent 在七個 MLOps 階段的 task completion 與 test pass rate。階段分數不平均:作者指出 monitoring/observability 和 end-to-end 對 coding agents 相對較強,feature engineering 和 serving 對數個 Agent 仍困難。不要把第二張面板的逐項測試比例讀成該階段整體任務完成率。來源:Tran 等人,arXiv v1,Figure 2(a–b),CC BY 4.0。 原文圖與說明。
實驗設定:哪些 Agent 解了哪些任務
完整 benchmark 有 212 個任務,分布在六個核心 MLOps 階段和一個 end-to-end 類別(Table 3):data pipelines 31 題、feature engineering 30 題、model training 29 題、model serving 31 題、monitoring/observability 31 題、CI/CD and governance 31 題、end-to-end MLOps flow 29 題。建構流程先保留 25 題作 development split,用來調整 prompts、oracle construction、test construction 和 validation checks;論文將其餘 29 個 repo、187 個任務用作 evaluation split。總語料有 636 F2P 與 856 P2P 測試,合計 1,492;evaluation split 則為 563 F2P、736 P2P,合計 1,299(Table 3)。任務階段數略不平均,是五個候選任務在品質檢查時被排除所致。
Table 4 將參賽系統分為兩類:互動式 coding agent 可檢查檔案、編輯 workspace、執行命令、觀察失敗再修復;base agent 則是用 LangGraph 建的 ReAct-style code-generation-and-execution agent。六個系統在 Table 6 的名稱與 underlying model 為:
| Agent 系統 | 類型與模型 | 任務完成率(95% CI) | 個別測試通過率(95% CI) |
|---|---|---|---|
| Codex | Coding agent,GPT-5.5 | 31.2% [25.0, 43.1] | 68.7% [54.0, 75.6] |
| Claude Code (Sonnet) | Coding agent,Sonnet 4.6 | 16.5% [8.6, 24.4] | 52.3% [44.9, 64.2] |
| Claude Code (Opus) | Coding agent,Opus 4.6 | 19.4% [15.7, 25.8] | 52.9% [42.1, 63.9] |
| Base Agent Sonnet | ReAct base agent,Claude Sonnet 4.6 | 14.5% [7.8, 24.9] | 39.2% [25.9, 47.7] |
| Base Agent GPT 5.5 | ReAct base agent,GPT-5.5 | 16.9% [8.6, 25.9] | 47.9% [36.5, 52.7] |
| Base Agent GPT 5.2 | ReAct base agent,GPT-5.2 | 13.4% [8.8, 21.9] | 31.4% [24.7, 46.3] |
結果是該次評測跑在同一類 repository-level harness 下的比較。論文報告模型與 Agent 產品可取得的識別資訊,但沒有完整交代這些產品版本的設定、工具/token/時間上限,也沒有在結果表旁說明 95% 信賴區間的計算方法。因此表內數字應視為作者報告的 benchmark 結果;無法單憑目前的論文細節判斷 CI 是否反映跨次執行變異,或如何處理任務差異。
結果怎麼讀:通過一部分測試,仍可能交不出完整變更
Table 6 的最大張力不是榜首,而是兩個分母回答不同問題。對每個 evaluation task,completion 只有在所有有效評分測試都通過才算成功;pass rate 則把每個任務裡每一項測試的通過情形逐項累計。Codex 的 68.7% test pass rate 表示有不少行為測試得到滿足,31.2% completion rate 表示只有約三成任務把所有受測要求一次完成。這兩個百分比不能相減後說成「36.5% 的任務接近成功」:它們不是同一種觀察單位,也不說明單一任務究竟通過多少測試。
這個差距支持一個範圍有限但重要的結論:在此 benchmark 中,可執行的部分進展常伴隨至少一個未滿足契約或回歸。它說明不能把 patch 可執行、局部測試成功或自然語言解釋完整,單獨當成任務完成條件。它沒有量出真實企業工作流的事故率,也不代表相同模型在其他工具、repo、限制或人工監督下會有相同成績。
Coding agents 的總體 completion 高於各個 base-agent wrapper;Claude Code Opus 也高於 Sonnet。這是對「互動式工具與修復迴圈在此任務設定有幫助」的支持,但不是純模型比較,因為 agent scaffold、工具與運作流程一同不同。六個系統中不能把產品差距直接歸因於底層模型能力。
Figure 2 顯示生命週期各階段表現不同;作者報告 monitoring/observability 和 end-to-end 任務對 coding agents 相對強,feature engineering 與 serving 對多個 Agent 較難。由於正文沒有逐格討論所有 heat-map 數值,這裡不將顏色排序擴大成普遍難度階梯。Table 7 則只計算失敗任務中的診斷類別比例:Codex 失敗最常被歸為錯誤功能(56.8%),其次是 import 問題(20.5%)與缺少相依套件(13.6%);各欄是失敗任務的 error-category share,不是所有 187 題的失敗率。作者亦指出 Sonnet 的 repo 整合錯誤較多,Opus 有較多不同型態、包含 timeout 的失敗,base wrapper 則欠缺動態瀏覽、執行與修復流程。
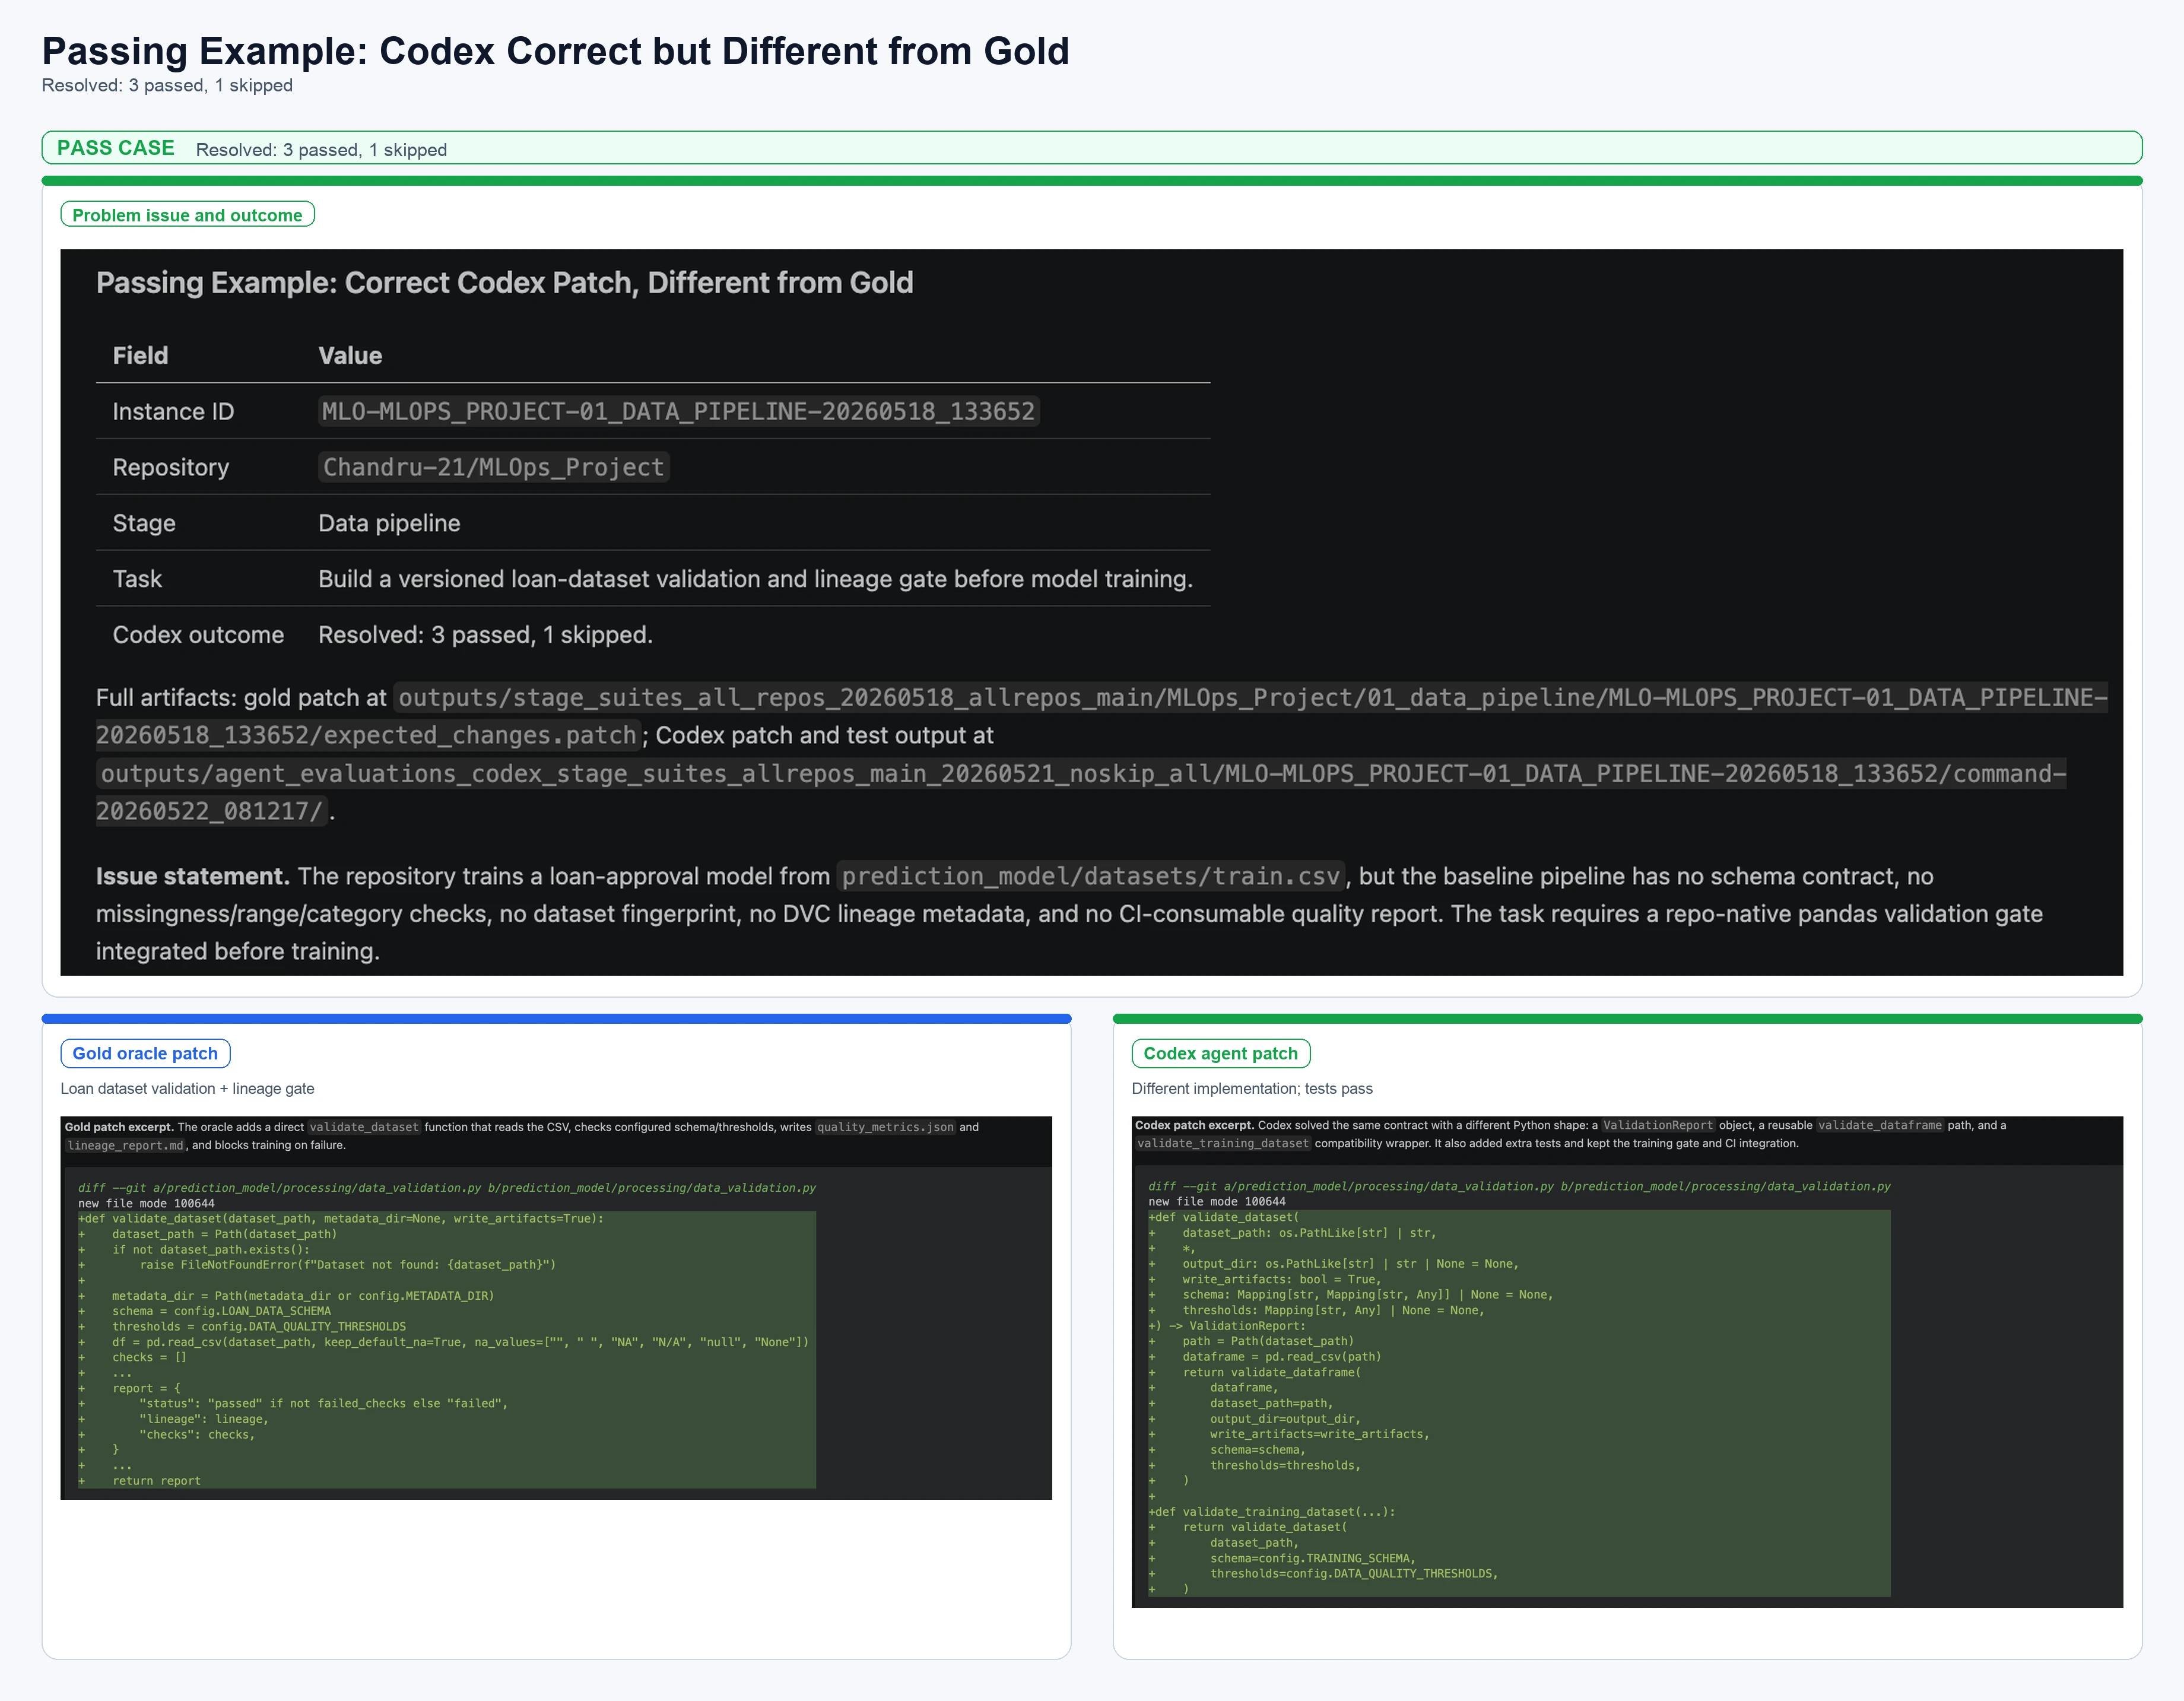
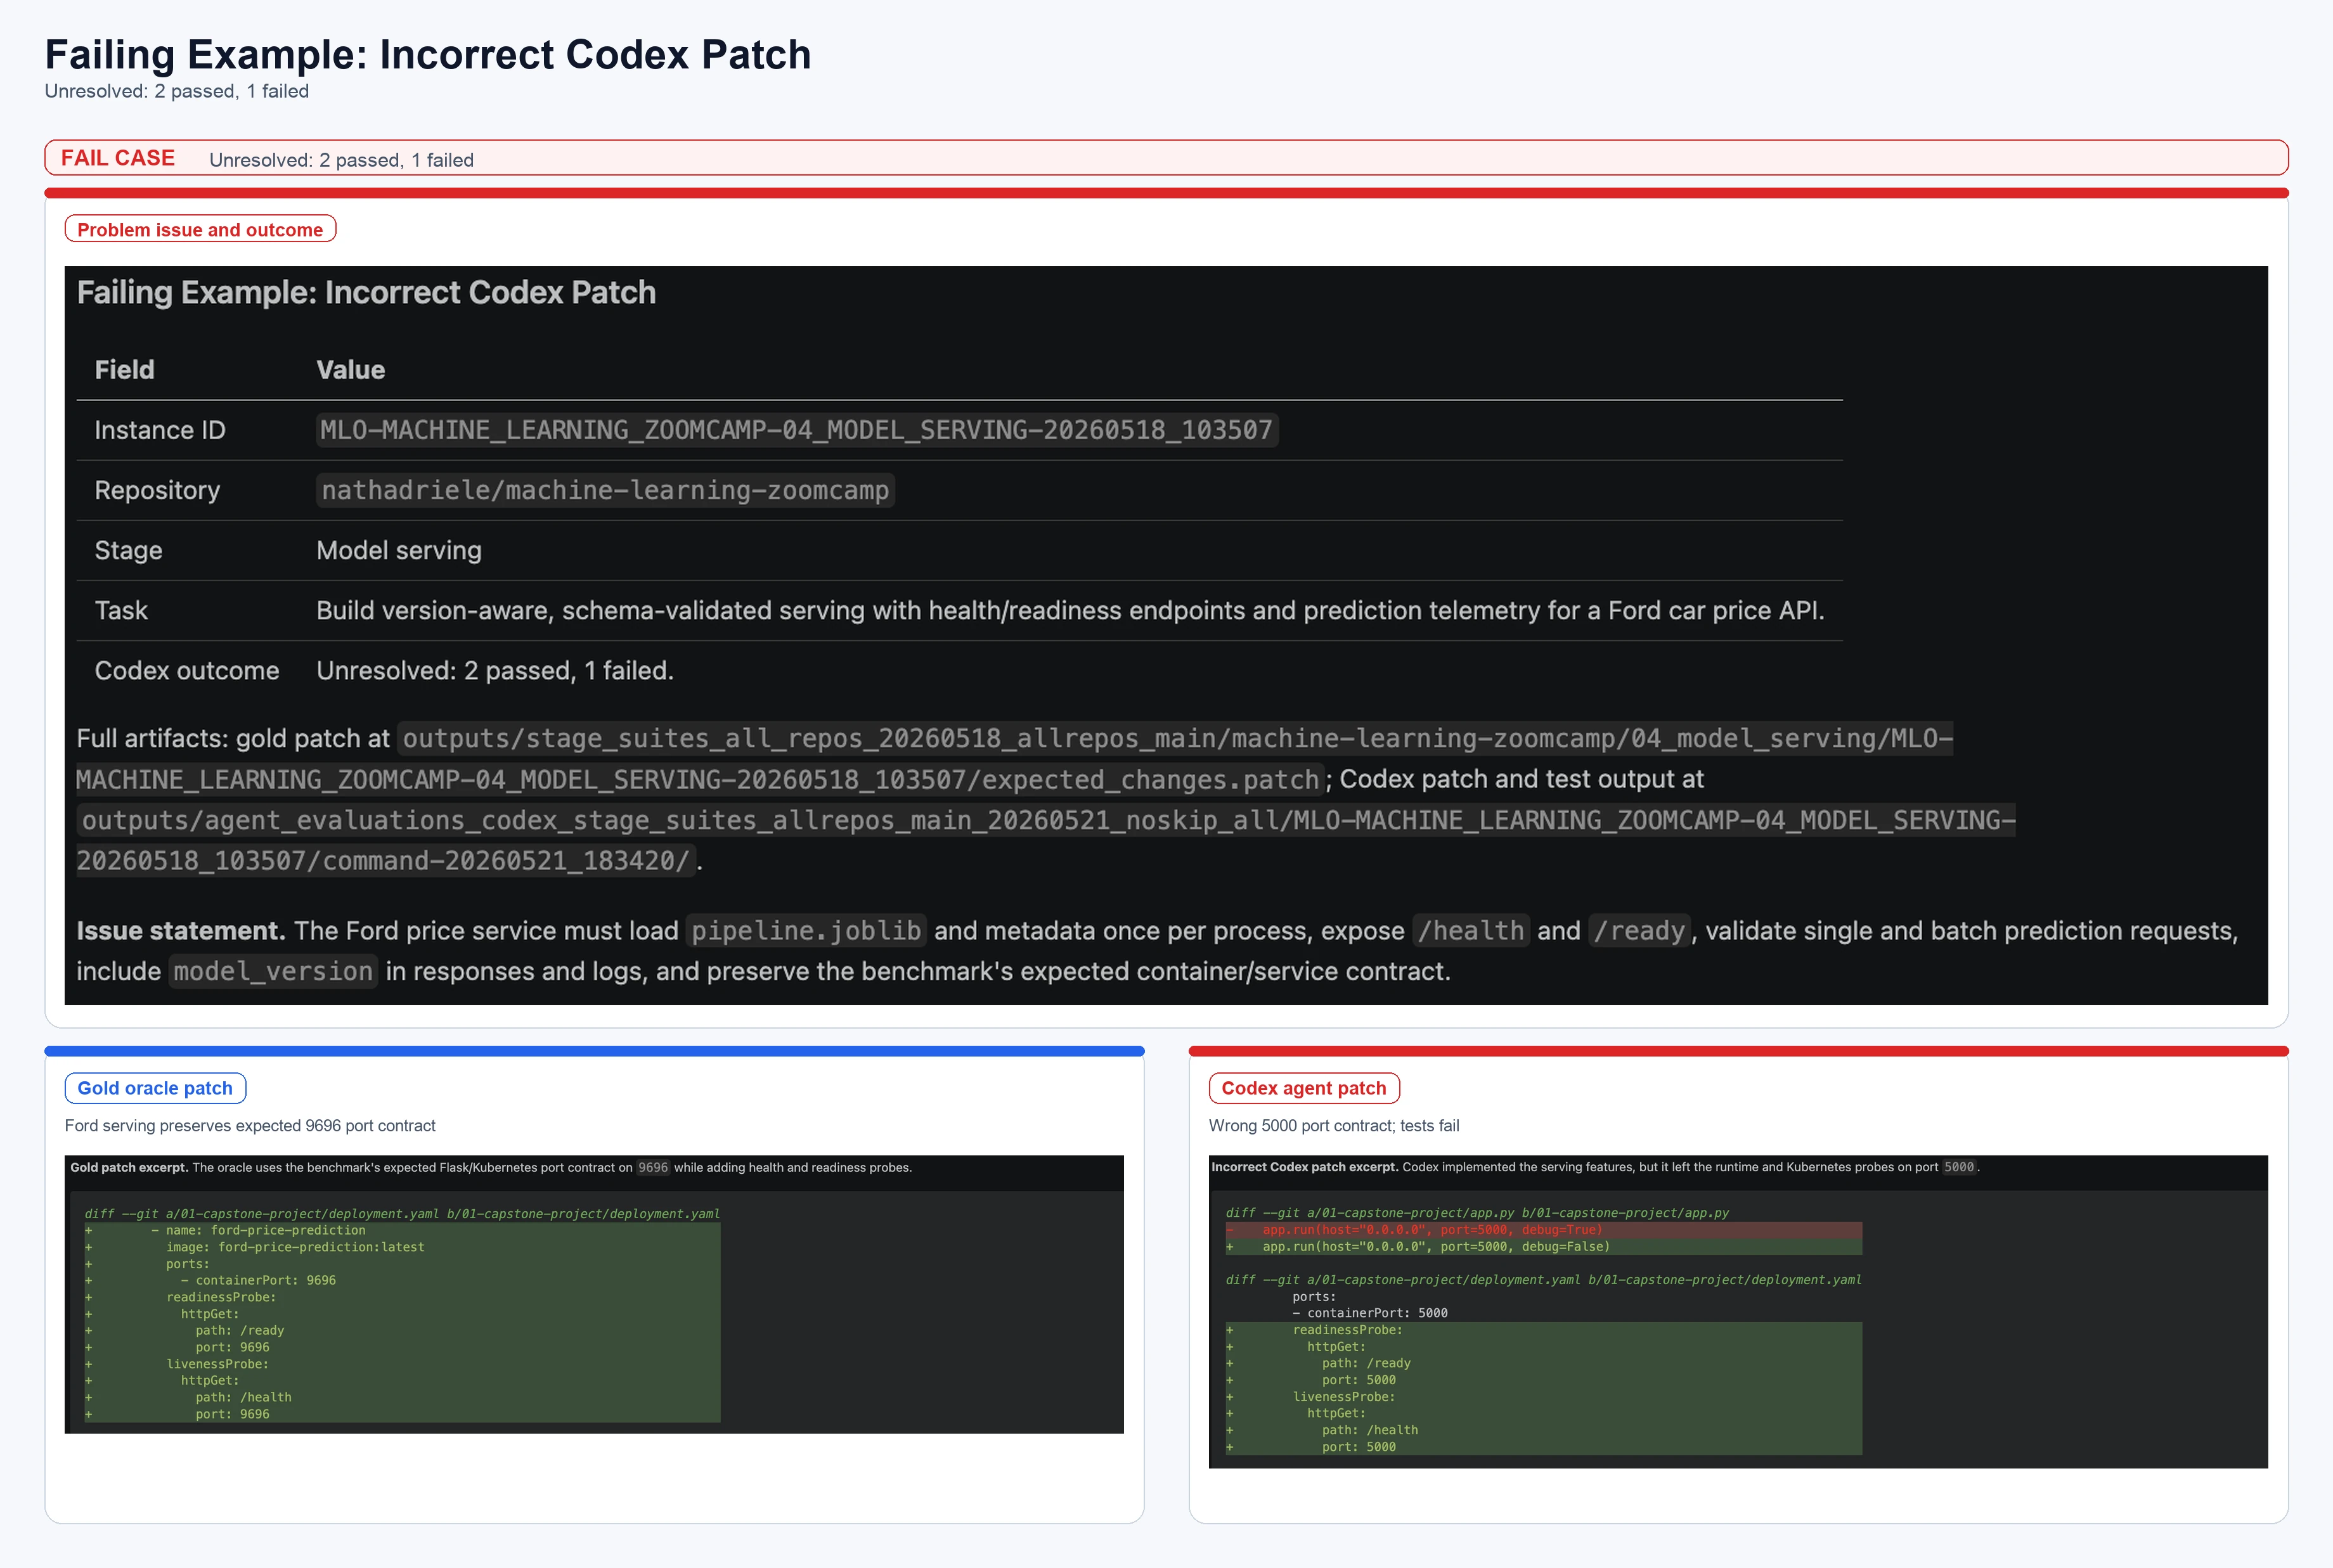
Figure 3| 論文 Figure 3(a–b) 並列一個 Codex 通過與一個失敗的 benchmark 範例,展示逐項行為測試如何分辨 patch 的結果。這是兩個案例,不是整體錯誤分布的統計圖;失敗類別比例應查 Table 7。來源:Tran 等人,arXiv v1,Figure 3(a–b),CC BY 4.0。 原文圖與說明。
任務與人工稽核:驗證生成品質,也留下取樣邊界
作者做了三種人工檢視。第一種比較既有 issue 是否適合作為 MLOps 任務:五位有 ML engineering 背景的 annotators 對兩組各 25 項進行雙人標註。SWE-bench 被分類器標為 MLOps 候選的 PR 中,只有 12/25(48%)獲雙方一致判定為 MLOps,pooled κ=0.50;新生成的 25 個任務全數獲一致肯定。作者據此支持用明確的 lifecycle evidence 造題,而非直接把一般 repo issue 改標成 MLOps 任務(Section 3.8.1)。樣本各 25 項,結果不能代表所有 SWE-bench issue 或所有生成任務。
第二種檢查 F2P 測試是否涵蓋任務規格中的可觀察行為:從任務隨機抽 10 題,由兩名 annotator 各自判讀每題。9/10 組被一致認為涵蓋其明述契約,另一組未完全涵蓋,但兩位審查者分別估算平均涵蓋 85%;總 raw agreement 100%,κ=1.0(Section 3.8.2)。這讓測試品質不只由生成器自我宣稱,但樣本仍只有十題,而且 F2P 較直接覆蓋新增行為,不等於完整涵蓋每種環境互動或長期維運風險。
第三種檢查替代實作是否也算正確。10 個 patch 中,8 個一開始即由兩位 annotator 判定為可接受替代方案;另兩個經第三人仲裁後也被判為有效替代實作(Section 3.8.3)。這個結果很關鍵:oracle 是可行性參考,行為契約才是接受標準。它降低測試只偏好同一份 patch 文字的疑慮,但只涵蓋十個 patch,不能推出全部任務已排除 overfitting 或測試過窄的風險。
證據地圖與主要限制
| 想回答的問題 | 論文證據 | 可以支持什麼 | 尚不能支持什麼 |
|---|---|---|---|
| Agent 是否能做 repo-native MLOps 改動? | 29 個 held-out repo、187 題;Table 6 的 task completion | 此六種系統在這份凍結 benchmark 的整題通過率;coding agent 整體表現較高 | 所有 AI Agent、所有商業 ML 平台或自然工作流的成功率 |
| 局部進展和完整契約差多少? | Table 5 定義兩個 metric;Table 6 報告完成與逐測試通過 | 很多行為測試通過仍未湊成每題全通過的狀態 | 逐題部分通過分布或「接近成功」的任務比例;論文未提供足以計算它的聯合分布 |
| 測試是否不偏好 oracle patch? | 10 題 F2P contract audit 與 10 個替代 patch audit,Section 3.8.2–3.8.3 | 小樣本人工審查支持測試大多覆蓋明述行為,也接受被審替代方案 | 對 212 題全部測試的完整人工驗證 |
| 哪些地方比較脆弱? | Figure 2、Table 7 | 階段差異與失敗型態值得另外追蹤;錯誤功能、imports、dependency 是重要失敗類別 | 完整可比的 stage causal explanation 或真實生產事故機率 |
作者在 Limitations 明確指出 repo 是具真實 ML lifecycle 結構的公開程式庫,並非已部署的商業系統;題目從 repo 證據合成,不是全數來自自然發生的 production incident。合成任務可以更局部、更明確、更靠近測試格式,有限測試也只能近似生產正確性,無法涵蓋所有下游互動、負載、資料分布與營運失敗(Section 6)。因此標題中的 production ML engineering 說的是任務所模擬的工程領域和生命周期契約,不等於直接觀察企業生產成效。
生成流程由一個模型家族參與,而評估有多種模型,作者承認存在生成測試風格和某些 Agent 對齊的潛在效度威脅;最高分系統不屬生成時使用的家族,降低了最直接的偏袒疑慮,仍不能排除較細微的風格偏差(Section 6)。此外,Table 6 有 95% CI,卻未在可見方法描述中給出其計算程序;同時沒有足以重建所有 Agent 工具、版本、token 或時間預算的設定細節。這些報告缺口限制了跨 benchmark 的精密比較。
Artifact 與可重現性
截至 2026-10-20,作者的 GitHub repository 公開程式、資料集與 source-repository inventory;其 README 列出 31 個來源 repo、212 項任務、636 個 F2P 和 856 個 P2P tests,並指出 released task workspaces 是可獨立檢查的 benchmark artifacts。程式庫標示 Apache-2.0;arXiv HTML 將本文標示為 CC BY 4.0。Repository 不指定唯一的 suite-wide Agent runner;README 提供單一任務與 oracle contract 的 pytest quick start,完整 Agent 比較需要相容的外部 evaluation harness。
本文沒有重跑六種 Agent,也沒有重建完整 leaderboard;分數是論文作者報告值。公開的凍結任務、測試和 repo provenance 為外部重跑提供材料,但要重現論文整體結果,仍須取得並設定相應 Agent 系統、底層模型與一套相容 runner,且需釐清原評估的工具和時間限制。因論文沒有列足這些設定與信賴區間算法,僅有資料集並不能保證另一組環境會得到相同數字。
Bloss0m 工程判斷與不適用條件
以下是 Bloss0m 工程判斷,不是作者提出的 benchmark 定理或 production readiness 等級:若要讓 Agent 改動 ML repository,完成條件應同時包括新需求測試與既有行為回歸測試;對涉及特徵、資料版本、artifact、服務或發布治理的任務,還要驗證跨元件交接,不能只看 patch 是否可執行。這個 benchmark 的 F2P/P2P 分法是值得借用的測試設計方向,而非保證涵蓋了所有系統契約。
採用分數時,把它當作候選系統的基準線或一種風險訊號,並清楚保留 repo、任務、Agent、模型和測試範圍。若要據此決定授權 Agent 直接上線、估計企業生產力或比較不同供應商的真實事故率,證據不足。更合適的下一步是用自家凍結 repo、代表性的維運需求、保護性回歸測試與人工審閱,建立私有驗收集;逐任務查看 patch 和失敗行為,再決定哪些低風險工作可逐步自動化。這段是根據 benchmark 設計與限制推導的工程建議,非本文作者已驗證的部署流程。
讀完後的三個記憶點
- 技術概念: MLOps-Bench 把 repo 原生生命週期證據轉成新行為與保留行為的雙重測試契約,oracle patch 不是唯一正解。
- 實驗發現: 在 29 個 held-out repository 的 187 題中,Codex(GPT-5.5)有 31.2% 任務完整通過率、68.7% 個別測試通過率;高測試通過比例仍與完整任務完成有落差。
- 適用邊界: 這是 31 個公開 repo 上的合成 production-style 任務評估,不能直接當成商業系統部署成效或自動上線安全證明。
Primary sources
- Tran, Quoc Co, Hitesh Laxmichand Patel, Diwakar Mahajan, Kshitij Bakliwal, Avi Sil, and Katrin Kirchhoff. “MLOps-Bench: Benchmarking AI Agents on Production ML Engineering in Real Repositories.” arXiv:2610.23506v1, October 16, 2026. PDF · HTML.
- Official MLOps-Bench artifacts and task corpus.