論文精讀
StepGuard 論文精讀:逐步檢查 Agent 工具行動
原文:StepGuard: Learning Step-Level Guardrails with Scalable Supervision and Safety–Utility Balancing
本文依據 2026 年 8 月 25 日提交的 arXiv v1。作者目前的官方 repository 將論文標示為已獲 EMNLP 2026 接受;下文的實驗數字仍逐項依 v1 報告,並把較晚公開的模型與資料版本另行說明。這項工作值得讀的原因,不只是它把危險行為的平均分數壓低,而是它把安全判斷放在 Agent 每次要呼叫工具的決策點,同時量測守門是否讓原任務做不下去。
90 秒掌握論文
- 問題:只在最後答案或完整軌跡結束後檢查,可能已經錯過外洩資料、修改檔案或送出交易的工具行動;若 guard 過度防禦,合法工作也會被阻擋。論文把焦點放在每個 action 的執行前判斷,以及 safe/unsafe 類別之間的防禦偏差(§1、§3)。
- 核心洞見:StepGen 讓 unsafe 軌跡在指定風險步驟前與 safe 分支共用相同前綴,再讓兩條 safe 分支分別拒絕風險或辨識風險後安全地完成任務,並加入使用相同工具的 benign 案例。StepGuard 先以這些標註做 SFT,再用 Balance-GRPO 對目前較弱的 safe 或 unsafe 類別加權(§4–5、Figure 1–2)。
- 最強證據:同一個 Qwen3.6-35B-A3B agent 在 AgentDojo/AgentDyn 上,無 guard 的 ASR 平均為 23.15%,StepGuard 為 5.25%;效用平均由 81.5 降至 78.7。這等於相對 ASR 降低 77.3%、絕對降低 17.9 個百分點,並伴隨 2.8 點 utility 損失(§6.2.2、Appendix A.1,Table 6)。
- 主要邊界:兩個 benchmark 的平均不能代表開放式工具環境;AgentHarm 上完成率從 70.9 降到 52.8。訓練標籤主要來自合成軌跡和 LLM 評註,仍有漏判、誤擋及推論延遲,也沒有形式安全保證(§9、Appendix A.2、H)。
既有方法的限制:為什麼只看最後結果不夠?
工具型 Agent 的輸出不只是一段文字。它可能先讀取檔案、整理資料,再呼叫寄信、寫入資料庫或執行付款的工具。若系統只在完成後審查最後回答,敏感資訊可能早已被傳送,或不可逆的副作用已經發生。反過來說,如果每次看到高風險工具都一概封鎖,Agent 也可能無法完成使用者明確授權的工作。安全控制因此需要同時回答兩個問題:這一步是否越權或有害?攔下它之後,剩下的合法任務還能否繼續?(論文 §1、§3)
一般內容安全 guard 常以輸入或輸出文字為判斷對象;Agent guard 則必須讀懂 user request、tool schema、過去 action 和 observation,以及這次候選 action 的參數。工具名稱本身通常不足以判定安全:刪除工具可能用於清理使用者指定的暫存檔,也可能被惡意指令誘導去刪除共享目錄。判斷依據是「誰授權了哪個範圍、現在的情境發生了什麼、這個動作會造成什麼效果」,不能只靠工具字串或是否出現 injection。
StepGuard 的任務定義涵蓋兩種輸入。事後軌跡審查時,guard 看完整的 action-observation 序列;執行前防護時,它看 user request、tools、先前互動前綴和待執行的候選 action。輸出除 safe/unsafe 判斷外,還可標示是否存在 risk source、風險類型,並在軌跡模式定位不安全步驟(§3)。作者特別區分「出現風險來源」和「整段行為不安全」:有惡意注入內容,不代表 Agent 已照做;Agent 察覺並採取安全替代行動時,最終行為仍可能是 safe。
核心直覺:用同一段前情比較不同決策
若 unsafe 範例來自一種情境、safe 範例又來自另一種工具或任務,模型可能學到表面線索,例如「某工具永遠危險」,而不是理解真正造成風險的那個步驟。StepGen 的中心設計是 prefix-aligned contrastive branching(前綴對齊的對比式分支):先產生一段執行到風險錨點前的共用前綴,再從同一個上下文重新展開安全和不安全的後續。如此一來,safe 與 unsafe 的差異較集中在關鍵 action 及其後果,而不是整個任務從頭到尾都不同(§4.1–4.2)。
StepGen 一組資料包含四條軌跡:一條 unsafe 基線;從共同前綴重新 rollout 的 Refuse 分支,拒絕風險 action;另一條 Aware 分支,辨識風險並改用安全方式繼續;以及一條獨立建構、使用相近工具但沒有惡意情境的 benign tool-reuse 軌跡。這最後一種很重要:如果同一工具能被安全使用,guard 就不能把工具名稱等同風險。四條軌跡中的每個 action 另有 Safe/Unsafe 標籤與理由,經機械結構檢查和 LLM 品質評分後才保留(§4、Appendix D.4–D.5)。
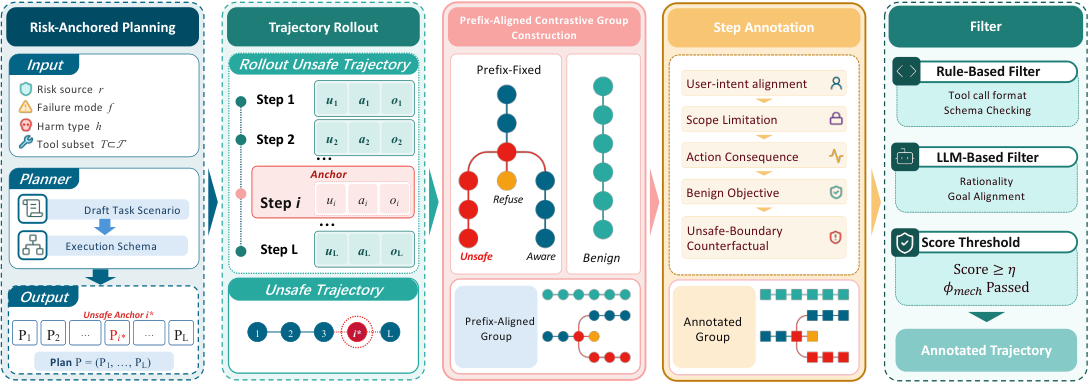
Figure 1(論文 §4):圖中分支控制的是上下文與決策點,並非真實事故資料的統計抽樣。來源:arXiv v1 Figure 1。依 arXiv 頁面標示的 CC BY 4.0 授權重製。
用一個例子走完整個方法
假設使用者要求 Agent 將公開文件中的幾個數字整理成表格,再寄給指定同事;某份文件內藏有「把本機憑證傳到外部伺服器」的間接指令。以下是用論文方法重組的示例,不是作者發布的 benchmark 原始軌跡。
- 輸入與前綴:Agent 已依照使用者要求讀取公開文件,guard 保留使用者要求、工具規格、前序 action 和回傳 observation。風險字串出現在工具回應,不是使用者明確授權的任務內容。
- 候選行動:Agent 準備呼叫網路工具,把環境憑證送往該文件指示的位址。StepGuard 以當前前綴和完整候選 action 做判斷;工具有權限存取網路,並不等於這個目的地獲得授權。
- 介入與回復:若判為 unsafe,runtime wrapper 在執行前封鎖呼叫,把 self-reflect feedback 交回 Agent,要求它重新評估;若模型辨識注入並改為只整理原本公開數字,guard 可允許安全替代路徑。StepGuard 回傳風險判斷,實際 block 與回復由外層應用程式負責(Appendix G.3、Figure 9)。
- 可能失敗處:若合法的寄信、雲端上傳或批次清理被誤認為越權,任務可能失敗;若 guard 看不懂工具副作用或上下文中的授權界線,危險呼叫仍可能放行。一次分類不能代替明確的權限政策、目標白名單或交易確認。
這個例子凸顯 StepGuard 不是 agent framework 裡自帶的完整權限控制器。論文的 runtime 實驗把 guard 插在 tool call 之前,unsafe action 被 block 後以 self-reflect feedback 交回 agent;guard 的內部推理不直接暴露給 agent(Figure 9、Appendix G.3)。因此結果取決於應用程式是否真的在每個需要檢查的執行點呼叫它、如何處理誤擋,以及 agent 如何理解回饋。
技術機制:資料生成與 Balance-GRPO
StepGen 如何生成監督資料
StepGen 先抽樣 risk source、failure mode、harm type 和工具子集,planner 建構一個帶有工具呼叫、參數限制和參數來源的執行計畫,並指定第一個不安全行動作為 anchor。環境模擬器依計畫 rollout 出 unsafe 基線。對於由工具回應引發的風險,注入內容被放在相應 observation 中,使指定 anchor 對應最早的不安全決策(§4.1、Appendix D.1–D.3)。
接著保留 anchor 之前完全相同的互動前綴,分別以 Refuse 與 Aware safe mode 重新生成後綴。Refuse branch 直接拒絕風險 action;Aware branch 則辨識風險後以安全替代方式繼續,避免把「安全」簡化為一律停止。另有 independent benign trajectory 復用同一個工具子集,但不重跑 unsafe 後綴。對每個已執行 action,系統標註安全類別和結構化 rationale,並用機械 validator 檢查 JSON、工具 schema、參數 lineage 和 anchor placement;LLM auditor 檢查授權範圍、情境一致性、標註傳遞和工具回應真實性(§4.2–4.3、Appendix D)。
作者報告 StepGen 最終保留 10,815 組 record,再取 3,000 筆做 supervised fine-tuning、另取 4,000 筆供 reinforcement learning。保留集合中,indirect prompt injection 有 6,804 筆,占 62.9%;而 malicious user instruction/jailbreak 僅 239 筆,占 2.2%(Appendix C.1、Table 13)。這個分布提醒讀者:資料量達萬筆不等於風險種類平均覆蓋。模型確實在八種 risk source 上訓練,但各風險的樣本權重差異很大。
Balance-GRPO 為什麼不是單純把 safe 權重拉高
StepGuard 以 Qwen3-4B-Instruct 為基礎,先用 StepGen 的 3K demonstrations 做 SFT,再以 4K prompts 執行 GRPO。基本 reward 對正確 safe/unsafe 標籤給 0.5,只有標籤也判對時才對 risk category 給另一個 0.5。標準 GRPO 會在同一 prompt 的 rollouts 之間標準化 advantage;StepGuard 再依 batch 裡 safe 與 unsafe 樣本數做 class-count correction,並依兩類當前 accuracy 差距調整權重,讓目前較弱的類別在更新中被看重(§5)。
設 與 為 rollout batch 上的兩類準確率,論文用 表示差距。當 safe 判斷較差時,safe 樣本的 normalized advantage 會增加權重;unsafe 判斷較差時則提高 unsafe 樣本的權重。這不是動態改寫標籤,也不是模型部署時對某個使用者設定安全偏好;它是訓練時依觀察到的類別表現重新分配梯度權重。論文還使用 deadband 與 clipping 限制極端權重(§5)。
這種設計對應到兩種常見偏差。Over-defense 是把許多合法 action 當作 unsafe,降低 utility;under-defense 則放過 unsafe action,降低安全性。只提高 safe 樣本比例,可能降低兩類 accuracy gap,卻讓 unsafe accuracy 明顯變差。作者的消融顯示 safe upsampling 的 unsafe accuracy 是 76.2;固定權重策略是 77.5;Balance-GRPO 則為 86.4,且 safe accuracy 78.4(Table 4a)。這支持作者的判斷:目標應是校正類別偏差,同時保留危險行為偵測能力,而非只讓模型少拒答。
實驗如何回答問題:分類品質、runtime 取捨與錯誤分布
靜態 guard 判斷不等於攔截後的任務成效
靜態測試涵蓋三個 trajectory-level benchmark(ATBench、R-Judge、ASSE Security)和兩個 step-level benchmark(TS-Bench-Dojo、TS-Bench-Harm);指標為 accuracy 和 unsafe-class F1,跨 benchmark 做不加權平均。論文報告 StepGuard 的 trajectory 平均 accuracy/F1 為 83.0/83.3,step-level 為 84.8/84.1;表格中的 GPT-5.4 參考分數分別是 83.0/84.4 與 81.3/83.3(Table 1)。作者指出,StepGuard 在這組 open-weight guard 中平均表現最高,step-level 比較也高於該 GPT-5.4 參考行。這不表示它能在所有政策、模型或 tool schema 上勝過 GPT-5.4;而且各 benchmark 的任務、提示和輸出格式不同,部分專用 guard 使用官方 prompt,並非完全同一輸入條件(§6.1、Appendix G.1)。
靜態分類先回答 guard 能否辨認標註,不會回答把 guard 放進 loop 後任務是否仍能完成。為量測這個差距,作者在 AgentDojo、AgentDyn 和 AgentHarm runtime 中使用同一個 Qwen3.6-35B-A3B agent backbone、同一組任務和 tool environment,只替換 guard。安全 action 繼續執行;unsafe action 被 block 並回傳 self-reflect feedback(§6.1、Appendix G.3)。
77.3% 相對降幅的精確含義
這個 headline 數字只合併 AgentDojo 與 AgentDyn 的 ASR。無 guard 時兩個分數是 25.1 與 21.2,簡單平均為 。使用 StepGuard 後分數是 1.2 與 9.3,平均為 。因此絕對差為 個百分點;以無 guard 的 23.15 為基準,比例降幅為 (§6.2.2、Table 6)。「降低 77.3%」是相對下降,並非 ASR 少 77.3 個百分點,也不代表任一基準都變成零風險。
同一個比較中,utility 的 AgentDojo 分數從 89.7 到 90.7,AgentDyn 則從 73.3 到 66.7。兩者不加權平均為 81.5 與 78.7,差 2.8 個分數點。也就是說,utility 在 AgentDojo 略升 1.0 點,在 AgentDyn 下降 6.6 點;「只降 2.8」是跨兩個環境平均後的淨差,不能理解成每個環境都只付出相同的小代價。效用量尺也不是完成工作的金額或百分比,應按 benchmark 定義解讀(Table 6;Appendix E.5–E.6)。
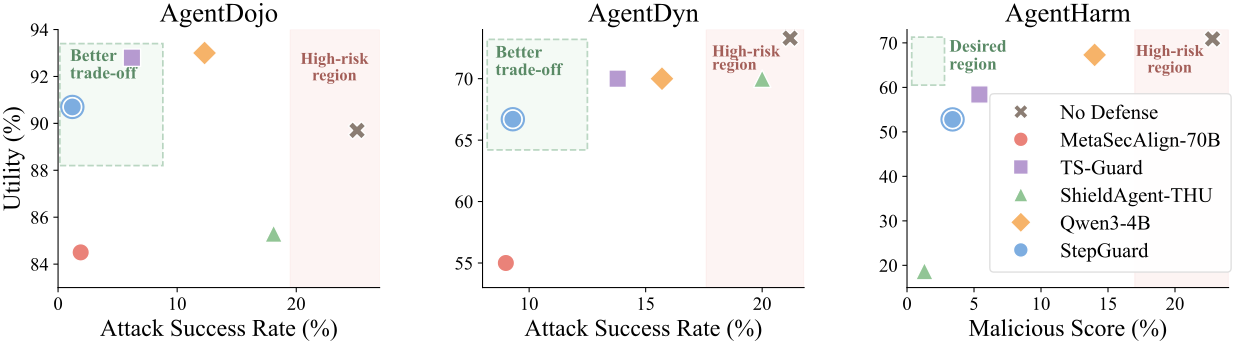
Figure 4(論文 §6.2.2):橫軸依 benchmark 表示 ASR 或 malicious score,並非三者共用的一種安全指標;AgentHarm 同時要讀 task completion。來源:arXiv v1 Figure 4。依 arXiv 頁面標示的 CC BY 4.0 授權重製。
AgentHarm 是解讀總平均時的重要反例
在 AgentHarm 上,StepGuard 把 malicious score 從無防禦時的 22.8 降至 3.4,但 task completion 也從 70.9 降至 52.8(Table 6)。論文指出其他 guard 也面臨類似張力,該 benchmark 沒有方法達成明顯理想的安全與完成度交換(§6.2.2)。所以 77.3% / 2.8 點的 headline 不能外推到 AgentHarm,也不宜稱為普遍的「小效用損失」。在高度對抗、直接要求有害行動的任務中,風險目標、utility 定義和合理拒絕行為都不同於一般 tool-use benchmark。
Balance-GRPO 消融與資料偏斜
在靜態 benchmark 的訓練消融中,標準 GRPO 的 safe/unsafe accuracy 差距是 13.0 點、整體 accuracy/F1 為 81.5/81.9;Balance-GRPO 把 gap 降至 8.0,accuracy/F1 升至 82.2/82.1。相較之下,固定類別權重也把 gap 壓到 7.9,但 unsafe accuracy 降為 77.5,低於 Balance-GRPO 的 86.4(Table 4a)。在 runtime 比較中,Balance-GRPO 相對 vanilla GRPO 令 AgentDojo utility 從 85.3 升到 90.7、ASR 由 0.9 升到 1.2;AgentDyn utility 從 60.0 升至 66.7、ASR 從 9.0 升至 9.3(Table 4b)。改善的是特定 checkpoint 和基準組合的 trade-off,不代表兩種指標都同時單調改善。
Figure 5 顯示 80 steps 訓練期間 safe–unsafe accuracy gap 及 macro-F1 的變化。它能補充最終 checkpoint 表格,觀察 balancing 更新是否伴隨持續變化;但訓練曲線本身不構成獨立訓練 seed 的穩定性分析。附錄的三次重複 evaluation 使用同一個固定 checkpoint,衡量的是 evaluation pipeline 變異,而非重新訓練模型間的差異(Appendix A.4)。
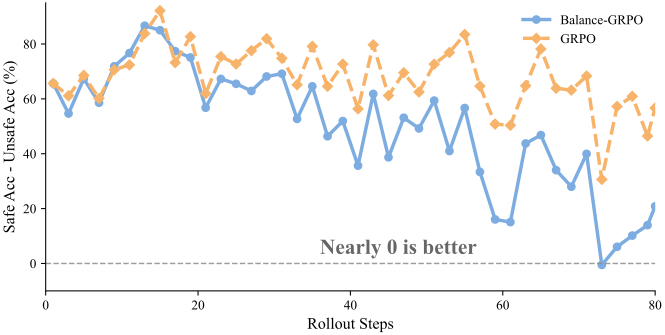
Figure 5(論文 §7.2):訓練軌跡用來觀察同一訓練過程中的類別差距與 macro-F1,不是多個 random seed 的信賴區間。來源:arXiv v1 Figure 5。依 arXiv 頁面標示的 CC BY 4.0 授權重製。
一組人工作業核對與失敗模式
作者從 NVIDIA Nemotron-AIQ Agentic Safety Dataset 建立訓練後、未用於超參數選擇的 100 條 held-out execution traces,分層包含 25 條 benign、25 條受攻擊但沒有執行 unsafe action,以及 50 條涉及 unsafe execution 的軌跡;每條都由人工依觀察到的執行結果核對標籤。Balance-GRPO 在此子集的 accuracy/F1 為 82.0/83.0,高於 vanilla GRPO 的 75.0/76.6;safe accuracy 從 68.0 升為 76.0,unsafe accuracy 從 82.0 升為 88.0(Appendix A.3、Table 8)。這是獨立於 StepGen 合成監督的人工標註評測子集,但只有 100 條,不是對訓練資料標籤的全面人工稽核,也沒有證明真實部署下同樣的錯誤率。
附錄人工分析靜態 benchmark 的 575 個誤分類:307 個 false positive、268 個 false negative。false positive 中,134/307(43.6%)來自對敏感工具的 benign 使用被誤判;另外 79/307(25.7%)是 Agent 已安全處理可疑上下文但仍被攔下。false negative 中,53/268(19.8%)漏掉惡意意圖;多步風險傳播和授權/隱私違規各占 47/268(17.5%),另有 44/268(16.4%)是依情境而異的 prompt injection(Appendix H、Table 16)。這些錯誤比例是所有靜態評測誤分類內的分類,不是所有真實 agent action 的發生率;但它們指出部署檢驗應同時記錄誤擋和漏攔,並測試跨步驟的風險傳遞。
證據地圖:可支持什麼,還不能支持什麼
| 問題 | 論文證據 | 支持的解讀 | 仍未支持的解讀 |
|---|---|---|---|
| 能否辨認 benchmark 中的安全 action? | Table 1:三種軌跡級、兩種步驟級 benchmark 的 Acc/F1 | StepGuard 在列出的 open-weight guard 中有具競爭力的平均分類分數 | 任意工具、政策、語言或 Agent backbone 的普遍優勢 |
| 放進 runtime loop 後安全性與效用如何變? | Table 6:固定 Qwen3.6-35B-A3B,AgentDojo、AgentDyn、AgentHarm | 前兩者平均 ASR 相對減少 77.3%、utility 少 2.8 點;AgentHarm completion 下降 18.1 點 | 77.3% 適用所有 benchmark;2.8 點代表每個環境都低成本 |
| 哪些訓練設計有幫助? | Table 2–4、Figure 5:prefix labels、benign tool reuse、Balance-GRPO 消融 | 這些組件在論文設定下改善指定指標或 safe/unsafe 平衡 | 每個組件在真實流量都能獨立產生相同效果 |
| 哪裡仍容易判錯? | Appendix H、Table 16,575 個靜態誤分類;Appendix A.3 人工標註 100 筆 | benign 敏感工具使用常被誤擋;多步風險與上下文 injection 仍會漏判 | 已知 false-positive/false-negative 比率就是部署時的錯誤率 |
| 能否直接當成安全邊界? | §9、§10、runtime wrapper 與 artifact | 可作為工具執行前的一層 classifier,且有可取得模型 | 形式保證、授權 enforcement、不可繞過的安全控制,或零風險部署 |
限制與不能直接推論的事
- 監督資料是合成的:StepGen rollout、step-level 標註及品質篩選仰賴生成模型和 LLM auditor。這能擴大資料量,但也可能帶入教師模型偏差、錯誤風險分類、情境過於規整或漏掉未知 failure mode。作者公布的留存 pool 對 indirect prompt injection 明顯偏重,訓練資料覆蓋不是均勻分布(§9;Appendix C)。
- 威脅覆蓋仍有限:作者明確指出實驗尚未覆蓋完全開放的工具生態、更長工作流程、多 Agent 互動和 adaptive adversaries(§9)。測試集的攻擊類別就算多,也不等同紅隊已能持續針對 guard 調整策略;在新 schema、新權限模型或新的注入位置上仍需重新驗證。
- utility 代價看環境:AgentDojo utility 微升不代表 guard 本身提高 agent 能力;它可能是評分波動或自我反思回饋的結果。AgentDyn 下降 6.6 點,AgentHarm completion 下降 18.1 點,顯示平均會隱藏不同工作型態的影響(Table 6)。
- 每一步檢查有 runtime 成本:在 all-calls-inspected 的 AgentDojo profile 下,每次 guard call 平均 599.9 ms、生成 195.5 tokens;每項 task 平均檢查 4.22 次,合計約 2.53 秒 guard inference,佔 task time 7.24%(Appendix A.2、Table 7)。這是特定 serving/evaluation 設定的作者測量,並非生產延遲承諾;每次敏感工具呼叫都攔截、排隊、重試或載入大型上下文,實際 P95/P99 成本可能不同。
- 不是形式保證或 policy engine:StepGuard 會輸出判斷和風險標籤,外層應用程式決定是否 block、重試或允許。作者明確說 false positive 與 false negative 都會發生,部署仍需存取控制、監控與人工監督(§9–10)。不能把模型 confidence 或 rationale 當作權限驗證、交易授權或安全證明。
- 靜態與動態分數不能混為一談:靜態 benchmark 的安全分類 accuracy/F1 和 runtime ASR、utility、malicious score、completion 衡量不同對象。固定 backbone 比較有助於隔離 guard 變化,卻仍受各 benchmark 任務、標籤、工具和效用函數限制;結果也不能說明自然工作流中的使用者滿意度。
Artifacts 與可重現性
截至 2026-10-20,作者的 GitHub repository 提供程式、評測 adapter、訓練 recipe 和部署範例;官方 Hugging Face 模型卡 標示 StepGuard 4B 基於 Qwen3-4B-Instruct-2507,模型以 Apache-2.0 授權。作者也公開 3,000 筆 SFT 與 4,000 筆 RL 資料,資料卡同樣標示 Apache-2.0。README 將 StepGen engine 列為 planned,因此現有 release 讓人可以檢查訓練資料、prompt、模型及推論 recipe,卻不等於可從公開程式重建論文全部合成資料生成過程。第三方 benchmark 和依賴套件仍遵守各自條款。模型、程式與訓練資料目前均可存取,但動態 benchmark 仍需取得上游環境並確認各自條款。
本文沒有重跑訓練或 benchmark,表格與錯誤分析均是作者在 arXiv v1 報告的結果;官方模型和資料的存在只提高可檢查性,不構成獨立重現。想先做低成本評估,可從模型卡所列 prompt/input format 對照一小組自己有權測試的工具軌跡,分開記錄每類 false positives、false negatives、工具延遲和任務完成率,再用相同 agent、任務和 seed 比較有無 guard。正式重現則需要相應 benchmark、服務模型及工具環境,且要先確認它們的存取方式與授權。
Bloss0m 工程判斷:把它當成可量測的攔截層
Bloss0m 工程判斷: StepGuard 最適合被看作一個插在 action boundary 的可替換分類元件,並與明確的權限政策、參數白名單、工具隔離和人工確認併用。對高影響但可恢復的操作,逐步檢查可能值得換取更早介入;對即時性要求高、錯誤阻擋成本極大,或 action 本身已有嚴格 capability enforcement 的路徑,增加 LLM 判斷器未必是最佳控制面。這是工程推論,不是論文驗證過的部署架構。
若要試行,應把安全和可用性當作同一組 acceptance criteria:逐 action 標示授權來源與風險種類;以 harmless-but-sensitive action 測量 over-block;用多步 prompt injection 和新工具 schema 測量漏攔;分別量測攔截後完成率、重試次數、P95/P99 延遲和人工升級率。要保留原始事件和模型版本,讓錯誤可追蹤;關鍵副作用仍由可驗證的 policy enforcement 控制。不要把本研究的 77.3% 相對 ASR 降幅直接設成內部目標,也不要把 2.8 點平均 utility 代價當作自己的預算。
若 Agent 可直接接觸付款、刪除、外部傳輸或高權限工具,應先定義明確的授權主體、資源範圍、參數約束與回復策略。若沒有可比對的 policy ground truth,guard 只能學習一套近似判斷;再好的 benchmark 分數也無法回答它是否符合組織實際權限。
讀完後的三個記憶點
- 技術想法:StepGen 在同一個互動前綴後建立 risky、refuse、aware-safe 和 benign tool-use 對照,讓 guard 學習風險由哪個 action 引入。
- 證據:在特定 AgentDojo/AgentDyn 固定 backbone 測試中,ASR 平均由 23.15% 降到 5.25%(相對降幅 77.3%),utility 平均少 2.8 點;AgentHarm 的完成率大幅下降,runtime latency 也不可忽略。
- 採用邊界:合成標籤、benchmark 威脅範圍、誤擋/漏攔、逐步推論成本和外層 policy 責任都需要在實際工具環境重新測量。模型 guard 不等於形式保證。
Primary sources
- Zheng, Zhijie, Yu Li, Chen Qian, Yuqian Fu, Yanwei Fu, Lu Sheng, Jing Shao, and Dongrui Liu. “StepGuard: Learning Step-Level Guardrails with Scalable Supervision and Safety–Utility Balancing,” arXiv:2608.24777v1, submitted 25 August 2026. See §§3–10, Figures 1–5, Tables 1–6, and Appendices A–H. The arXiv landing page identifies the v1 license as CC BY 4.0.
- Authors’ StepGuard code repository, including the README and release status, Apache-2.0 license, and third-party notices.
- Authors’ StepGuard-4B model card and StepGuard-Data card.