本文讀的是 Self Improvement via Fast Tree-search 的 arXiv v1。論文於 2026-09-17 提交,作者來自 MIT 與 Sakana AI;本文核對了 arXiv HTML/PDF 的 Sections 1–5、Tables 1–7、Figures 1–9、Appendix A–B 與安全討論。論文標示 CC BY 4.0,文中的圖是原論文圖表的本地鏡像,來源與定位連結記在每個圖說中。
這篇 paper 真正要解的不是「Agent 能不能修改自己的程式」,而是更容易被忽略的下一個問題:當 self-improvement 已經產生數十甚至數百個候選 patch,哪一些值得先花昂貴的 benchmark 成本去驗證? SIFT 的答案是,把廉價的相對偏好排序放在候選生成與完整評測之間,讓搜尋可以先前進,驗證則延後給較有希望的節點。
90 秒掌握論文
- 問題:recursive self-improvement 的每個候選 agent 都要重新跑下游任務,評測成本和 wall-clock time 很快超過 patch 生成本身。
- 核心方法:新 patch 先和少數強 incumbent 做 pairwise LLM judging;所有勝負放進正則化 Bradley–Terry model,轉成節點的 judge rank。
- 搜尋策略:parent sampling 同時使用 judge rank、subset accuracy rank 與 visit-count exploration;evaluation queue 也按潛力排序,讓 expansion 與 full evaluation 非同步進行。
- 主要結果:Polyglot-225 上,Qwen3-Coder-30B/Qwen3-480B judge 為 31.1%,o3-mini/gpt-5.4 judge 為 35.1%;TerminalBench 2.1 的 judge-selected agent 在三次 full evaluation 平均 36.7%,起始 agent 為 29.2%。
- 主要邊界:judge 是 noisy ranking oracle,不是 benchmark 的替代品;沒有公開實作的情況下,CPU、API cost 與模型版本仍難以由外部研究者獨立重現。
核心工程判斷:SIFT 最有價值的貢獻是重新分配「搜尋」與「證明」的資源,而不是宣稱 LLM judge 比實際執行更可靠。它把 self-improvement 變成 speculative ranking → selective verification 的系統問題;但只要最後選擇仍依賴完整 benchmark,任何 judge rank 都必須被視為暫時的路標。
既有方法為什麼不夠:每個 patch 都等 full benchmark
在 DGM、HGM 或 SICA 一類的 self-improvement loop 中,self-improver 讀取目前 agent 的程式與失敗紀錄,產生一個 child agent;child 再被放進 downstream benchmark,結果回到下一輪。這條路徑很直觀,但它有一個排程瓶頸:下一個值得探索的 parent,往往要等前一批候選完整跑完才知道。
最便宜的替代方案是只跑 benchmark subset,但 subset score 很 noisy,且一次任務執行仍可能比一次 pairwise judge 久很多。SIFT 不把這兩種訊號混成一個分數,而是問兩個不同問題:
| 訊號 | 它回答什麼 | 不該被解讀成什麼 |
|---|---|---|
| subset accuracy | 候選在固定小集合上實際做得如何? | 完整 benchmark 的可靠排名 |
| pairwise judge/BT rank | 從程式與工具實作看,哪個候選比較有希望? | 真實下游行為已被證明 |
| full benchmark | 在完整任務上最後表現如何? | 可以免費套用到其他模型與任務 |
這個分層是整篇 paper 最重要的閱讀入口:SIFT 的 judge 不是「自動評測器」,而是一個用來決定搜尋方向的 cheap signal。
核心直覺:把 self-improvement 拆成排序與驗證
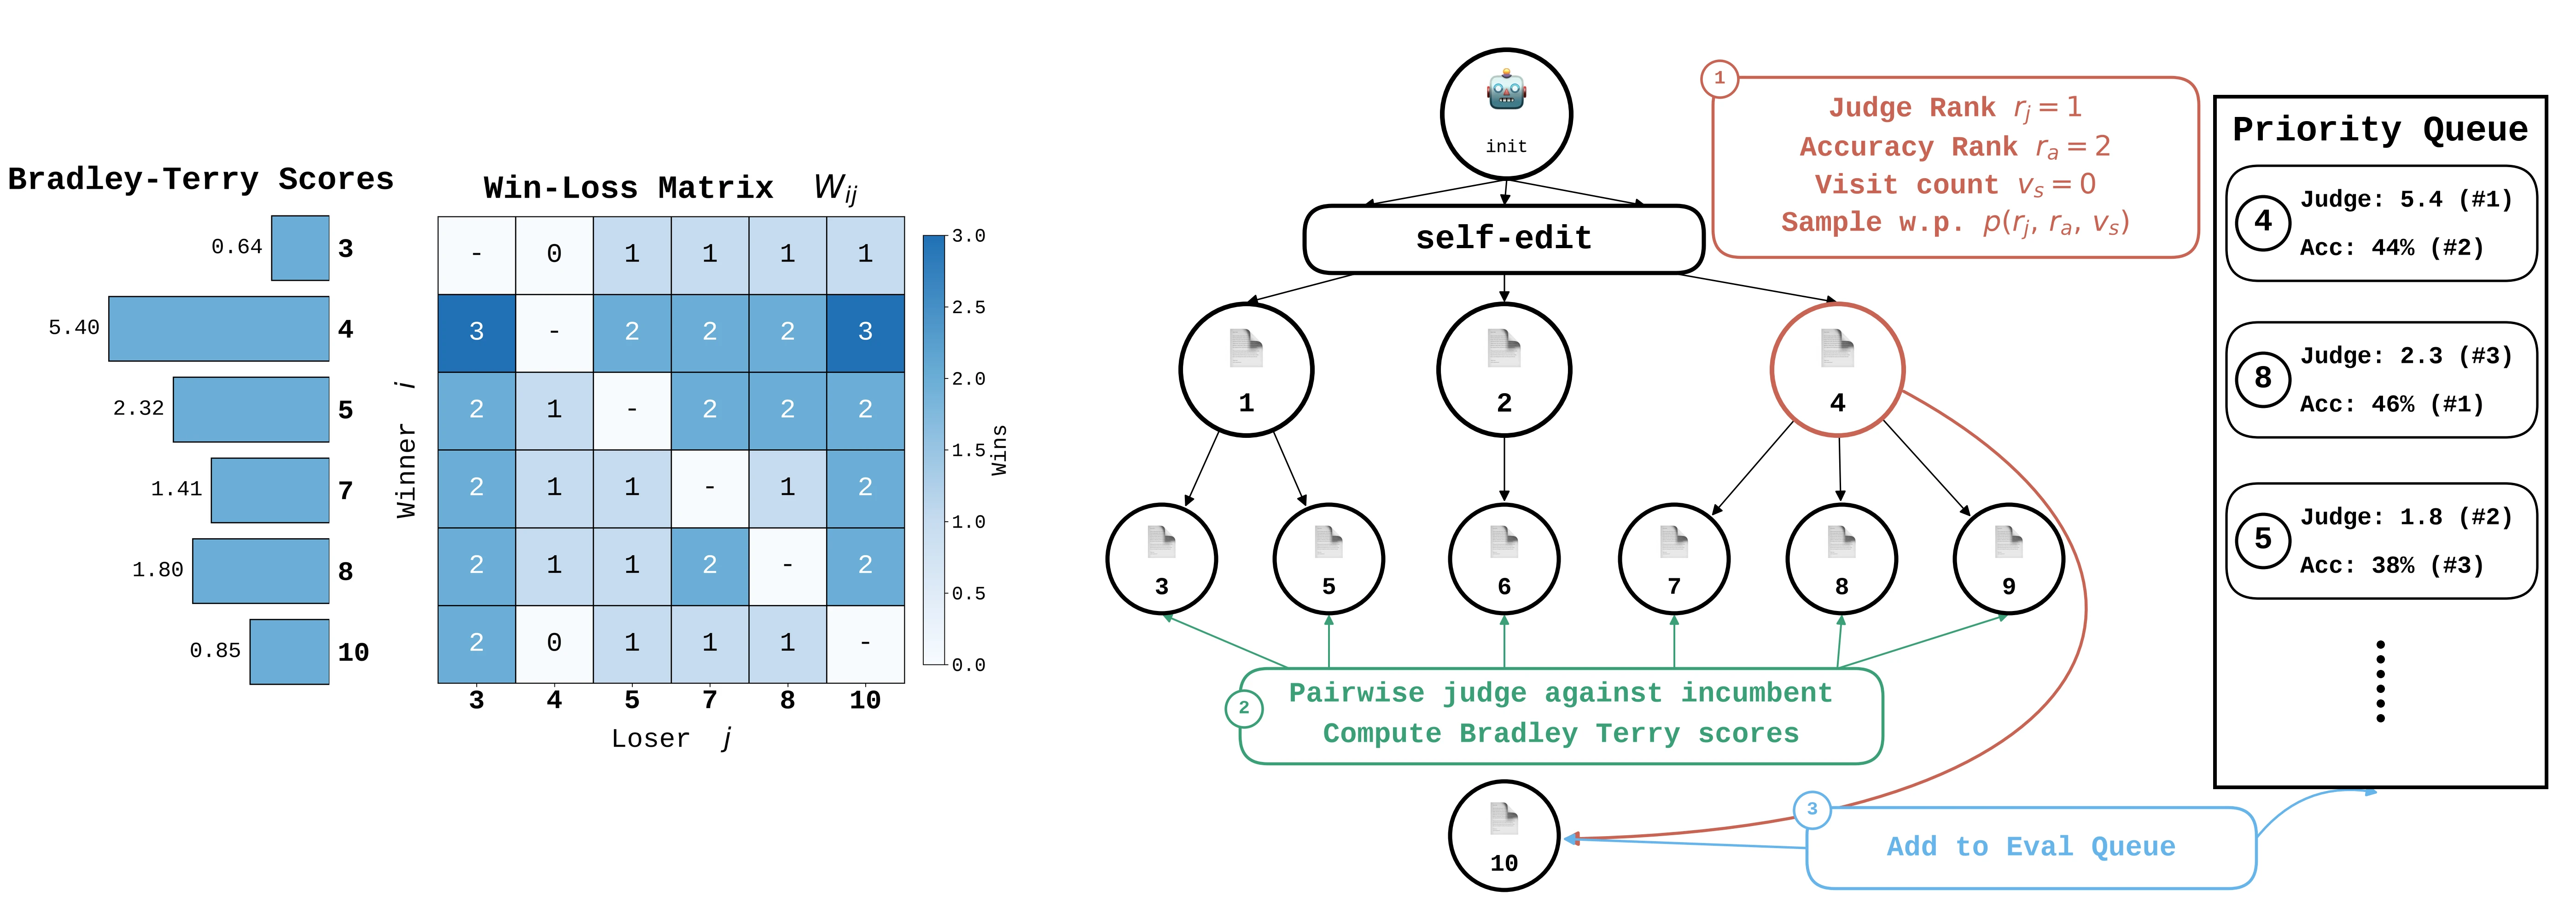
圖 1(原論文 Figure 1,Section 3):左側是 pairwise win-loss matrix 與 BT strength,中央是候選 agent tree,右側是依 judge/accuracy rank 排序的 priority queue。原始圖檔:arXiv Figure 1 · Section 3 anchor。arXiv 頁面標示 CC BY 4.0;本文保留原圖與來源,重用時請遵守原授權。

用白話表示,SIFT 的 loop 是:
current agent harness
        ↓ self-improve
candidate patch
        ├─ pairwise judge → win/loss matrix → BT rank
        ├─ easy subset → early rejection or temporary accuracy
        └─ priority queue → full benchmark when resources are available
判斷候選的便宜訊號和真正的下游驗證被明確分開。候選可以在 full evaluation 還沒結束時繼續產生下一代,但最後仍要靠 benchmark 決定是否真的改善。
用一個候選節點走完整個方法
假設目前 archive 裡有 root、node 3、node 4 等 agent harness,一個 self-improver 產生 node 10。它不是直接跑 225 個 Polyglot tasks,而是依下面的順序進入 SIFT:
- 產生 patch:self-improvement model 修改允許的 runtime 檔案,形成新的 child agent;sandbox 與 writable-file allow-list 先阻止它改 benchmark 或 evaluation harness。
- 通過 easy gate:候選先跑固定的小 subset。若 patch 明顯壞掉,就不值得投入更多搜尋資源;若還在等待完整評測,先沿用 parent 的 accuracy 作暫時排序。
- 選 comparison targets:新候選只和 archive 中看起來強的前 10 個節點比較,而不是和所有節點做全連接 pairwise comparison。
- 形成偏好紀錄:judge 看兩份 candidate runtime files,回傳誰比較可能改善 agent。每一次偏好變成
W_ij的一筆勝負紀錄。 - 更新 BT rank:把稀疏而可能不一致的 pairwise 結果一起 fit 成每個 node 的 latent strength,再只使用它的 rank,不把數值當成絕對品質分數。
- 排 parent 與 eval queue:高 judge rank、高 subset accuracy、低 visit count 的節點更容易被選為下一個 parent;高潛力節點進入 full evaluation priority queue。
- 最後驗證:完整 benchmark、重跑與跨 coding model transfer 才能判斷這個 patch 是否真的值得採用。
這個 walkthrough 也指出一個容易誤讀的地方:一個節點可以因 judge rank 很高而提前被探索,但不代表它已經被驗證為最佳節點。
方法細節:Bradley–Terry 排名在這裡做什麼
對每個 agent node i,論文假設它有一個看不見的 strength θ_i。如果 judge 比較 i 與 j,則偏好 i 的機率寫成:
P(i preferred to j) = θ_i / (θ_i + θ_j)累積的勝負矩陣 W_ij 不會直接當作最後排名,而是透過 regularized BT fit 把稀疏比較整合成一組 strength。regularizer 對新節點很重要,因為新節點只被比較幾次,若完全照 raw win count,很容易把「比較太少」誤認成「真的很強」。
SIFT 接著把 BT rank r_b(i)、subset accuracy rank r_a(i) 與被選為 parent 的次數 v_i 放入 parent sampling:
P(i) ∝ exp(-α r_b(i) - β r_a(i) - η log(1 + v_i))α、β 控制 judge 與實測 subset 的影響,η 用來抑制一條 lineage 被反覆開發。論文的預設是三者皆為 1;當 η=0 時,o3-mini configuration 的 Polyglot 結果從 35.1% 降到 30.1%,說明 exploration term 不是裝飾,而是搜尋能否離開局部最優的一部分。
非同步 pipeline:讓 expansion 不必等 evaluator
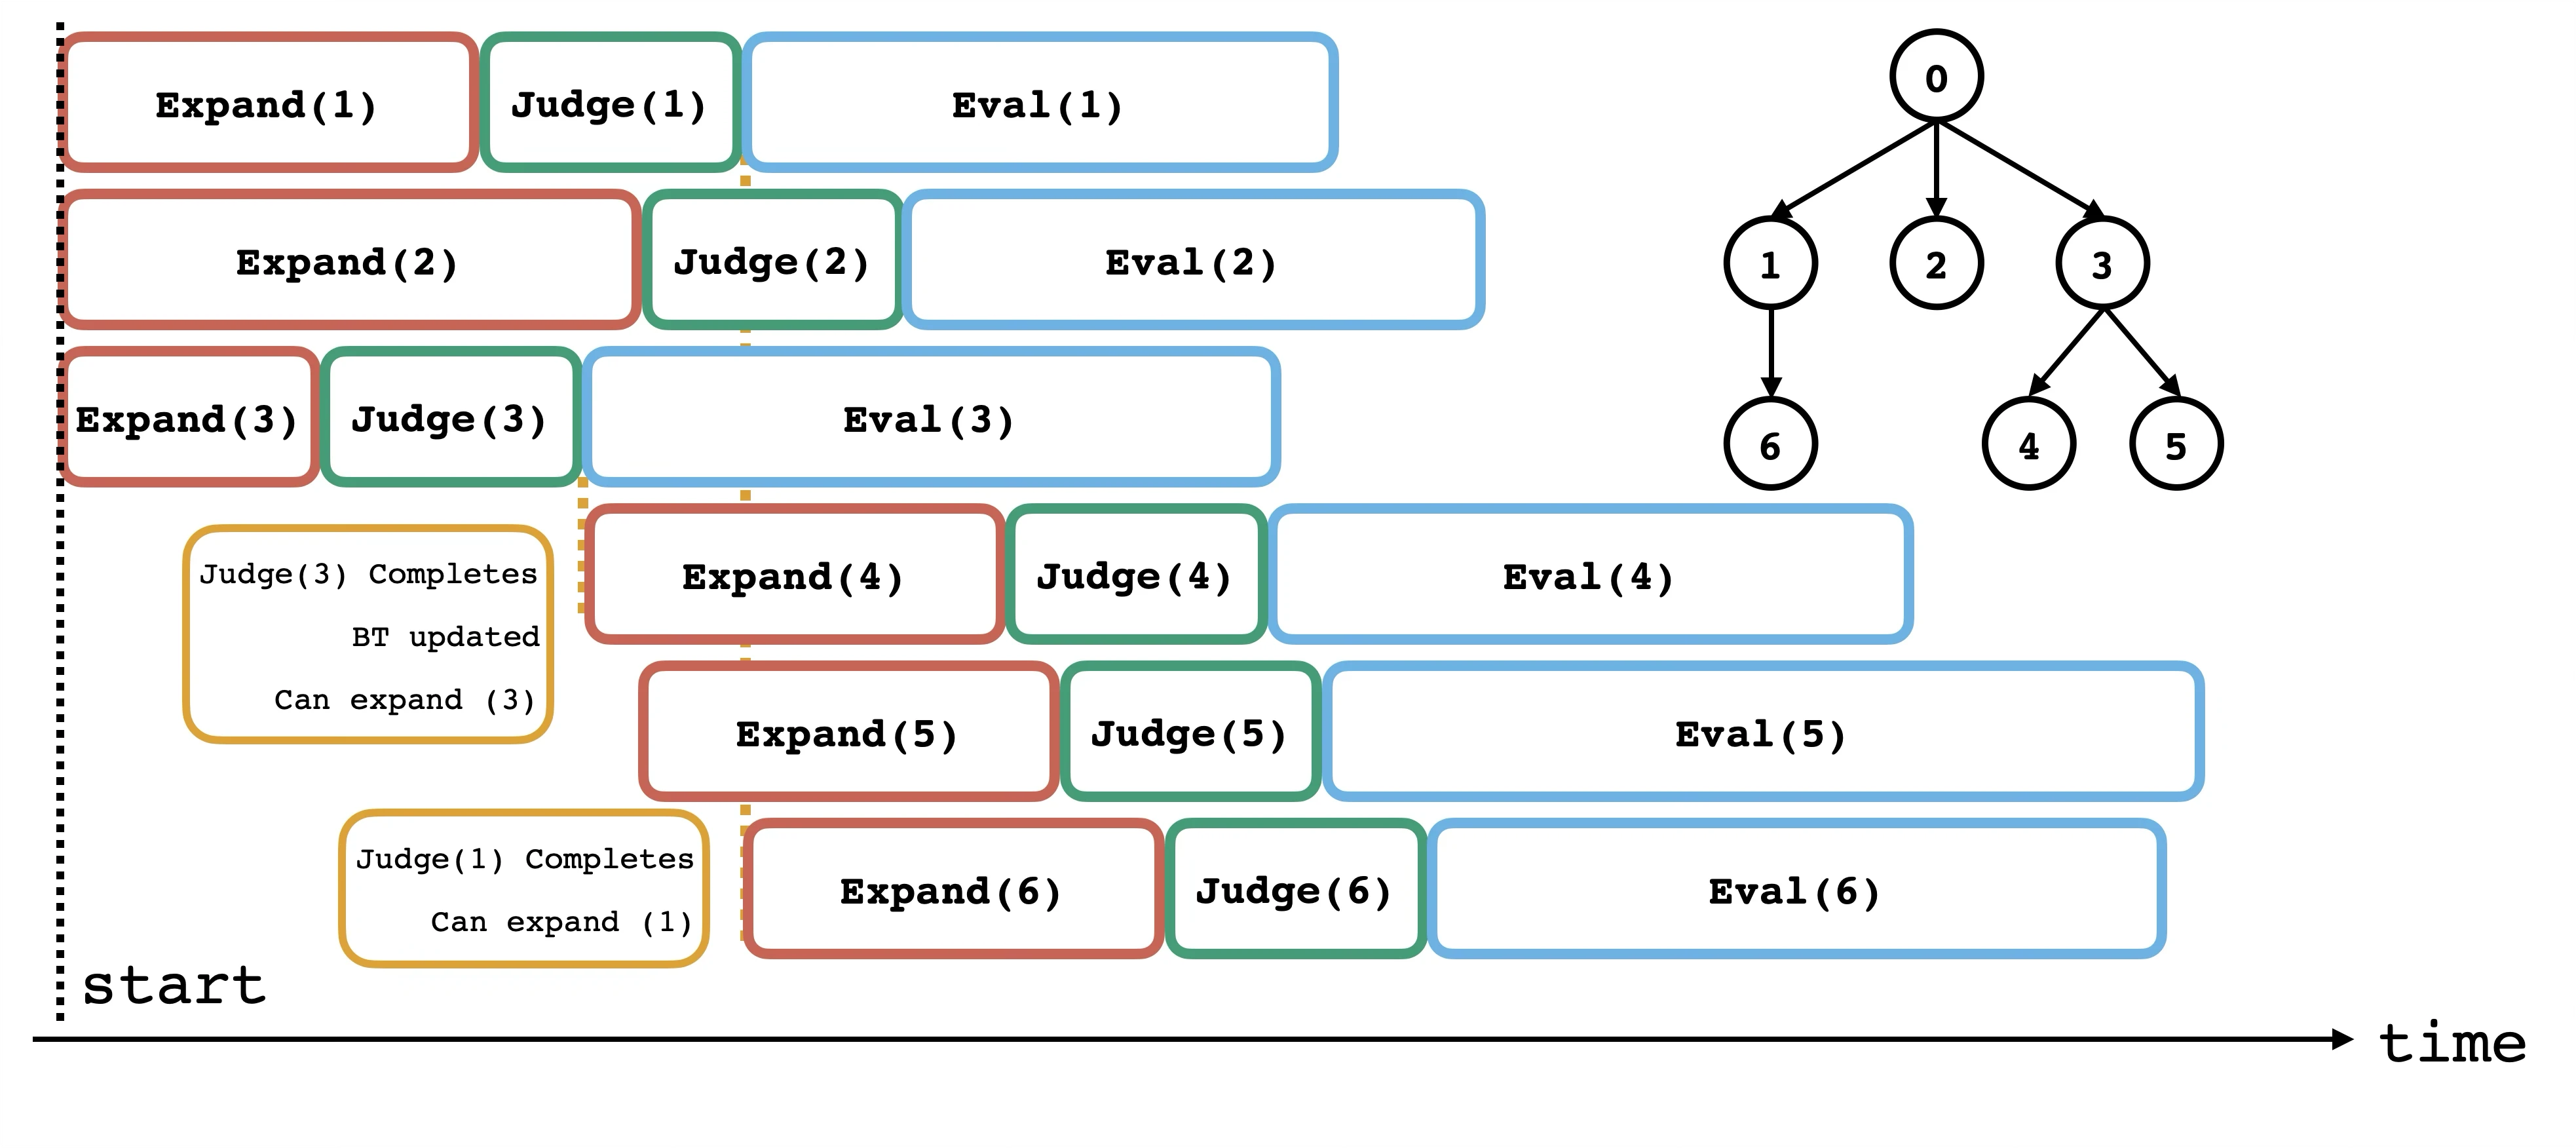
圖 2(原論文 Figure 2,Section 3):SIFT 將 expansion、judge 與 downstream evaluator 拆成可以並行的工作流;強 judge signal 可以讓未完成 full evaluation 的節點先被擴展。原始圖檔:arXiv Figure 2 · Section 3 anchor。圖表為原文 CC BY 4.0 資產,本文只做本地鏡像。

在 blocking pipeline 裡,搜尋大概是:產生 patch → 跑 benchmark → 等結果 → 再產生下一個 patch。SIFT 的 orchestrator 讓三條工作線可以交錯:
- expansion worker 持續從 archive 選 parent 並產生 child;
- judge worker 立即比較 child 與 frontier nodes,更新 BT rank;
- evaluator worker 依 priority queue 取得候選,跑 subset 或 full benchmark。
論文把這稱為 fully disaggregated pipeline,但不要把它解讀成「不再需要 benchmark」。它的 gain 來自等待時間與資源利用率改善,以及 judge 能讓尚未完成評測的節點先被探索。
成本模型:便宜訊號不是免費訊號
論文在 default K=10 時估算一個候選最多做 10 次 pairwise judge。Table 1 的單步平均成本如下:
| 模組 | 模型 | API cost | CPU time |
|---|---|---|---|
| Self-improve expansion | gpt-5-mini | $0.12 | 0.186 h |
| 一次 pairwise judge | gpt-5.4 | $0.044 | 0.0042 h |
| Polyglot-50 full eval | o3-mini | $6.00 | 2.6 h |
這個對比說明 SIFT 的直覺:如果一次候選先用少量 judge calls 排序,再把 full eval 留給較有希望的節點,搜尋就能更快知道該把資源放在哪裡。但總成本仍取決於 expansion 次數、judge model、full evaluation 數量與失敗重跑;不能用一次 comparison 的 $0.044 推算整個研究 run 的成本。
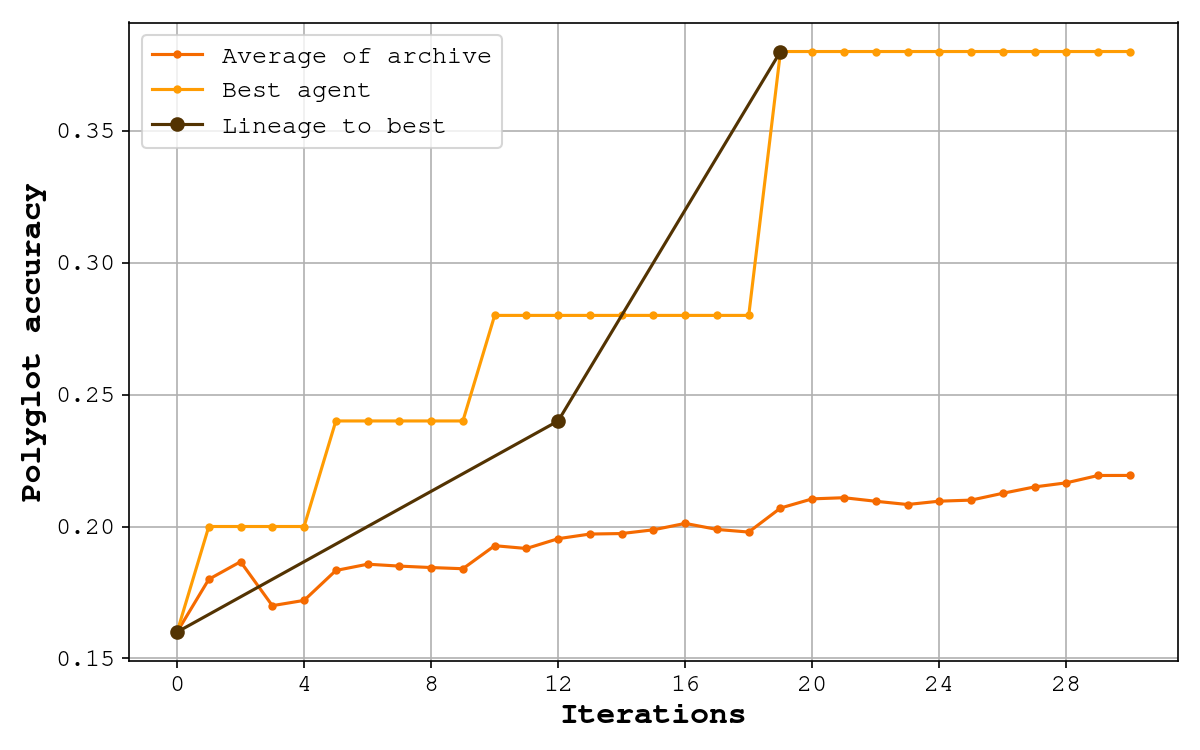
圖 3(原論文 Figure 3,Section 4):Qwen3-Coder-30B configuration 在 30 次 evolution steps 中,Polyglot-50 的搜尋表現與 archive 平均逐步上升;最佳 descendant 的 full Polyglot-225 結果是 31.1%,而不是圖中每個中間點都已完成 full evaluation。原始圖檔:arXiv Figure 3 · Section 4 anchor。圖表為原文 CC BY 4.0,保留原始 attribution。

實驗一:Polyglot 的結果與成本要一起讀
Polyglot full benchmark 有 225 個 tasks,涵蓋 C++、Go、Rust、Java、JavaScript 與 Python。搜尋時先用 4-task gate,再用固定的 Polyglot-50 subset;225-task full benchmark 留作最後驗證。這個設計讓不同 node 有相同的中間比較基準,也避免只因抽到容易任務就獲得虛高分。
Accuracy
| Method | Coding model | Judge | Polyglot-225 |
|---|---|---|---|
| Base agent | Qwen3-Coder-30B | — | 20.0% |
| SICA | Qwen3-Coder-30B | — | 25.1% |
| DGM | Qwen3-Coder-30B | — | 27.1% |
| HGM | Qwen3-Coder-30B | — | 30.5% |
| SIFT | Qwen3-Coder-30B | Qwen3-Coder-480B | 31.1% |
| SIFT | Qwen3-Coder-30B | gpt-5.4 | 32.0% |
| Base agent | o3-mini | — | 14.2% |
| DGM | o3-mini | — | 30.7% |
| SIFT | o3-mini | gpt-5.4 | 35.1% |
| SIFT | o3-mini | gpt-5-mini | 31.6% |
一組 Qwen SIFT run 在 30 steps 後達 31.1%,使用 $34.3 API cost、224 CPU-hours、6.7 小時 wall-clock;o3-mini/gpt-5.4 的 configuration 為 35.1%,同一表格列出的 run cost 是 $86.8、59 CPU-hours、2.1 小時。這些數字支持「在該實驗設定下更有效率」,不支持「任何 self-improving agent 都能用這個成本達到相同分數」。
Transferability
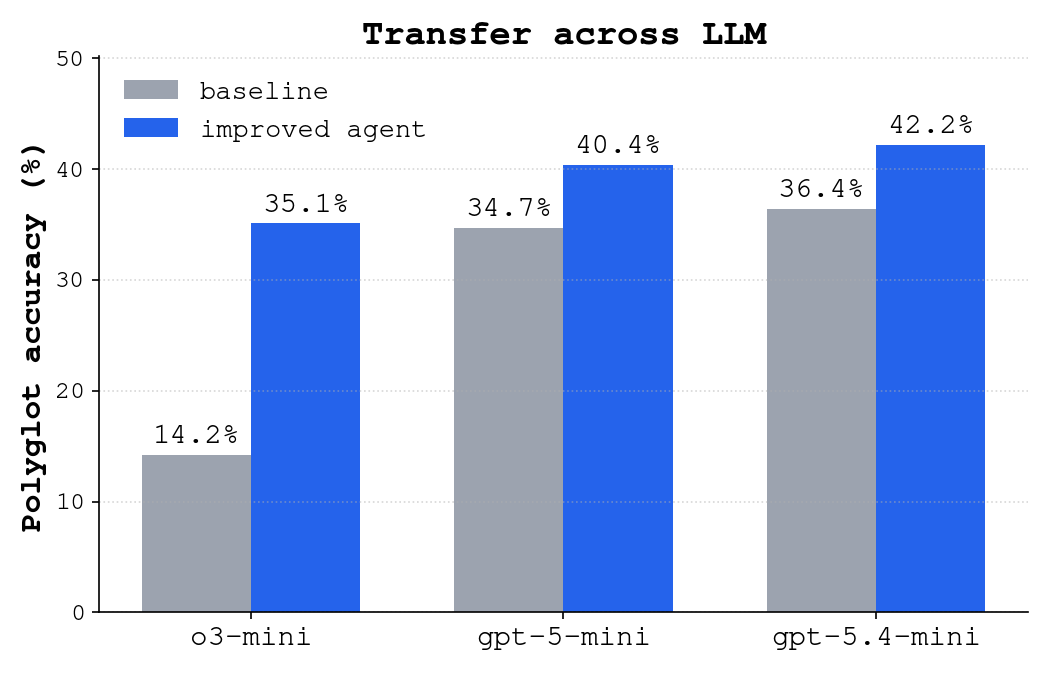
圖 4(原論文 Figure 4a,Section 4.1):以 o3-mini 找到的 harness 在其他 coding model 上重新評估,作者報告相對 base agent 的一致改善。原始圖檔:arXiv Figure 4a · Section 4 anchor。這是作者的 transfer experiment,不是獨立 replication;原圖頁面標示 CC BY 4.0。

作者也把 Qwen3-30B configuration 轉到其他 coding model。這個結果重要,因為如果 patch 只能幫助產生它的那一個 model,可能只是過度貼合 judge 或 coding backbone;跨模型 transfer 至少提供了「harness modification 可能帶有較一般的工程價值」的初步證據。但 transfer 的模型數量、任務分布與完整設定仍不足以建立普遍性。
實驗二:TerminalBench 說明 judge rank 不是 accuracy rank
TerminalBench 2.1 是長流程 terminal task;搜尋使用固定隨機抽出的 50-task subset,最後對挑出的 agent 做 89-task full evaluation,每個選擇重跑三次。結果如下:
| Selection | Search eval | Repeated full mean |
|---|---|---|
| Starting agent | 14/50 | 26.0/89(29.2%) |
| SIFT judge rank 1 | 18/50 | 32.7/89(36.7%) |
| SIFT accuracy rank 1 | 19/50 | 25.0/89(28.1%) |
| No-judge accuracy rank 1 | 19/50 | 26.0/89(29.2%) |
最值得注意的是,search subset 的最高分候選反而不是 full benchmark 的最佳候選;judge-selected node 在搜尋時只有 18/50,卻在重跑平均達 36.7%。這個結果支持 judge rank 作為「找出可能被 subset 噪聲掩蓋的 candidate」的訊號,而不是支持 judge 本身能取代實際執行。
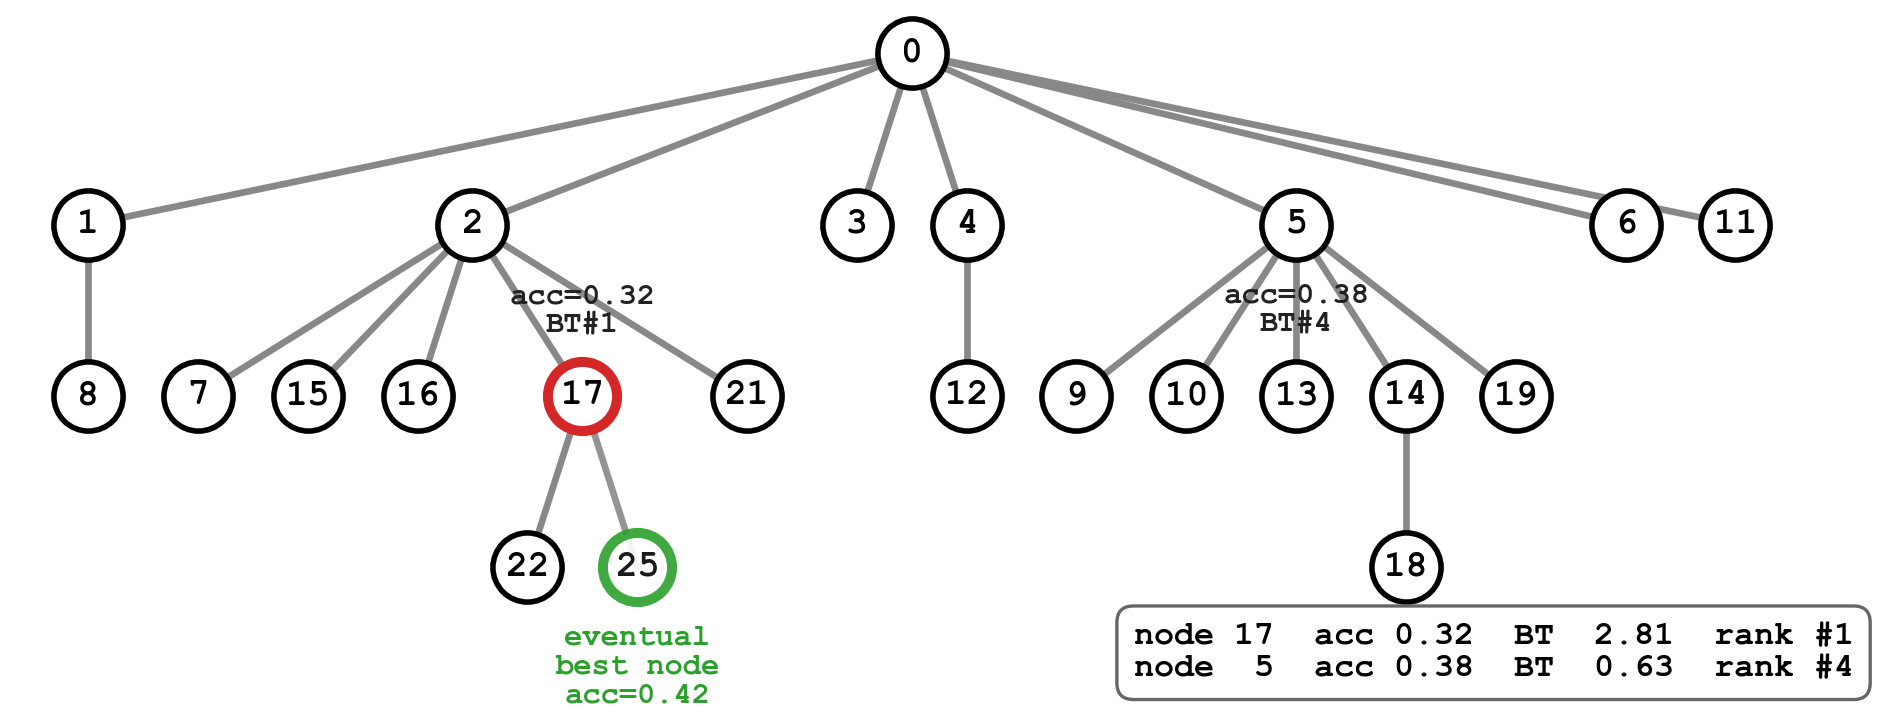
圖 5(原論文 Figure 5,Section 4.2):作者把完整評測的 nodes 依 BT judge rank 分組,對照 realized accuracy;圖中用來檢查 judge rank 是否對 full benchmark 有可用的排序訊號。原始圖檔:arXiv Figure 5 · Section 4.2 anchor。原圖為 CC BY 4.0;不可把相關性直接讀成因果保證。

Judge 強弱的取捨
gpt-5.4-high judge 的 best agent repeated mean 是 36.7%,BT rank 與 full score 的 Spearman ρ=0.72,top-5 recall 是 4/5;gpt-5 judge 仍達 34.5%、ρ=0.71,但 top-5 pairwise agreement 降到 0.50。這表示較弱 judge 可以把搜尋引向大致正確的區域,卻可能在 frontier 最後幾個候選的排序上犯錯。
因此 production 版本可以考慮 tiered design:廉價 judge 做大部分比較,強 judge 只重新排序 frontier,再交給真實 benchmark 做最後確認。這是論文提出的合理延伸,不是作者已完成的 production recipe。
Judge 看到什麼,會直接改變排序品質
論文比較四種 candidate representation:只給 diff、diff 加 swap-order、完整 files、完整 files 加 swap-order。50 個 non-root nodes 的結果顯示:
| Judge input | Spearman ρ | 每次比較成本 |
|---|---|---|
| Diffs | 0.40 | $0.0076 |
| Diffs + swap-order | 0.43 | $0.014 |
| Full files | 0.68 | $0.011 |
| Full files + swap-order | 0.67 | $0.021 |
這裡有一個很有工程價值的反直覺結果:full files 雖然比 diff 多帶 context,成本仍低於 swap-order 的 full files,且排序相關性最高。作者因此採用 full-file comparison without swap。比較合理的解釋是,judge 從完整 runtime implementation 直接看最後行為,比從一串 patch 自己重建行為更穩定。
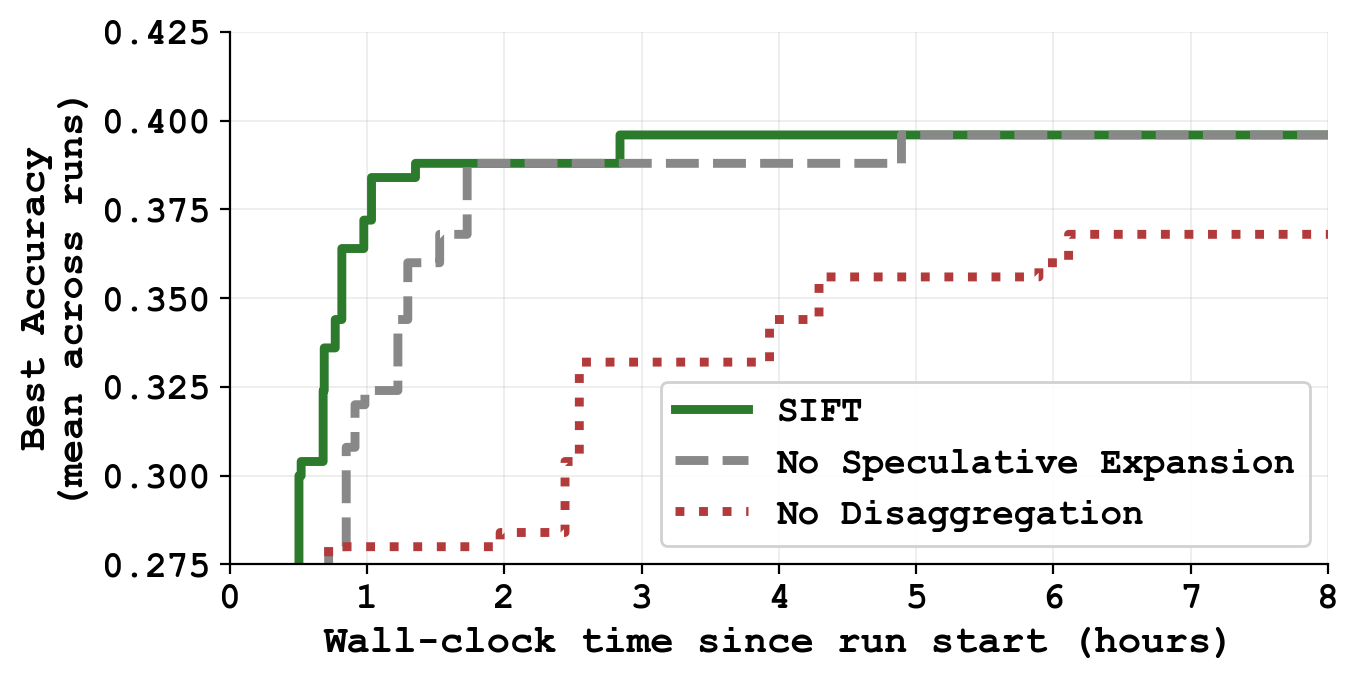
圖 6(原論文 Figure 6,Section 4.3):五次 run 的平均結果,用來拆解 disaggregation 與 speculative judge-guided expansion 的速度貢獻。原始圖檔:arXiv Figure 6 · Section 4.3 anchor。圖表是作者實驗結果,原頁面標示 CC BY 4.0;本文不把速度圖轉成普遍的 latency 保證。

SWE-60:重跑揭示「一次 search score」很不穩
在 SWE-60 appendix experiment 中,起始 agent 單次完整評測是 40.0%。SIFT judge rank 1 的 node 16,search score 是 53.3%,四次 full-60 分數平均 50.4%;judge rank 2 的 node 12 平均 53.8%。no-judge accuracy rank 1 的 node 11,search score 51.7%,重跑平均卻只有 44.6%。
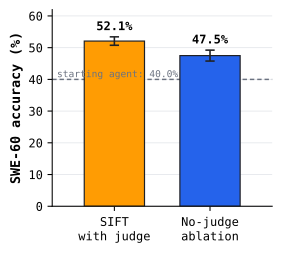
圖 7(原論文 Appendix A Figure 8,SWE-60 experiments):聚合重跑的平均分與誤差,展示 judge-guided selection 在這個小型設定中比只取 search accuracy 有較好的穩定性。原始圖檔:arXiv figure asset · Appendix A anchor。原圖頁面標示 CC BY 4.0;樣本仍是 SWE-60 子集,不代表 SWE-bench 全量結果。

SWE-60 的 qualitative lineage 也讓抽象的 judge preference 變得具體:一條被選中的 lineage 先替 git_patch tool 加入 LLM-style wrapper,後續節點再加入 malformed patch recovery,以及 full-file/add-file wrapper。judge 偏好較保守、能避免 silently placing an edit incorrectly 的 node。這不是證明 judge 了解所有程式語意,但它顯示 static code review 有時能捕捉到「單次 benchmark 分數尚未暴露」的 runtime risk。
安全與 evaluation integrity:自我修改的邊界不能省
論文在 Polyglot 實驗中觀察到 diagnosis agent 偶爾提出放寬 timeout 或 retry count 的 patch。這類 patch 若被允許,Agent 可以透過修改評測環境來取得虛假的 improvement。作者採用三個最低限度的控制:
- 在 sandboxed Docker container 中執行候選。
- 只允許修改明確的 runtime files,拒絕 touching benchmark 或 harness code。
- 把 patch、judge decision 與 downstream evaluation 分開,不能讓 judge rank 單獨成為採用條件。
這是本文把 SIFT 解讀成工程系統而非單一演算法的地方:搜尋效率是好處,但可修改的檔案範圍與 evaluation provenance 才是能不能安全使用的前提。
主要限制:28/30 不是 30/30 的原因
- 尚未確認公開實作:論文描述了方法、prompt 變體、成本與圖表,但截至查核日沒有可供外部直接重跑的正式 repository。
- 強 judge 大於 coding backbone:最強結果用 gpt-5.4 judge 配較弱 coding model;這是實用配置,卻不是完全由 agent 自己判斷自己的改進。
- single latent strength 的假設:BT 把候選壓成一個 scalar rank。某 patch 可能改善 long-horizon debugging,卻傷害 syntax repair;單一 rank 會把這種 trade-off 藏起來。
- benchmark 範圍有限:核心結果集中在 Polyglot、TerminalBench 與 SWE-60 類 coding-agent 設定,不足以推論到 research agent、browser agent 或多工具 enterprise workflow。
- 獨立重跑不足:多次 run、cross-model transfer 與 full evaluation 是作者內部證據,不等同於跨團隊 replication;API model version 與 task availability 也會影響 cost/score。
Bloss0m 工程判斷與不適用條件
SIFT 適合候選很多、完整評測昂貴,而且你能固定 subset、保存每次 runtime snapshot 的搜尋空間。若任務是高風險、候選數很少,或沒有能力保存 benchmark trace、sandbox 與 allow-list,就不應把 judge rank 放進自動採用流程。尤其不要在只有 judge preference、沒有 full verification 的情況下,直接把自我修改推到 production。
證據地圖:論文直接支持、作者主張與工程推論
- 論文直接支持:Polyglot、TerminalBench 與 SWE-60 的設定、比較表、成本、重跑與 input-format ablation。
- 作者主張:BT-guided asynchronous search 能以較少資源找到較強、可 transfer 的 coding-agent harness。
- 本文工程推論:production 應把 judge rank 當 speculative signal,並以 versioned snapshot、sandbox、full benchmark 與 human approval 組成 adoption gate;這不是論文已驗證的部署保證。
對 Agent 平台的工程轉譯
若要把 SIFT 的想法放進實際平台,我會把它落成五個明確的 contract:
| Contract | 必須留下的 artifact | 失敗時的處置 |
|---|---|---|
| Candidate patch | parent commit、完整 changed files、依賴與版本 | 不可定位 parent 就拒絕進 archive |
| Judge comparison | input snapshot、model、prompt、pairwise outcome、rationale | 比較圖不連通時標記為 low confidence |
| Intermediate eval | 固定 subset、task version、timeout、trace | subset score 只能排序,不能直接 publish |
| Full verification | benchmark result、重跑、成本、環境 hash | variance 過大就回到 frontier review |
| Adoption | allow-list diff、human approval、production canary | 禁止從 benchmark 直接寫入 production |
這個 mapping 不是論文的新 theorem,而是從論文的安全討論與 evidence boundary 推導出的 implementer checklist。特別要保留「judge-only rank」與「full benchmark result」兩個不同欄位,避免 dashboard 把 speculative preference 顯示成已驗證品質。
三個記憶點
- SIFT 把排序放在驗證前面:pairwise judge 與 BT rank 用來決定先探索誰,不是用來取消 benchmark。
- 非同步 pipeline 才是成本故事的一半:judge signal 之所以有用,是因為它和 expansion、subset、full evaluation 可以並行。
- 最後的可靠性仍由邊界與重跑決定:strong judge、固定 subset、sandbox、allow-list 與 repeated full evaluation 缺一不可;沒有公開 implementation 時,28/30 的 reproducibility gap 必須保留。
原始來源
本文的 primary sources 是 arXiv abstract、arXiv HTML v1、arXiv PDF v1 與其 原始 figure assets。數字、圖表與限制均以 v1 為準;本文沒有宣稱已完成獨立重跑。